Multe echipe de marketing au intrat în 2026 într-un ritm periculos: cu AI se poate scrie mai repede, dar tot cu AI se poate publica prea mult și prea asemănător. Rezultatul nu este doar un site mai mare, ci uneori un site mai confuz. Mai multe pagini ajung să atace aceeași intenție de căutare, cu variații minore de formulare, iar echipa descoperă târziu că propriul conținut concurează intern. În SEO, fenomenul este numit frecvent „canibalizare”, chiar dacă Google nu îl tratează ca pe o etichetă oficială de penalizare. Problema practică există însă: prea multe URL-uri apropiate semantic pot dilua semnalele, pot complica alegerea unei pagini canonice și pot face mai greu de înțeles care pagină merită actualizată, consolidată sau păstrată.
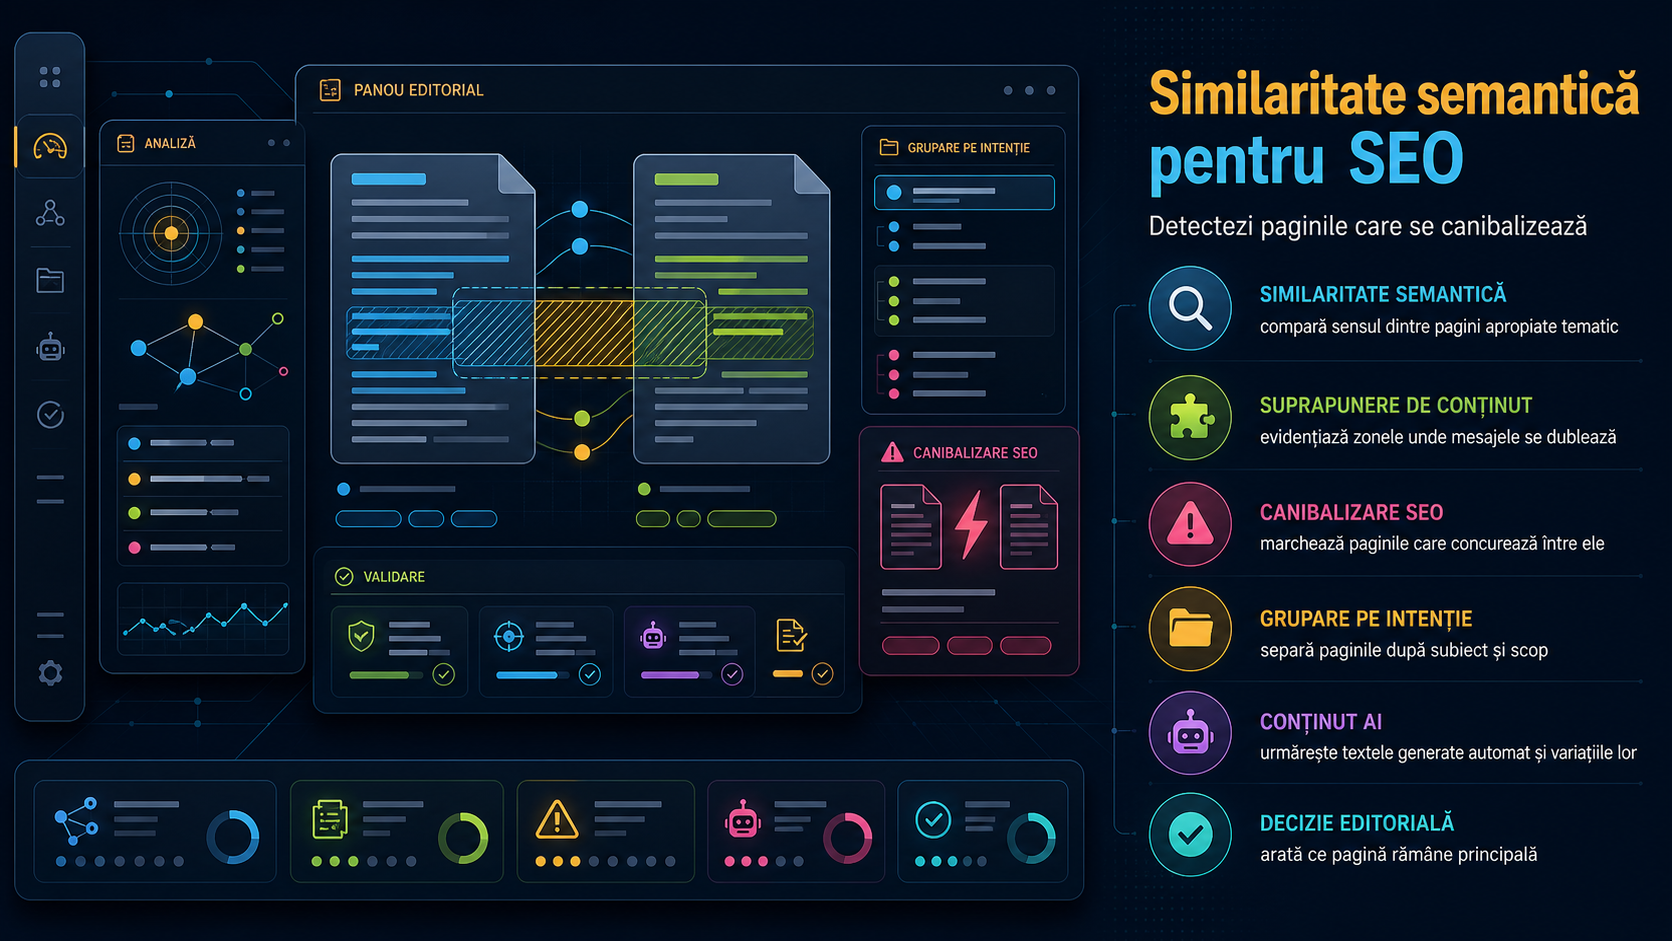
Aici devine utilă evaluarea prin semantic similarity. Pe scurt, transformi titlurile, H1-urile, introducerile sau chiar textul integral al paginilor în vectori numerici, apoi compari cât de apropiate sunt aceste reprezentări. Documentația OpenAI despre embeddings explică exact această idee: textul poate fi transformat în numere utile pentru search, clustering și compararea similarității. Pentru marketing, avantajul este clar. În loc să te bazezi doar pe instinct sau pe o căutare manuală în site, poți vedea rapid ce articole sunt aproape gemene ca subiect, chiar dacă nu folosesc aceleași cuvinte.
Important este să nu supraevaluezi metoda. Semantic similarity nu este un factor de ranking confirmat de Google și nici un verdict automat că două pagini trebuie șterse. Este un instrument intern de audit editorial. Google explică în documentația Search Central că, atunci când există conținut duplicat, sistemele sale aleg o adresă canonică. Tot Google recomandă conținut util, fiabil și creat pentru oameni, nu pagini produse doar pentru a acoperi artificial multe căutări. Cu alte cuvinte, similaritatea semantică nu îți spune ce va clasa Google mâine, dar te ajută să identifici un risc editorial real: publici multe pagini apropiate, fără diferențe clare de intenție, audiență sau valoare practică.
Cum folosești defensiv această evaluare într-o firmă? Începi simplu. Compari URL-urile din aceeași categorie, de exemplu paginile despre AI pentru email marketing, lead scoring, automatizări CRM sau conținut generat pentru campanii. Dacă două sau trei pagini ies foarte apropiate semantic, nu iei decizii automate. Le verifici manual după patru întrebări: răspund acele pagini la aceeași intenție? Au exemple diferite sau doar formulări diferite? Există o pagină mai puternică ce poate absorbi informația? Și există motive reale să păstrezi două URL-uri separate, cum ar fi publicuri diferite, etape diferite din funnel sau produse distincte?
În multe cazuri, rezultatul corect nu este ștergerea, ci consolidarea. Poți uni două articole slabe într-unul mai bun, poți actualiza linkurile interne, poți clarifica titlul și H2-urile sau poți seta o strategie canonică acolo unde ai versiuni apropiate. În alte cazuri, concluzia poate fi opusă: două pagini par asemănătoare la scor, dar una răspunde unei întrebări informaționale, iar cealaltă unei intenții comerciale. De aceea, pragul numeric trebuie tratat ca semnal de investigație, nu ca regulă rigidă.
Mai există un motiv pentru care firmele ar trebui să fie atente: confidențialitatea. Dacă folosești un furnizor extern de AI pentru a calcula embeddings sau pentru a analiza loturi de pagini, evită să trimiți date care nu sunt necesare. Pentru un audit SEO ai nevoie, de regulă, de textul public al paginilor, nu de date din CRM, note de vânzări sau informații despre clienți. Principiul de minimizare a datelor din GDPR rămâne relevant chiar și atunci când obiectivul pare banal, cum este curățarea unui blog.
Concluzia utilă pentru echipele de marketing este aceasta: semantic similarity merită folosită ca filtru editorial înainte de publicare și ca instrument de curățare după publicare. Nu înlocuiește strategia SEO, keyword research-ul sau analiza în Search Console, dar poate prinde repede ceea ce oamenii observă târziu: ai mai multe pagini „despre același lucru”, doar ambalate diferit. În epoca producției accelerate cu AI, câștigul real nu vine din mai multe articole, ci dintr-un portofoliu mai clar, mai distinct și mai ușor de susținut în căutare.