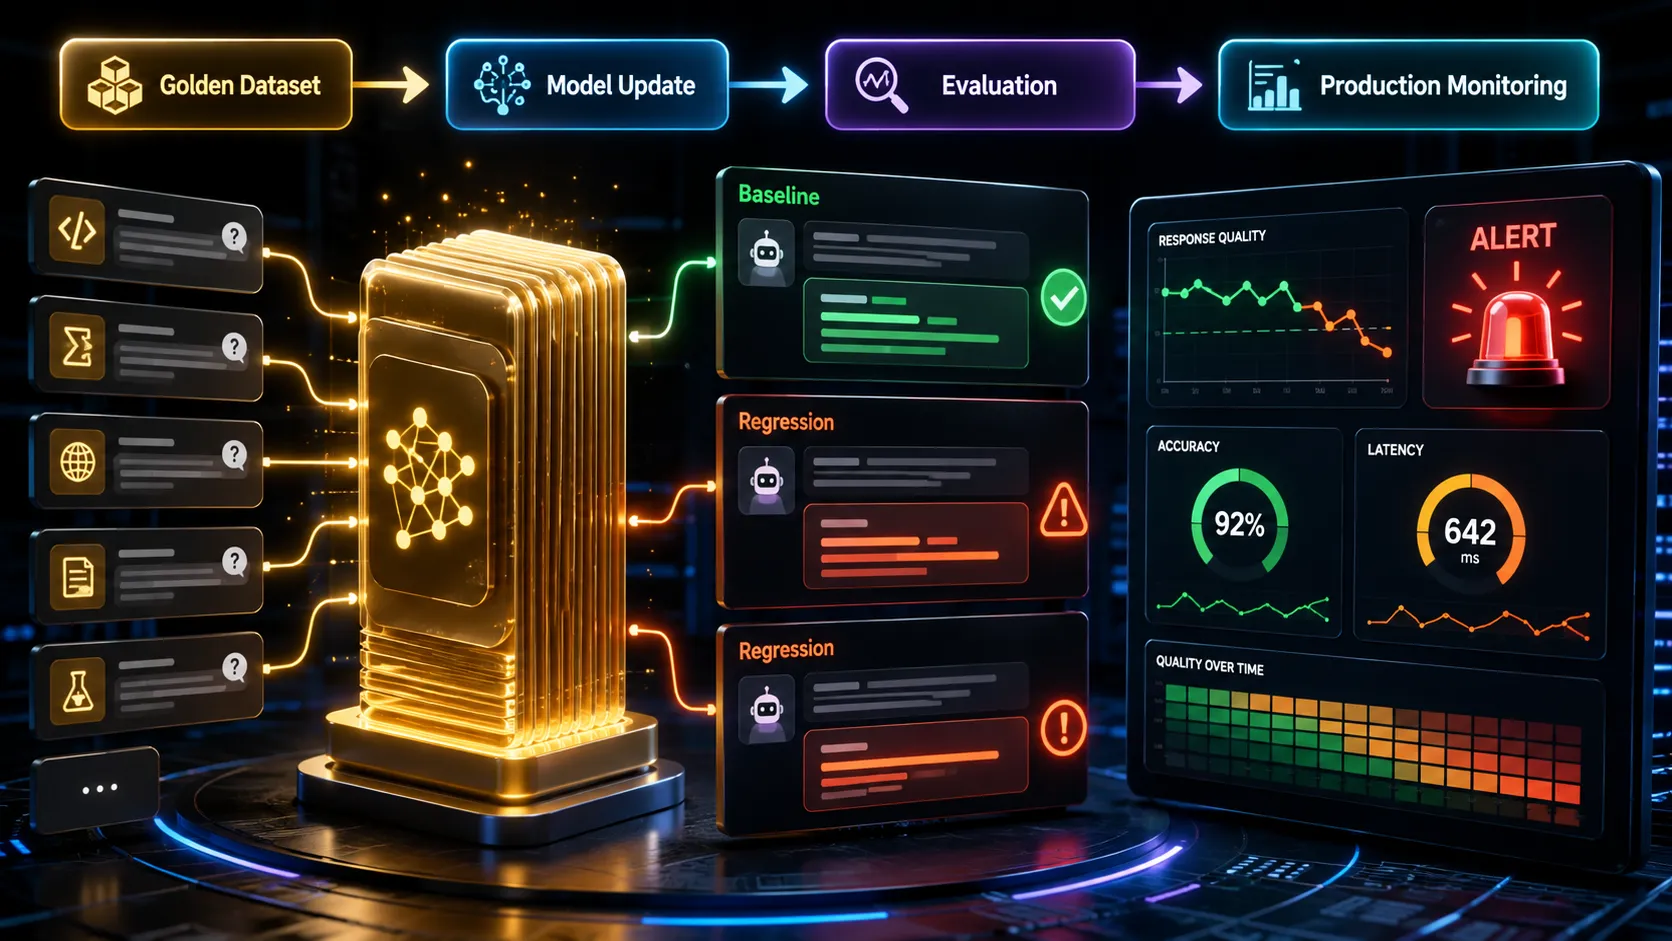
O aplicație AI poate părea stabilă în demonstrații și totuși să se degradeze după o modificare aparent minoră: schimbi modelul, promptul de sistem, strategia de retrieval, dimensiunea contextului sau un instrument disponibil agentului. Răspunsurile continuă să fie fluente, dar devin mai puțin corecte, omit informații obligatorii ori încep să inventeze detalii.
Un Golden Dataset este setul de cazuri folosit ca reper pentru detectarea acestor regresii. Nu este doar o colecție de întrebări și răspunsuri ideale. Este o suită versionată de scenarii, așteptări și reguli de evaluare care reprezintă comportamentul pe care aplicația trebuie să îl păstreze.
OpenAI recomandă evaluări specifice sarcinii, construite din exemple reale și cazuri-limită, rulate continuu după fiecare modificare importantă. LangSmith și MLflow tratează datasetul de evaluare ca bază pentru benchmarking, regression testing și compararea experimentelor.
Nu porni de la răspunsuri perfecte, ci de la comportamente obligatorii
Pentru fiecare caz, salvează inputul utilizatorului, contextul disponibil, instrumentele permise și rezultatul așteptat. Rezultatul nu trebuie să fie întotdeauna un text exact.
Într-o aplicație RAG, poți cere ca răspunsul să includă trei informații obligatorii, să nu folosească date din afara documentelor și să indice sursa corectă. Pentru un agent, poți verifica instrumentul selectat, argumentele trimise, ordinea acțiunilor și situațiile în care trebuie solicitată aprobarea utilizatorului.
O structură utilă pentru fiecare exemplu poate conține:
id: retur_014
input: "Pot returna produsul după 20 de zile?"
expected_facts:
  - "termenul standard este 14 zile"
required_behavior:
  - "explică excepțiile fără să promită aprobarea"
forbidden_claims:
  - "returul este garantat"
tags:
  - retur
  - limita
severity: critica
MLflow permite atașarea la exemple a unor așteptări precum fapte obligatorii, răspunsuri de referință și reguli de evaluare. LangSmith permite organizarea acelorași exemple în mai multe subseturi, astfel încât un caz să poată aparține simultan categoriilor „RAG”, „limba română” și „risc ridicat”.
Construiește datasetul din cinci surse diferite
Prima sursă este reprezentată de cerințele produsului: ce trebuie să facă aplicația și ce nu are voie să facă. A doua este formată din cazurile create manual de experții domeniului. A treia vine din conversațiile reale din producție, după eliminarea datelor personale. A patra include erorile deja descoperite, care trebuie transformate imediat în teste permanente. A cincea conține cazuri adverse: întrebări ambigue, instrucțiuni contradictorii, documente fără răspuns și tentative de a ocoli regulile.
Documentația LangSmith recomandă combinarea exemplelor curatoriate manual, a urmelor istorice din producție și a datelor sintetice. Datasetul nu trebuie să reflecte doar utilizatorul ideal, ci distribuția reală a solicitărilor.
Folosește mai multe tipuri de evaluatori
Nu evalua totul cu un singur „LLM judge”. Pentru formate, coduri, valori numerice, citări și apeluri de instrumente, folosește verificări deterministe. Sunt mai ieftine, reproductibile și ușor de depanat.
Pentru relevanță, claritate, corectitudine semantică sau respectarea unei rubrici, poți folosi un model evaluator. Definește însă criterii precise și exemple de răspunsuri acceptabile sau inacceptabile. OpenAI permite evaluatori bazați pe reguli, comparare de text, scoruri și modele folosite ca grader, iar Google Vertex AI oferă evaluări bazate pe criterii proprii și modele-judecător.
Cazurile critice trebuie revizuite periodic și de oameni. Un evaluator automat poate avea propriile erori, preferințe și inconsistențe.
Compară pe categorii, nu doar prin media globală
O medie de 92% poate ascunde o problemă gravă. Aplicația poate avea 98% pe întrebări generale și doar 60% pe rambursări, securitate sau limba română.
Stabilește praguri separate pentru fiecare categorie și severitate. De exemplu, poți accepta o scădere de două puncte la stil, dar nicio regresie la fapte obligatorii, siguranță sau selectarea instrumentelor.
Păstrează rezultatele unei versiuni aprobate ca baseline. Pentru fiecare modificare, rulează aceeași suită și compară scorurile, costul, latența și erorile individuale. LangSmith permite compararea mai multor experimente pe același dataset, iar MLflow poate transforma evaluatorii în teste care blochează pipeline-ul atunci când pragurile nu sunt atinse.
Introdu testarea în CI/CD, dar păstrează și evaluarea din producție
Rulează un subset rapid la fiecare pull request și întregul Golden Dataset înainte de release. Pentru modele cu răspunsuri variabile, execută cazurile importante de mai multe ori și urmărește rata de trecere, nu un singur rezultat norocos.
După lansare, colectează exemplele unde utilizatorii corectează răspunsul, abandonează conversația sau escaladează către un operator. Revizuiește-le și adaugă-le în dataset. Evaluarea offline detectează regresiile cunoscute; observabilitatea din producție descoperă cazurile pe care încă nu le-ai anticipat. LangSmith separă evaluarea offline pentru pre-deployment de monitorizarea online și detectarea anomaliilor, iar MLflow permite rularea automată a evaluatorilor pe urmele din producție.
Un Golden Dataset bun nu rămâne „golden” pentru totdeauna. Se actualizează controlat, cu versiuni, justificări și review. Scopul lui nu este să demonstreze că aplicația AI este perfectă, ci să facă degradarea vizibilă înainte să ajungă la utilizatori.
Surse folosite
OpenAI – Evaluation Best Practices și Graders
LangSmith – Evaluation, Evaluation Concepts și Regression Testing
MLflow – Evaluation Datasets, Regression Testing and CI/CD
Google Cloud – Vertex AI Generative AI Evaluation