Agent training cu GRPO nu înseamnă să înveți un model doar să „scrie mai bine”, ci să ia decizii mai bune într-un flux de lucru real. Ideea devine importantă atunci când vrei ca modelul să nu răspundă doar din textul memorat, ci să știe când să cheme un tool, cum să folosească rezultatul și cum să continue într-un environment care se schimbă de la un pas la altul.
GRPO vine de la Group Relative Policy Optimization. În lucrarea DeepSeekMath, autorii îl descriu ca pe o variantă de PPO gândită să îmbunătățească raționamentul și să optimizeze mai bine memoria în timpul antrenării. În practică, pentru un agent, ideea utilă este alta: generezi mai multe completări pentru aceeași sarcină, le evaluezi cu o funcție de reward și împingi modelul spre comportamentele care obțin scor mai bun, fără să-l lași să se îndepărteze necontrolat de politica de referință.
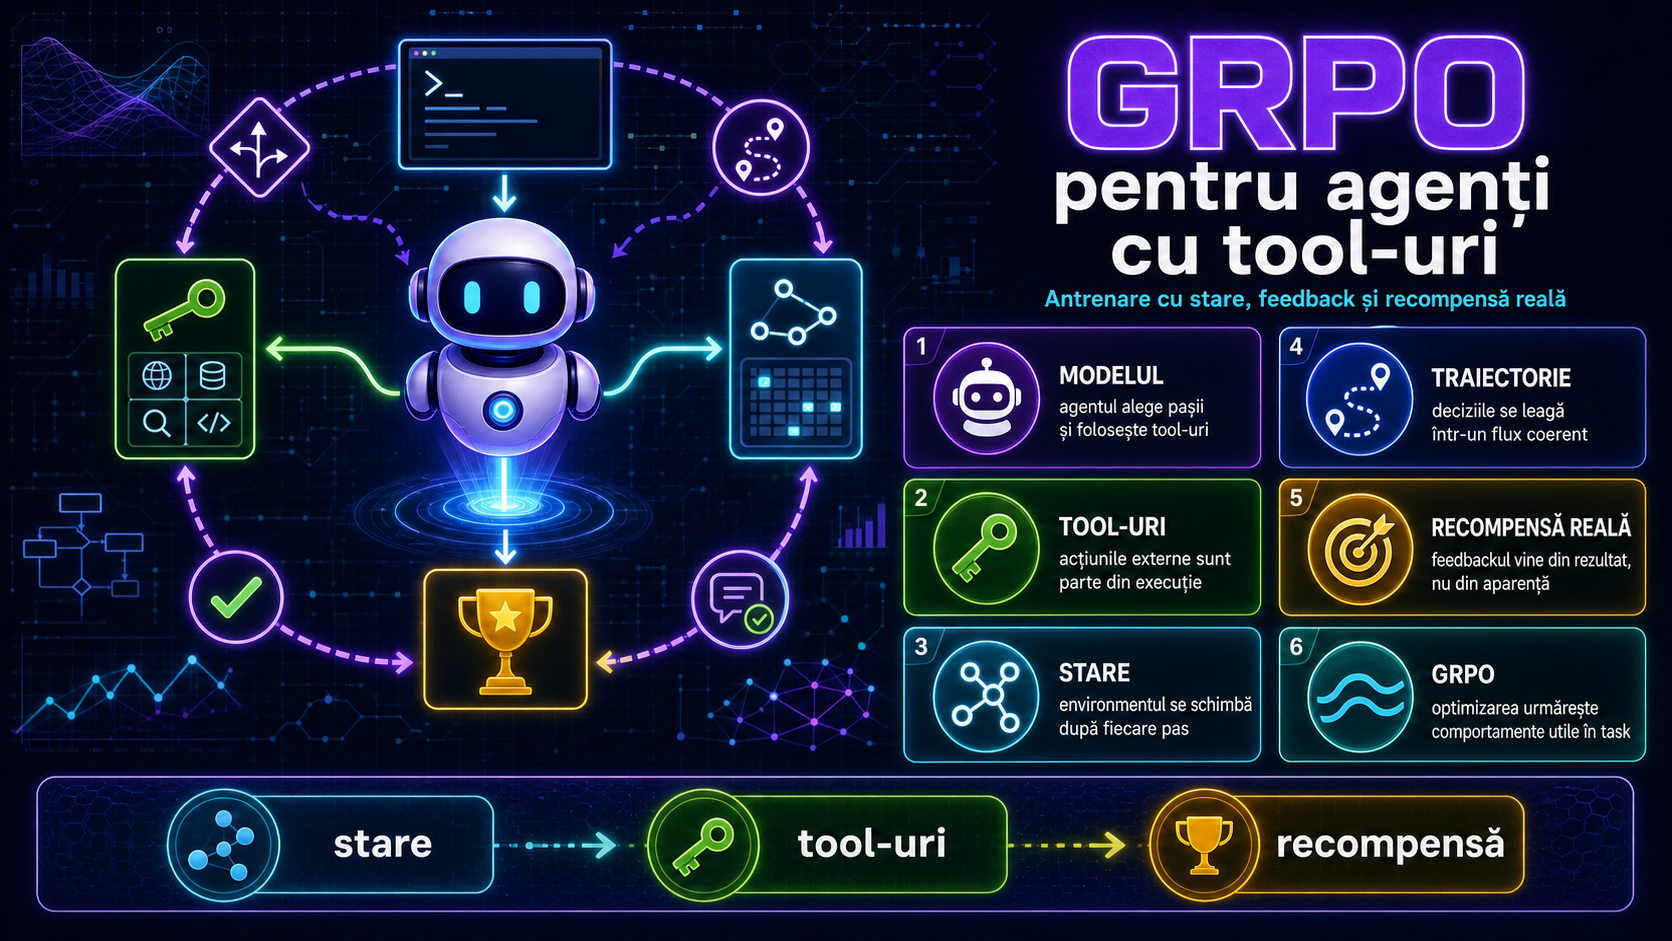
Ca să antrenezi un model să folosească tool-uri, primul pas nu este modelul, ci environment-ul. Hugging Face explică în documentația pentru Text Environments că un astfel de mediu permite unui model să folosească unelte pentru a rezolva sarcini, iar interacțiunea se desfășoară în mai multe ture. Pe scurt, modelul vede o stare, alege o acțiune, de exemplu un apel de tool, primește răspunsul tool-ului, apoi decide pasul următor. Asta este partea de „stateful”: contextul episodului se modifică după fiecare acțiune, nu rămâne un simplu prompt static.
Într-un setup serios, starea trebuie definită clar. Observația poate include cererea utilizatorului, istoricul apelurilor de tool, rezultatul ultimului pas și regulile taskului. Acțiunile pot fi de tipul „apelează căutarea”, „rulează calculatorul”, „citește un fișier”, „trimite răspunsul final”. Important este ca tool-urile să aibă intrări și ieșiri controlabile, nu zone ambigue în care modelul să pară că a reușit fără verificare.
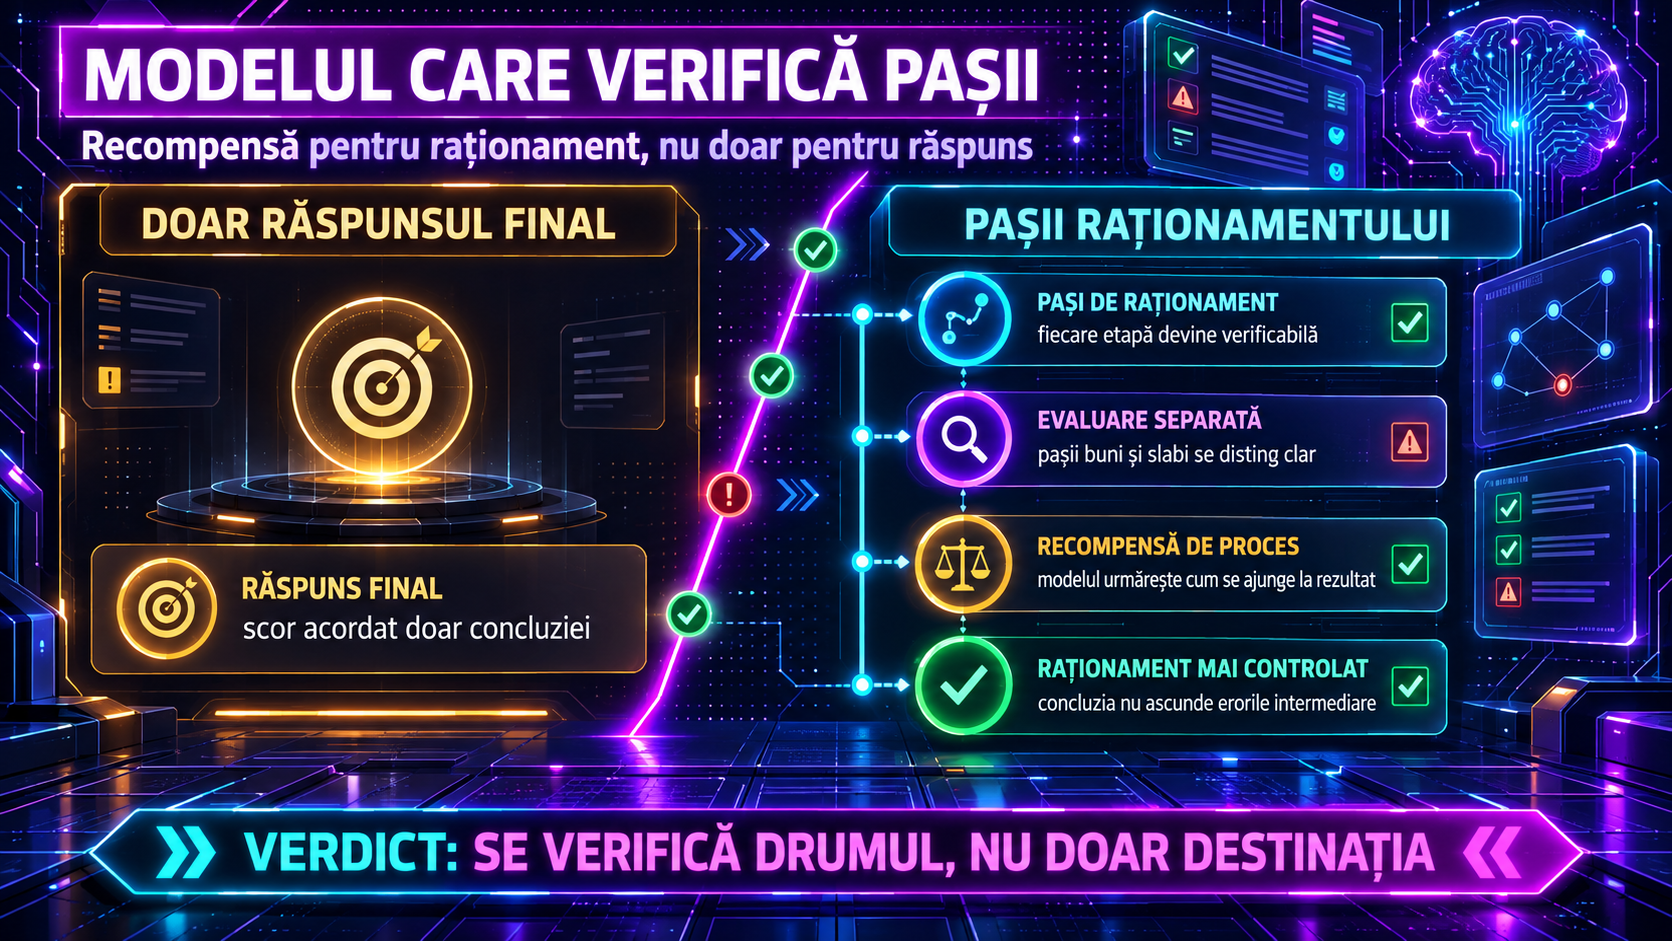
Apoi vine reward-ul, adică semnalul de care depinde tot antrenamentul. Aici se greșește des. Dacă dai reward doar pentru un răspuns fluent, modelul poate învăța să sune convingător, nu să rezolve corect taskul. Într-un environment cu tool-uri, reward-ul bun este legat de rezultat verificabil: răspuns final corect, format valid, tool ales corect, număr rezonabil de pași, penalizare pentru apeluri inutile sau eșuate. Documentația TRL arată și metrici utile pentru astfel de antrenamente, inclusiv frecvența apelurilor de tool și rata de eșec a lor. Asta contează fiindcă un agent nu devine bun doar dacă „folosește tool-uri”, ci dacă le folosește eficient.
Fluxul de lucru arată, de regulă, așa. Construiești un set de taskuri cu răspunsuri sau verificatori clari. Pentru fiecare task, lași modelul să producă mai multe încercări într-un episod complet, nu doar un singur răspuns final. Environment-ul execută tool-urile, actualizează starea și calculează reward-ul. GRPO compară încercările din același grup, normalizează avantajul relativ și actualizează modelul în direcția comportamentelor cu scor mai bun. Exact aici GRPO este mai potrivit decât un fine-tuning clasic: optimizezi comportamentul secvențial, nu doar următorul token în abstract.
Un exemplu bun de environment cu stare este BrowserGym, prezentat ca un mediu de tip gym pentru automatizare de taskuri web în Chromium. Ideea poate fi extinsă și la alți agenți: shell, căutare internă, RAG, baze de cunoștințe, validatoare sau teste automate. „Recompensă reală” înseamnă că scorul nu vine din impresii, ci dintr-un criteriu observabil: s-a găsit informația corectă, a trecut testul, s-a completat workflow-ul, s-a respectat schema.
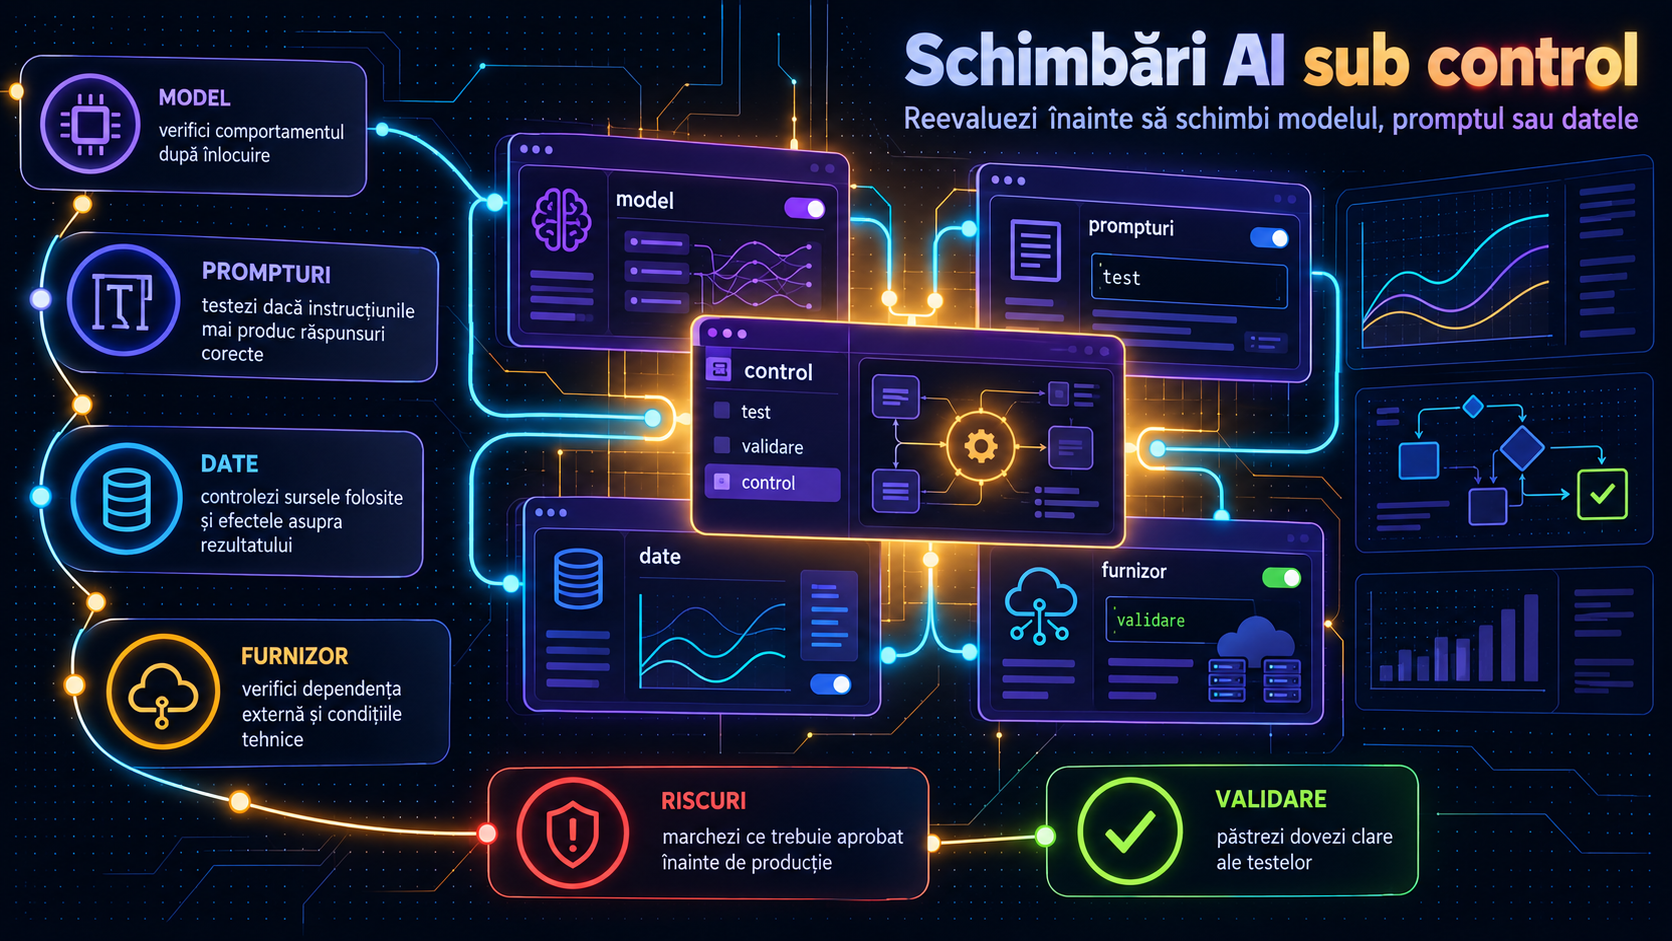
Ce nu face GRPO? Nu repară un environment prost proiectat. Nu rezolvă tool-uri lente, instabile sau nesigure. Nu transformă un evaluator slab într-un profesor bun. Și nu garantează generalizare dacă taskurile de antrenare sunt prea înguste. De aceea, după training, evaluarea separată rămâne obligatorie: taskuri nevăzute, tool-uri cu erori controlate, limite de pași, audit pe traseul deciziilor și verificarea cazurilor în care modelul halucinează în loc să cheme unealta potrivită.
Pentru echipele care construiesc agenți, concluzia este simplă: dacă vrei comportament robust într-un sistem real, nu antrenezi doar text, ci bucla completă dintre stare, acțiune, feedback și reward. Iar GRPO devine util exact în acest punct: când vrei ca modelul să învețe nu doar ce să spună, ci și ce să facă, când să folosească un tool și cum să ajungă la un rezultat verificabil.