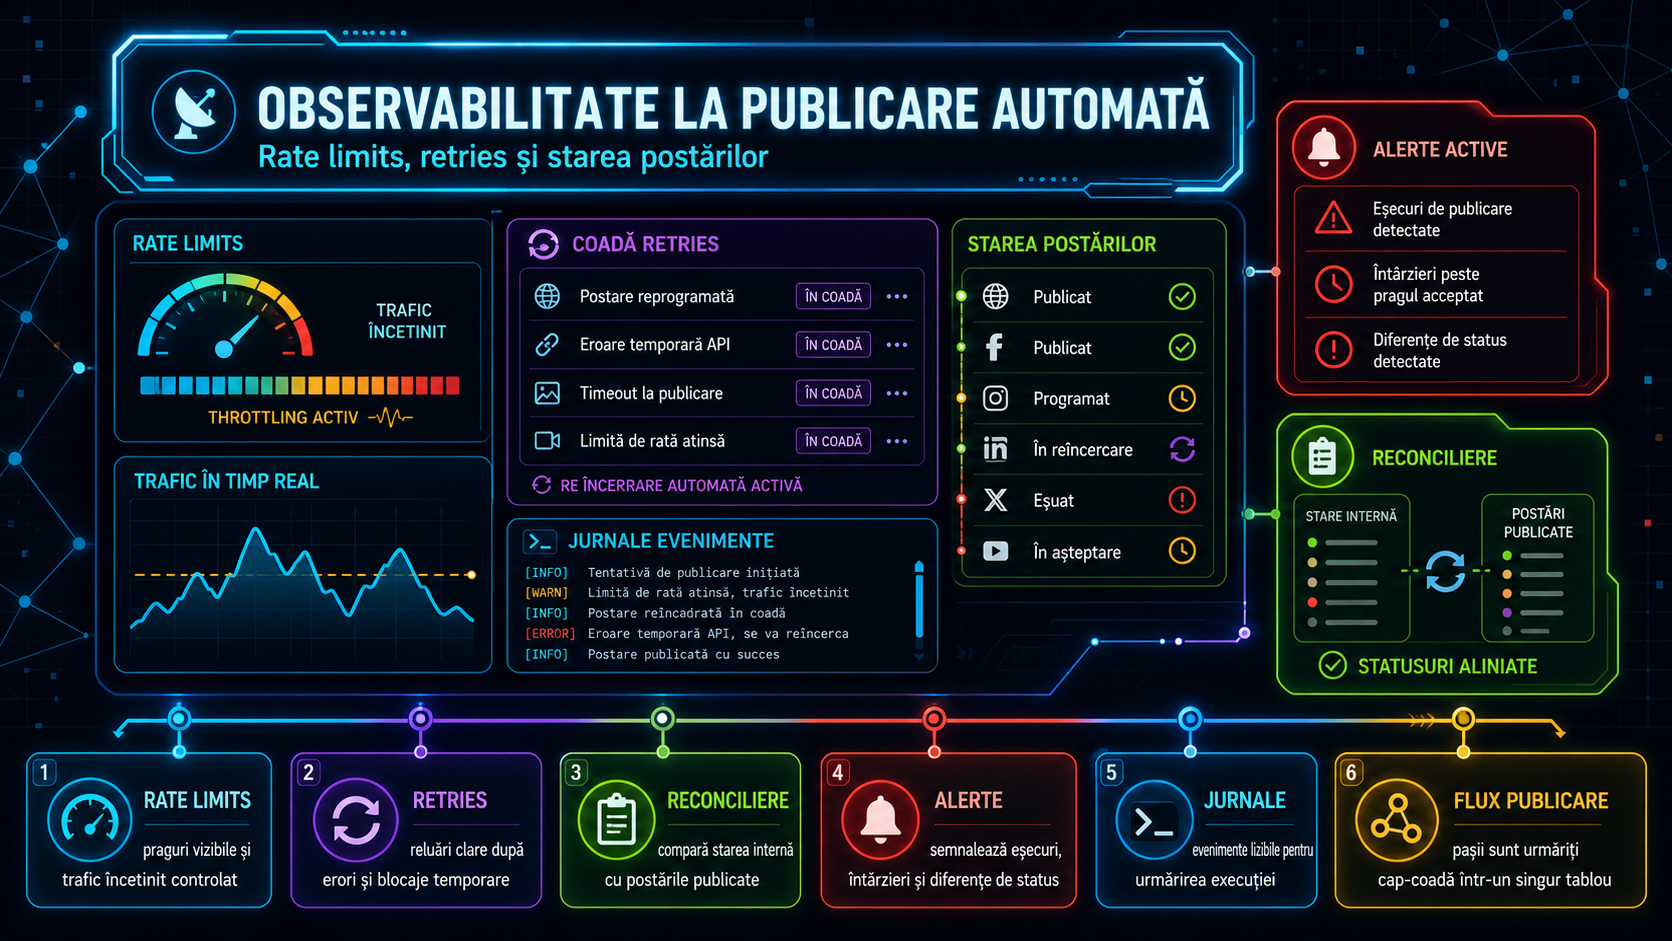
Automatizarea publicării în social media economisește timp, dar nu trebuie tratată ca un buton magic. Un răspuns „200 OK” sau un ID întors de API nu înseamnă întotdeauna că postarea este vizibilă, publicată corect sau sincronizată cu sistemul tău intern. Pentru echipe mici, cea mai sigură abordare este să trateze publicarea automată ca pe un proces observabil: măsori, verifici și reconciliezi, nu doar trimiți cererea și speri că totul a mers bine.
De ce apar probleme chiar și când automatizarea pare corectă
Platformele sociale impun limite de utilizare și reguli operaționale pentru stabilitate. LinkedIn explică explicit că toate cererile API sunt limitate și că depășirea limitelor duce la răspunsuri 429. X documentează rate limits per endpoint și expune în răspuns headere precum x-rate-limit-limit, x-rate-limit-remaining și x-rate-limit-reset. Meta arată că și Graph API aplică limitări, iar pentru anumite fluxuri oferă headere de utilizare precum X-App-Usage. Cu alte cuvinte, aceeași automatizare poate funcționa perfect dimineața și poate începe să eșueze mai târziu, fără ca logica ta de business să se fi schimbat.
Aici intervine observabilitatea. Dacă nu urmărești codurile de răspuns, headerele de limitare, ID-urile externe și starea finală a obiectului publicat, riști să ai două realități diferite: sistemul intern spune „publicat”, iar platforma spune „eșuat”, „în procesare” sau chiar „inexistent”.
Ce înseamnă rate limits, pe înțelesul tuturor
Rate limit înseamnă numărul maxim de cereri pe care îl poți trimite într-o anumită fereastră de timp. Nu este o eroare a platformei, ci un mecanism normal de protecție împotriva abuzului, suprasarcinii și traficului dezechilibrat.
Pentru o firmă mică, implicația practică este simplă: nu lansa toate postările programate în aceeași secundă și nu repeta aceeași cerere în buclă dacă apare o eroare. Meta recomandă explicit să oprești apelurile când limita a fost atinsă, să distribui traficul uniform și să verifici headerele de usage. Asta înseamnă că un sistem sănătos trebuie să știe când să încetinească, nu doar când să trimită.
Cum arată un retry corect și defensiv
Retries sunt utile doar pentru probleme tranzitorii: timeout, erori temporare de rețea, unele răspunsuri 429 sau 5xx. Un retry controlat nu înseamnă să retrimiți imediat aceeași cerere de zece ori. În practică, ai nevoie de trei reguli:
Prima: retrimite doar erorile care au șanse reale să se rezolve singure. O eroare de permisiuni, un token expirat sau un payload invalid nu se repară prin insistență.
A doua: aplică backoff. Dacă platforma oferă un moment de resetare sau indicii despre limită, respectă-le. Dacă nu, folosește întârzieri progresive și puține încercări, de exemplu 2–4, nu retry infinit.
A treia: fă retry idempotent. Păstrează un identificator intern al operațiunii și loghează fiecare încercare, ca să poți demonstra ulterior dacă ai trimis o singură intenție de publicare sau ai generat duplicate.
Cum faci reconcilierea stării postărilor
Reconcilierea înseamnă să compari periodic ce crede sistemul tău cu ce spune platforma. Nu marchezi o postare „publicată” doar pentru că ai primit confirmarea de acceptare a cererii. O marchezi „publicată” după ce ai verificat existența și starea obiectului extern.
Un exemplu clar vine din documentația Instagram Platform. Fluxul de publicare folosește un container media, apoi publicarea acelui container, iar Meta recomandă verificarea status_code pentru eligibilitate și status. De asemenea, există endpoint dedicat pentru content_publishing_limit. Asta arată de ce reconcilierea contează: între „am creat containerul” și „postarea există efectiv” pot exista întârzieri, limitări sau erori de procesare.
Operațional, păstrează pentru fiecare postare cel puțin aceste câmpuri: ID intern, platformă, endpoint folosit, timestamp, cod de răspuns, ID extern returnat, număr de retry-uri și stare finală verificată. Dacă sistemul tău are statusul „sent”, iar verificarea ulterioară nu găsește obiectul sau îl găsește în altă stare, marchezi incidentul pentru revizuire, nu îl ascunzi.
Bune practici pentru echipe mici
Setează alerte pentru creșteri de 429, 5xx și timeout-uri, nu doar pentru erori totale.
Separă stările în mod clar: queued, sending, accepted, published, failed, needs_review. „Accepted” nu este același lucru cu „published”.
Salvează headerele și identificatorii relevanți în loguri. La X, headerele de rate limiting sunt utile pentru decizii automate. La Meta, datele de usage și ID-urile obiectelor te ajută la diagnostic.
Rulează o verificare ulterioară după publicare, fie prin endpoint de citire, fie prin webhook, dacă platforma și integrarea ta permit asta.
Construiește un mecanism de reconciliere periodică pentru postările din ultimele 24 de ore, astfel încât diferențele să fie corectate înainte să observe clientul sau echipa de marketing.
Automatizarea matură nu înseamnă să postezi fără oameni, ci să poți demonstra ce s-a întâmplat, când s-a întâmplat și de ce. În social media, partea dificilă nu este doar trimiterea postării, ci verificarea faptului că platforma a acceptat-o, a procesat-o și o afișează așa cum te aștepți. Pentru orice business mic, aceasta este diferența dintre o integrare comodă și una de încredere.