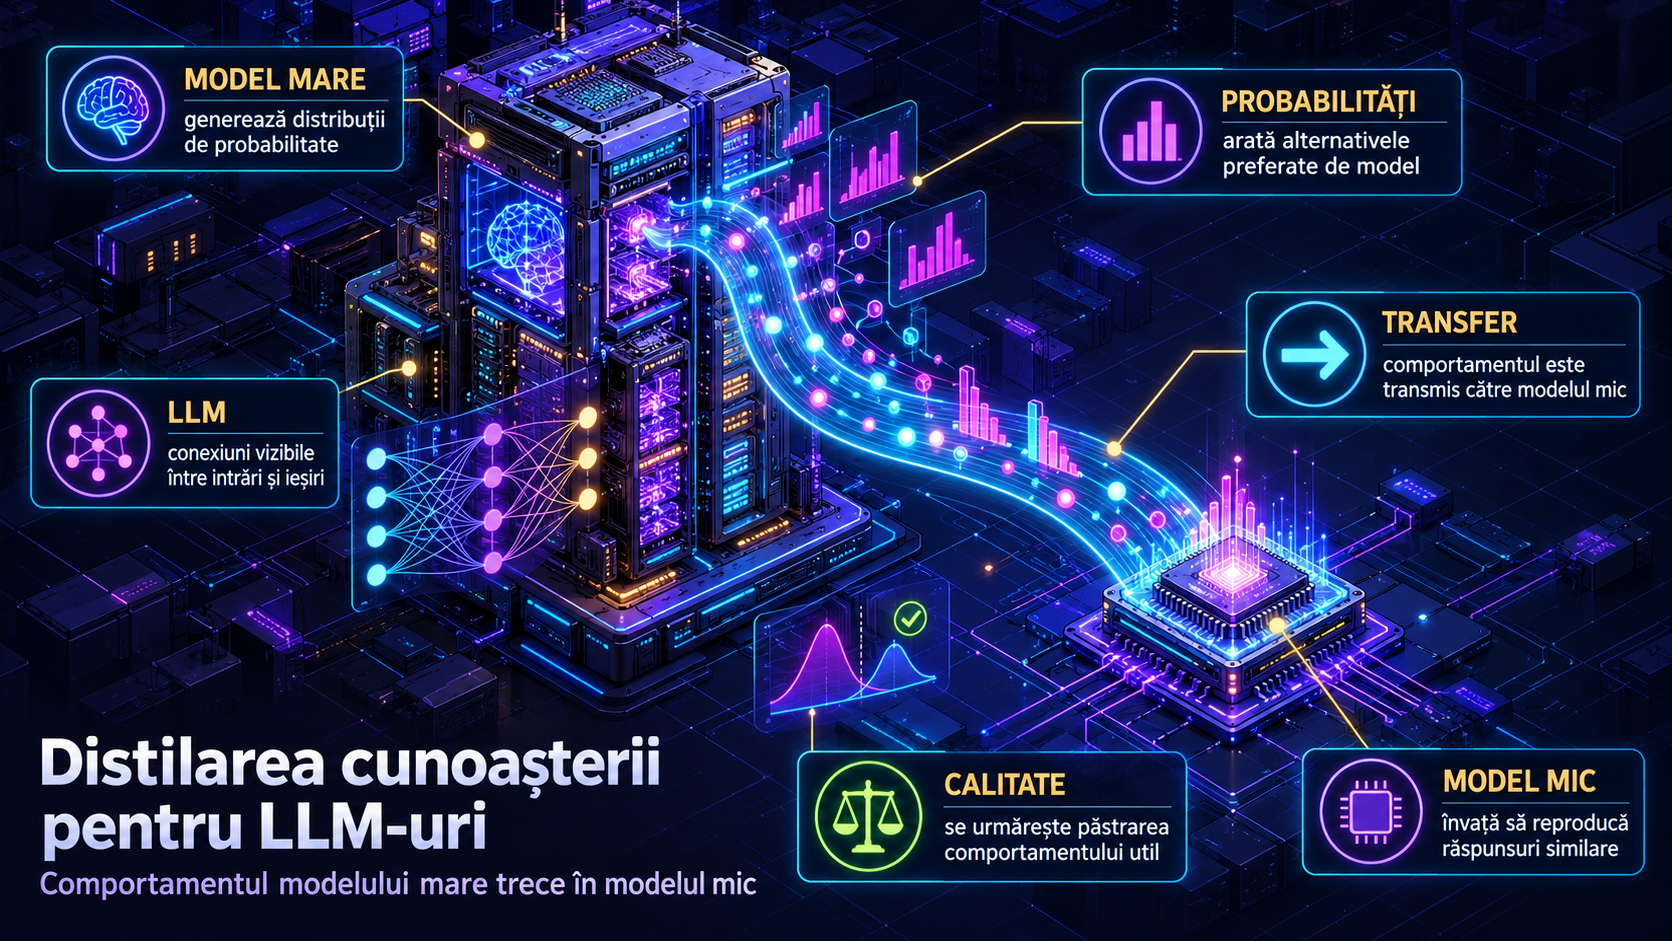
Knowledge Distillation transferă comportamentul unui model teacher mai mare către un model student mai mic. În loc să antrenăm studentul doar cu tokenul corect, îl facem să urmărească distribuția de probabilitate produsă de teacher: ce tokenuri consideră probabile, cât de sigur este și ce alternative păstrează.
În acest proiect construim un pipeline complet: date → tokenizare → distilare → evaluare → inferență. Folosim gpt2 ca teacher, distilgpt2 ca student, datasetul Salesforce/wikitext, configurația wikitext-2-raw-v1, KLDivLoss pentru distribuțiile teacher–student și cross_entropy pentru etichetele reale.
Dacă lucrezi deja cu antrenări mai mari, completează acest tutorial cu materialele despre topologia NCCL pentru NVLink, PCIe și rețea și TorchElastic pentru training distribuit. Aici rămânem la o singură rulare locală, reproductibilă.
Ce construim
Construim un director final numit distilled-wikitext2-student, care conține modelul student salvat după 200 de pași de distilare pe WikiText-2. La final, îl încărcăm local și generăm text cu generate.py.
Rezultatul verificabil este acesta: scriptul rulează fără traceback, afișează loss inițial și final, salvează fișierele modelului și produce o continuare pentru promptul Artificial intelligence systems can.
Mediul exact
Mediul folosit în tutorial:
- Ubuntu 22.04 LTS sau WSL2 Ubuntu 22.04;
- Python 3.11;
torch==2.14.1;transformers==5.19.0;datasets==5.1.0;accelerate==1.15.0;tqdm==4.70.1;- minimum 8 GB RAM;
- minimum 5 GB spațiu liber;
- GPU NVIDIA recomandat, dar CPU funcționează pentru testul scurt.
Verifică Python:
python3 --versionTrebuie să vezi ceva de forma:
Python 3.11.xCe instalezi
Creează directorul proiectului:
mkdir -p ~/kd-wikitext2
cd ~/kd-wikitext2
Trebuie să fii în directorul ~/kd-wikitext2.
Creează și activează mediul virtual:
python3.11 -m venv .venv
source .venv/bin/activate
Trebuie să vezi prefixul (.venv) în prompt.
Actualizează uneltele de instalare:
python -m pip install --upgrade pip setuptools wheelInstalează dependențele:
python -m pip install torch==2.14.1 transformers==5.19.0 datasets==5.1.0 accelerate==1.15.0 tqdm==4.70.1Verifică importurile:
python - <<'PY'
import torch
import transformers
import datasets
import accelerate
import tqdm

print("torch", torch.__version__)
print("transformers", transformers.__version__)
print("datasets", datasets.__version__)
print("accelerate", accelerate.__version__)
print("cuda_available", torch.cuda.is_available())
PY
Trebuie să vezi:
torch 2.14.1
transformers 5.19.0
datasets 5.1.0
accelerate 1.15.0
cuda_available True
sau cuda_available False, dacă rulezi pe CPU.
Pasul 1: creează scriptul de distilare
Creează fișierul:
nano distill_wikitext2.pyLipește codul complet:
import argparse
import math
import os
import random
from dataclasses import dataclass

import torch
import torch.nn.functional as F
from datasets import load_dataset
from torch.utils.data import DataLoader
from tqdm.auto import tqdm
from transformers import AutoModelForCausalLM, AutoTokenizer, get_linear_schedule_with_warmup


def parse_args():
    parser = argparse.ArgumentParser(description="Distilare Causal LM pe WikiText-2 cu KLDivLoss si CrossEntropyLoss")
    parser.add_argument("--teacher_model", default="gpt2")
    parser.add_argument("--student_model", default="distilgpt2")
    parser.add_argument("--dataset_name", default="Salesforce/wikitext")
    parser.add_argument("--dataset_config", default="wikitext-2-raw-v1")
    parser.add_argument("--output_dir", default="distilled-wikitext2-student")
    parser.add_argument("--block_size", type=int, default=128)
    parser.add_argument("--batch_size", type=int, default=2)
    parser.add_argument("--learning_rate", type=float, default=5e-5)
    parser.add_argument("--epochs", type=int, default=1)
    parser.add_argument("--max_train_steps", type=int, default=200)
    parser.add_argument("--temperature", type=float, default=2.0)
    parser.add_argument("--alpha", type=float, default=0.7)
    parser.add_argument("--seed", type=int, default=47)
    return parser.parse_args()


def set_seed(seed):
    random.seed(seed)
    torch.manual_seed(seed)
    torch.cuda.manual_seed_all(seed)


@dataclass
class CausalBatch:
    input_ids: torch.Tensor
    attention_mask: torch.Tensor


def tokenize_and_group(dataset, tokenizer, block_size):
    def tokenize(batch):
        texts = [text if text and not text.isspace() else tokenizer.eos_token for text in batch["text"]]
        return tokenizer(texts)

    tokenized = dataset.map(tokenize, batched=True, remove_columns=["text"])

    def group_texts(examples):
        concatenated = {key: sum(examples[key], []) for key in examples.keys()}
        total_length = len(concatenated["input_ids"])
        total_length = (total_length // block_size) * block_size
        result = {
            key: [values[i : i + block_size] for i in range(0, total_length, block_size)]
            for key, values in concatenated.items()
        }
        return result

    grouped = tokenized.map(group_texts, batched=True)
    grouped.set_format(type="torch", columns=["input_ids", "attention_mask"])
    return grouped


def collate_fn(features):
    return CausalBatch(
        input_ids=torch.stack([feature["input_ids"] for feature in features]),
        attention_mask=torch.stack([feature["attention_mask"] for feature in features]),
    )


def distillation_loss(student_logits, teacher_logits, labels, attention_mask, temperature, alpha):
    shifted_student = student_logits[:, :-1, :].contiguous()
    shifted_teacher = teacher_logits[:, :-1, :].contiguous()
    shifted_labels = labels[:, 1:].contiguous()
    shifted_mask = attention_mask[:, 1:].contiguous().bool()

    active_student = shifted_student[shifted_mask]
    active_teacher = shifted_teacher[shifted_mask]
    active_labels = shifted_labels[shifted_mask]

    student_log_probs = F.log_softmax(active_student / temperature, dim=-1)
    teacher_probs = F.softmax(active_teacher / temperature, dim=-1)

    kd_loss = F.kl_div(student_log_probs, teacher_probs, reduction="batchmean") * (temperature ** 2)
    ce_loss = F.cross_entropy(active_student, active_labels)
    total_loss = alpha * kd_loss + (1.0 - alpha) * ce_loss

    return total_loss, kd_loss.detach(), ce_loss.detach()


@torch.no_grad()
def evaluate(model, dataloader, device):
    model.eval()
    losses = []

    for batch in dataloader:
        input_ids = batch.input_ids.to(device)
        attention_mask = batch.attention_mask.to(device)
        outputs = model(input_ids=input_ids, attention_mask=attention_mask, labels=input_ids)
        losses.append(outputs.loss.detach().float().cpu())

    mean_loss = torch.stack(losses).mean().item()
    perplexity = math.exp(mean_loss) if mean_loss < 20 else float("inf")
    model.train()
    return mean_loss, perplexity


def main():
    args = parse_args()

    if not 0.0 <= args.alpha <= 1.0:
        raise ValueError("--alpha trebuie sa fie intre 0.0 si 1.0")

    set_seed(args.seed)

    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    print(f"Device: {device}")
    print(f"Teacher: {args.teacher_model} | Student: {args.student_model}")

    tokenizer = AutoTokenizer.from_pretrained(args.teacher_model)
    if tokenizer.pad_token is None:
        tokenizer.pad_token = tokenizer.eos_token

    dataset = load_dataset(args.dataset_name, args.dataset_config)
    grouped = tokenize_and_group(dataset, tokenizer, args.block_size)

    train_loader = DataLoader(grouped["train"], batch_size=args.batch_size, shuffle=True, collate_fn=collate_fn)
    valid_loader = DataLoader(grouped["validation"], batch_size=args.batch_size, shuffle=False, collate_fn=collate_fn)

    teacher = AutoModelForCausalLM.from_pretrained(args.teacher_model).to(device)
    student = AutoModelForCausalLM.from_pretrained(args.student_model).to(device)

    teacher.eval()
    student.train()

    optimizer = torch.optim.AdamW(student.parameters(), lr=args.learning_rate)
    total_steps = min(args.max_train_steps, args.epochs * len(train_loader))
    scheduler = get_linear_schedule_with_warmup(optimizer, num_warmup_steps=0, num_training_steps=total_steps)

    initial_loss, initial_ppl = evaluate(student, valid_loader, device)
    print(f"Eval initial student: loss={initial_loss:.4f}, perplexity={initial_ppl:.2f}")

    progress = tqdm(total=total_steps, desc="distilare")
    completed_steps = 0

    for epoch in range(args.epochs):
        for batch in train_loader:
            input_ids = batch.input_ids.to(device)
            attention_mask = batch.attention_mask.to(device)

            with torch.no_grad():
                teacher_outputs = teacher(input_ids=input_ids, attention_mask=attention_mask)

            student_outputs = student(input_ids=input_ids, attention_mask=attention_mask)

            loss, kd_loss, ce_loss = distillation_loss(
                student_outputs.logits,
                teacher_outputs.logits,
                input_ids,
                attention_mask,
                args.temperature,
                args.alpha,
            )

            loss.backward()
            torch.nn.utils.clip_grad_norm_(student.parameters(), max_norm=1.0)
            optimizer.step()
            scheduler.step()
            optimizer.zero_grad(set_to_none=True)

            completed_steps += 1
            progress.update(1)
            progress.set_postfix(loss=f"{loss.item():.4f}", kd=f"{kd_loss.item():.4f}", ce=f"{ce_loss.item():.4f}")

            if completed_steps >= total_steps:
                break

        if completed_steps >= total_steps:
            break

    progress.close()

    final_loss, final_ppl = evaluate(student, valid_loader, device)
    print(f"Eval final student: loss={final_loss:.4f}, perplexity={final_ppl:.2f}")

    os.makedirs(args.output_dir, exist_ok=True)
    student.save_pretrained(args.output_dir)
    tokenizer.save_pretrained(args.output_dir)
    print(f"Model salvat in: {args.output_dir}")


if __name__ == "__main__":
    main()
Salvează fișierul. Verifică sintaxa:
python -m py_compile distill_wikitext2.pyTrebuie să nu apară nicio eroare.
Pasul 2: rulează un smoke test
Prima rulare descarcă datasetul și modelele. Testul scurt verifică doar pipeline-ul:
python distill_wikitext2.py --max_train_steps 2 --batch_size 1 --block_size 64 --output_dir smoke-studentTrebuie să vezi linii de forma:
Device: cuda
Teacher: gpt2 | Student: distilgpt2
Eval initial student: loss=..., perplexity=...
distilare: 100%|...| 2/2 ...
Eval final student: loss=..., perplexity=...
Model salvat in: smoke-student
Dacă apare Device: cpu, comanda este tot corectă, dar va rula mai lent.
Verifică directorul:
ls -1 smoke-studentTrebuie să vezi fișiere precum:
config.json
generation_config.json
merges.txt
model.safetensors
special_tokens_map.json
tokenizer.json
tokenizer_config.json
vocab.json
Lista poate varia ușor după formatul de salvare, dar trebuie să existe configurația, tokenizerul și greutățile modelului.
Pasul 3: rulează distilarea de 200 de pași
Rulează distilarea finală:
python distill_wikitext2.py --max_train_steps 200 --batch_size 2 --block_size 128 --temperature 2.0 --alpha 0.7 --learning_rate 5e-5 --output_dir distilled-wikitext2-studentTrebuie să vezi valori finite pentru loss, kd și ce, nu nan sau inf.
La final trebuie să vezi:
Eval final student: loss=..., perplexity=...
Model salvat in: distilled-wikitext2-student
În acest tutorial, alpha=0.7 înseamnă că pierderea KL are pondere mai mare decât cross-entropy. Pentru comparație, în preference learning, obiectivul este diferit: un evaluator învață alegeri chosen–rejected, ca în articolul despre Reward Model pentru preference learning. Aici nu antrenăm un reward model și nu facem RL.
Pasul 4: verifică modelul prin inferență
Creează fișierul:
nano generate.pyLipește codul:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model_dir = "distilled-wikitext2-student"
prompt = "Artificial intelligence systems can"

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
tokenizer = AutoTokenizer.from_pretrained(model_dir)
model = AutoModelForCausalLM.from_pretrained(model_dir).to(device)
model.eval()

inputs = tokenizer(prompt, return_tensors="pt").to(device)

with torch.no_grad():
    output_ids = model.generate(
        **inputs,
        max_new_tokens=40,
        do_sample=False,
        pad_token_id=tokenizer.eos_token_id,
    )

print(tokenizer.decode(output_ids[0], skip_special_tokens=True))
Rulează:
python generate.pyTrebuie să vezi un text care începe cu:
Artificial intelligence systems canContinuarea poate fi slabă după numai 200 de pași. Obiectivul este să verifici mecanismul de distilare și artefactul salvat, nu să obții un LLM de producție.
Verificarea finală
Rulează verificările:
python -m py_compile distill_wikitext2.py generate.py
test -d distilled-wikitext2-student && echo "model salvat"
ls distilled-wikitext2-student | grep -E 'model|pytorch'
python generate.py
Trebuie să vezi:
model salvat
model.safetensors
Artificial intelligence systems can...
Dacă folosești rulări multi-GPU sau secvențe lungi, intri într-o zonă diferită de optimizare, unde devin relevante tehnici precum Context Parallel și Ring Attention. Pentru tutorialul de aici, un singur proces este suficient.
Probleme frecvente
ModuleNotFoundError: No module named 'transformers'
Cauză: mediul virtual nu este activ sau dependențele au fost instalate în alt Python.
Rezolvare:
source .venv/bin/activate
python -m pip install torch==2.14.1 transformers==5.19.0 datasets==5.1.0 accelerate==1.15.0 tqdm==4.70.1
OSError: We couldn't connect to 'https://huggingface.co'
Cauză: sistemul nu poate accesa Hugging Face Hub.
Rezolvare: verifică rețeaua, DNS-ul sau proxy-ul organizației și rulează din nou. Pentru reproductibilitate, folosește pagina oficială Hugging Face Hub, nu oglinzi neoficiale.
RuntimeError: CUDA out of memory
Cauză: GPU-ul nu are memorie suficientă pentru batch și secvență.
Rezolvare:
python distill_wikitext2.py --max_train_steps 200 --batch_size 1 --block_size 64 --temperature 2.0 --alpha 0.7 --output_dir distilled-wikitext2-studentValueError: --alpha trebuie sa fie intre 0.0 si 1.0
Cauză: valoarea pentru --alpha este invalidă.
Rezolvare:
python distill_wikitext2.py --alpha 0.7loss=nan
Cauză: antrenarea a devenit instabilă, de obicei după modificarea ratei de învățare sau a temperaturii.
Rezolvare:
python distill_wikitext2.py --learning_rate 5e-5 --temperature 2.0 --alpha 0.7 --batch_size 2 --block_size 128Revenire și curățenie
Șterge artefactul de test:
rm -rf smoke-studentȘterge modelul final doar dacă nu mai ai nevoie de el:
rm -rf distilled-wikitext2-studentȘterge cache-ul Hugging Face doar dacă accepți să redescarci datasetul și modelele:
rm -rf ~/.cache/huggingfaceDezactivează mediul virtual:
deactivateTrebuie să dispară prefixul (.venv) din prompt.
Mai departe
După această variantă minimă, următorul pas realist este să mărești numărul de pași, să păstrezi loguri separate pentru loss-ul KL și cross-entropy și să evaluezi studentul pe seturi de test relevante pentru aplicația ta.
Nu folosi acest pipeline ca scurtătură pentru a copia modele fără respectarea licențelor. Teacher-ul, studentul, datasetul și destinația modelului trebuie verificate înainte de orice utilizare comercială sau publică.
Întrebări frecvente
De ce folosim KLDivLoss?
Folosim KLDivLoss pentru ca studentul să învețe distribuția de probabilitate produsă de teacher, nu doar tokenul corect. În cod, studentul intră prin log_softmax, iar teacher-ul prin softmax.
De ce păstrăm și cross-entropy?
Cross-entropy păstrează legătura cu tokenii reali din WikiText-2. Pierderea finală combină distilarea cu etichetele reale prin alpha.
Pot rula tutorialul fără GPU?
Da. Scriptul folosește CPU dacă PyTorch nu vede CUDA. Pentru test rapid pe CPU, rulează smoke testul cu --max_train_steps 2 --batch_size 1 --block_size 64.
Este modelul final gata de producție?
Nu. Directorul distilled-wikitext2-student este un artefact verificabil al tutorialului. Pentru producție sunt necesare mai multe date, evaluări, verificări de licență și teste de siguranță.