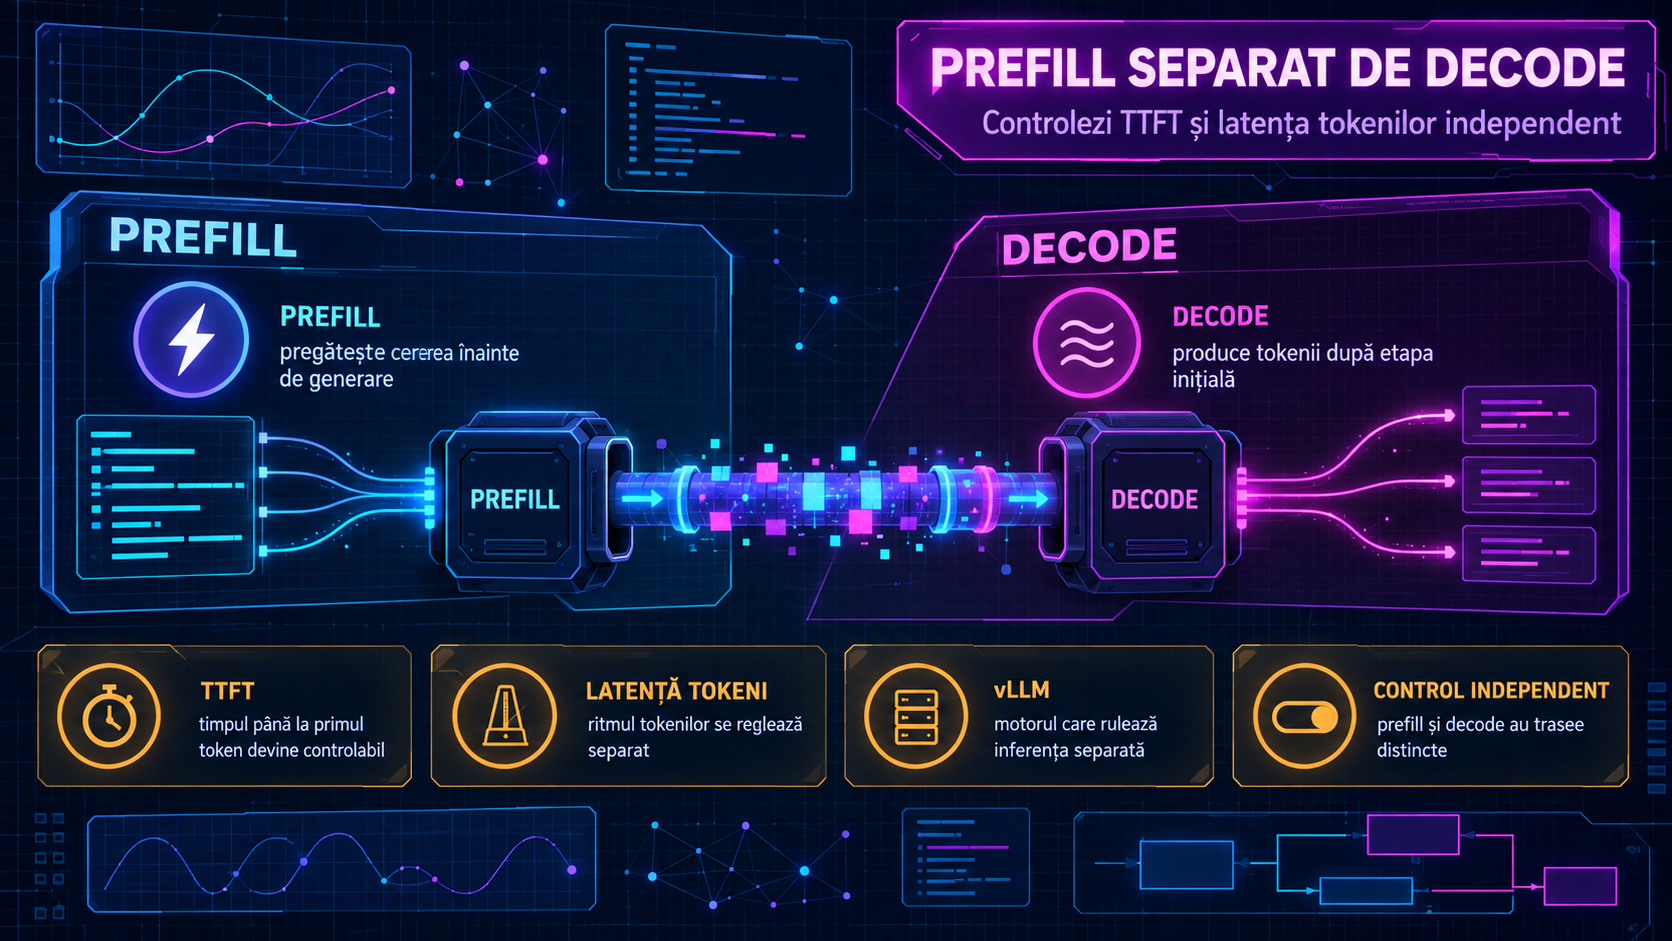
În servirea modelelor mari de limbaj, performanța nu înseamnă doar „câți tokeni pe secundă” poate produce sistemul. Pentru utilizator, contează două momente diferite: cât așteaptă până vede primul token și cât de constant vin tokenii următori. În terminologia folosită de vLLM, vorbim despre time-to-first-token, adică TTFT, și inter-token latency, adică ITL. Disaggregated Prefill este o funcție experimentală din vLLM care separă faza de prefill de faza de decode, astfel încât aceste două obiective să poată fi reglate independent.
Ca idee de bază, inferența pentru un prompt are două etape. În prefill, modelul procesează promptul inițial și construiește KV cache-ul necesar pentru continuarea generării. În decode, modelul generează tokenii noi, pas cu pas, folosind acest cache. Într-o configurare clasică, aceeași instanță vLLM gestionează ambele etape. Asta simplifică operarea, dar poate amesteca sarcini cu profiluri foarte diferite: prompturi lungi care cer mult prefill și răspunsuri în curs care au nevoie de decode stabil.
Disaggregated Prefill schimbă arhitectura: rulezi o instanță vLLM pentru prefill și o instanță vLLM pentru decode. Între ele există un connector care transferă KV cache-ul și rezultatele relevante de la instanța de prefill către instanța de decode. Documentația vLLM precizează că funcția este experimentală și poate suferi modificări, deci nu trebuie tratată ca o rețetă universal stabilă pentru orice mediu de producție.
Avantajul practic este controlul separat al TTFT și ITL. De exemplu, dacă problema principală este timpul până la primul token pentru prompturi mari, poți dimensiona sau paraleliza diferit instanța de prefill. Dacă problema este variația dintre tokenii generați, poți proteja instanța de decode de sarcini care îi întrerup ritmul. Documentația menționează explicit posibilitatea de a folosi strategii de paralelizare diferite, cum ar fi tensor parallelism sau pipeline parallelism, pentru a regla TTFT fără să afectezi ITL, sau invers.
Un caz important este latența de coadă pentru ITL. Fără separare, vLLM poate introduce joburi de prefill în timp ce o cerere se află în decode. Pentru utilizator, asta se poate vedea ca pauze neregulate în fluxul de tokeni, mai ales la percentile ridicate de latență. Chunked prefill poate reduce acest efect, dar alegerea dimensiunii corecte a chunk-ului este dificilă în practică. Disaggregated Prefill oferă o cale mai previzibilă: prefill-ul nu mai concurează în același mod cu decode-ul pentru aceleași resurse operaționale.
Este esențială o clarificare: conform documentației vLLM, Disaggregated Prefill nu îmbunătățește throughput-ul. Nu este o soluție magică pentru a servi mai multe cereri totale pe secundă. Este o tehnică de control al latenței și de izolare a fazelor. Dacă obiectivul tău este strict capacitatea totală, trebuie să măsori separat batching-ul, paralelizarea, cache-ul, hardware-ul și profilul traficului.
Operațional, începe prin măsurători, nu prin schimbarea arhitecturii. Colectează TTFT, ITL mediu, p95/p99 pentru ITL, lungimea prompturilor, lungimea răspunsurilor și nivelul de concurență. Dacă observi că răspunsurile au întreruperi mari când intră prompturi lungi, separarea prefill/decode merită testată într-un mediu de staging. Dacă problema este doar throughput-ul, probabil nu este instrumentul potrivit.
Alegerea connectorului depinde de versiunea vLLM, infrastructură și obiective. Documentația menționează conectori precum ExampleConnector, LMCacheConnectorV1 și LMCacheMPConnector, NixlConnector, MooncakeConnector, MoRIIOConnector, MooncakeStoreConnector, SharedStorageConnector, MultiConnector, OffloadingConnector și FlexKVConnectorV1. Nu presupune că toți sunt potriviți sau maturi pentru același scenariu. Verifică matricea de compatibilitate, modul de transfer KV, impactul asupra memoriei și comportamentul la erori.
Pentru echipele care folosesc endpointul /v1/chat/completions, vLLM documentează și o opțiune experimentală de refolosire a token id-urilor generate în prefill la etapa de decode. Ideea este să eviți retokenizarea promptului în decode, folosind return_token_ids și kv_transfer_params. Și aici prudența este obligatorie: fiind experimentală, integrarea trebuie testată pe versiunea exactă pe care o rulezi, cu aceleași șabloane de chat, aceleași opțiuni de streaming și aceleași constrângeri de output.
Din perspectivă defensivă, separarea prefill/decode trebuie tratată ca o schimbare de arhitectură, nu ca o simplă opțiune de configurare. Pune limite clare pentru cereri, monitorizează erorile de transfer KV, păstrează fallback către servirea standard și testează degradarea controlată dacă una dintre instanțe devine indisponibilă. Înainte de producție, compară rezultatele pe trafic reprezentativ: TTFT, ITL p95/p99, rata de erori, utilizarea GPU, memorie și experiența utilizatorului final.
Concluzia practică este simplă: Disaggregated Prefill în vLLM este util când ai nevoie să controlezi separat primul token și ritmul tokenilor următori. Poate reduce surprizele de tail latency, dar nu promite throughput mai mare și nu elimină necesitatea măsurătorilor. Folosește-l ca experiment controlat, cu metrici clare și rollback pregătit.