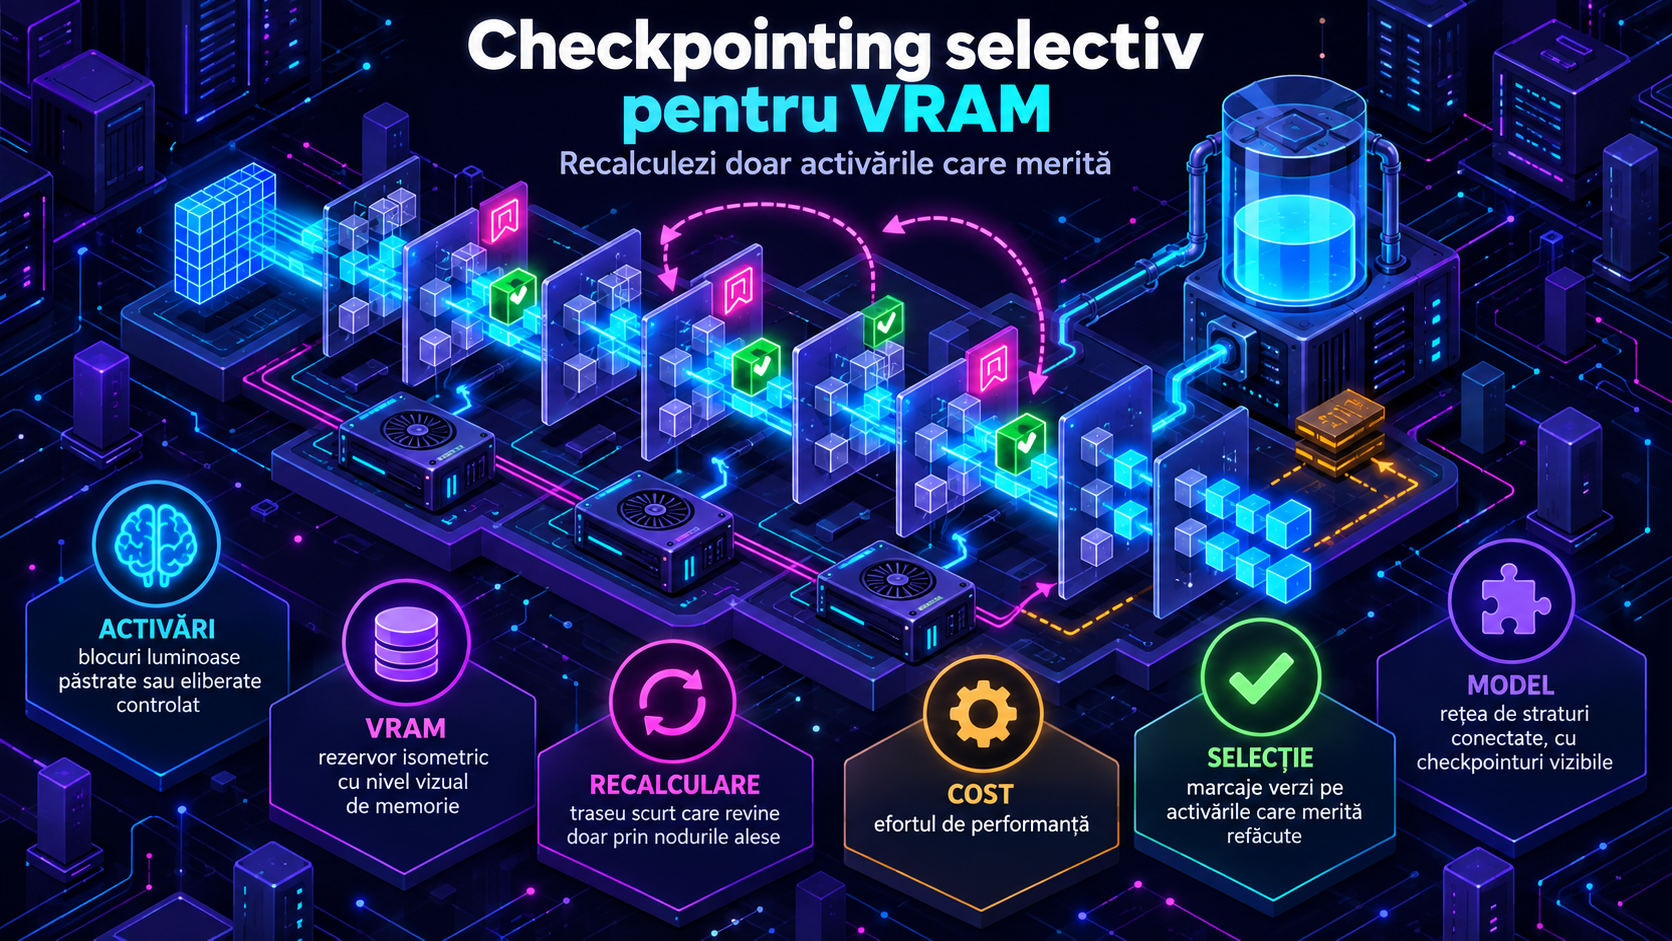
Selective Activation Checkpointing (SAC) este o tehnică utilă când antrenezi sau ajustezi modele mari și limita reală nu este numărul de nuclee GPU, ci memoria VRAM. Ideea pornește de la activation checkpointing: în loc să păstrezi toate activările intermediare din forward pentru etapa de backward, salvezi mai puține tensori și recalculezi o parte dintre ei când devin necesari. Câștigi memorie, dar plătești cu timp de calcul suplimentar.
Diferența practică este că SAC nu tratează regiunea checkpoint ca pe o cutie neagră. În checkpointingul clasic, activările intermediare din regiune sunt de obicei rematerializate în backward, cu excepția intrărilor funcției. Cu SAC poți spune explicit: această operație merită salvată, iar aceasta poate fi recalculată. În PyTorch, politica se exprimă printr-un policy_fn care returnează, pentru fiecare operație, CheckpointPolicy.MUST_SAVE sau PREFER_SAVE pentru salvare, respectiv MUST_RECOMPUTE sau PREFER_RECOMPUTE pentru recalculare. Documentația PyTorch notează că variantele MUST nu ar trebui suprascrise de subsisteme precum torch.compile.
Regula de bază este simplă: recalculează operațiile ieftine și salvează operațiile scumpe. Operațiile pointwise, cum ar fi adunări, înmulțiri element-cu-element, activări simple sau normalizări ușoare, sunt de multe ori candidate bune pentru recalculare deoarece au cost relativ mic față de memoria pe care o pot elibera într-un graf mare. În schimb, matmul, batch matmul și addmm sunt operații grele; blogul PyTorch le dă ca exemple de operații pe care, de regulă, nu vrei să le recalculezi: aten.mm.default, aten.bmm și aten.addmm.
Pentru modele mai complexe, politica poate deveni mai conservatoare. PyTorch menționează că o variantă mai agresivă de salvare poate include convolution, attention eficient/flash și scaled_mm. Motivul este pragmatic: dacă o operație domină timpul de execuție, recalcularea ei poate anula beneficiul obținut din reducerea VRAM. Într-un transformer, de exemplu, atenția poate fi suficient de scumpă încât să fie salvată sau recalculată doar mai târziu, în funcție de bugetul de memorie.
Un fragment conceptual arată așa, fără a fi o rețetă universală:
from functools import partial
from torch.utils.checkpoint import checkpoint, create_selective_checkpoint_contexts, CheckpointPolicy
ops_de_salvat = {“aten.mm.default”, “aten.bmm.default”, “aten.addmm.default”}
def policy_fn(ctx, op, *args, **kwargs):
if str(op) in ops_de_salvat:
return CheckpointPolicy.MUST_SAVE
return CheckpointPolicy.PREFER_RECOMPUTE
out = checkpoint(
fn,
*args,
use_reentrant=False,
context_fn=partial(create_selective_checkpoint_contexts, policy_fn),
)
În practică, nu porni de la o politică perfectă. Începe cu regiunea unde vârful de memorie apare frecvent: PyTorch explică faptul că, în eager mode, autograd păstrează activări intermediare pentru backward, iar vârful de memorie apare adesea la începutul backward. Alege un bloc repetitiv, de exemplu un strat transformer sau un modul mare, apoi aplică SAC doar acolo. Măsoară memoria maximă, timpul pe pas și stabilitatea numerică înainte și după. Notează și configurația exactă: versiunea PyTorch, tipul GPU-ului, batch size-ul, lungimea secvenței și setările de compile, altfel comparația poate induce în eroare.
Testează în trei trepte. Prima: o politică echivalentă cu checkpointing clasic, în care policy_fn întoarce PREFER_RECOMPUTE pentru toate operațiile. A doua: salvează explicit matmul/bmm/addmm. A treia: dacă timpul crește prea mult, salvează și convolution sau attention, acolo unde există. Evită concluzia greșită că PREFER_SAVE peste tot înseamnă „fără checkpointing”; codul PyTorch avertizează că poate salva tensori suplimentari.
Dacă folosești torch.compile, PyTorch oferă și Memory Budget API, prin torch._dynamo.config.activation_memory_budget. Un buget 0 se comportă ca activation checkpointing simplu, iar 1 ca torch.compile implicit. Valori intermediare, de exemplu 0.5, lasă sistemul să caute un compromis între memorie și performanță.
Blogul PyTorch raportează, pe un model transformer testat de ei, o reducere de 50% a memoriei prin recalcularea doar a operațiilor pointwise. Este un rezultat util ca reper, nu o garanție universală. Dimensiunea modelului, lungimea secvenței, kernelurile disponibile, versiunea PyTorch și GPU-ul pot schimba complet balanța. SAC merită atunci când ai un obiectiv concret: să crești batch size-ul, să eviți out-of-memory sau să rulezi fine-tuning pe hardware limitat, fără să recalculezi inutil operațiile cele mai scumpe.