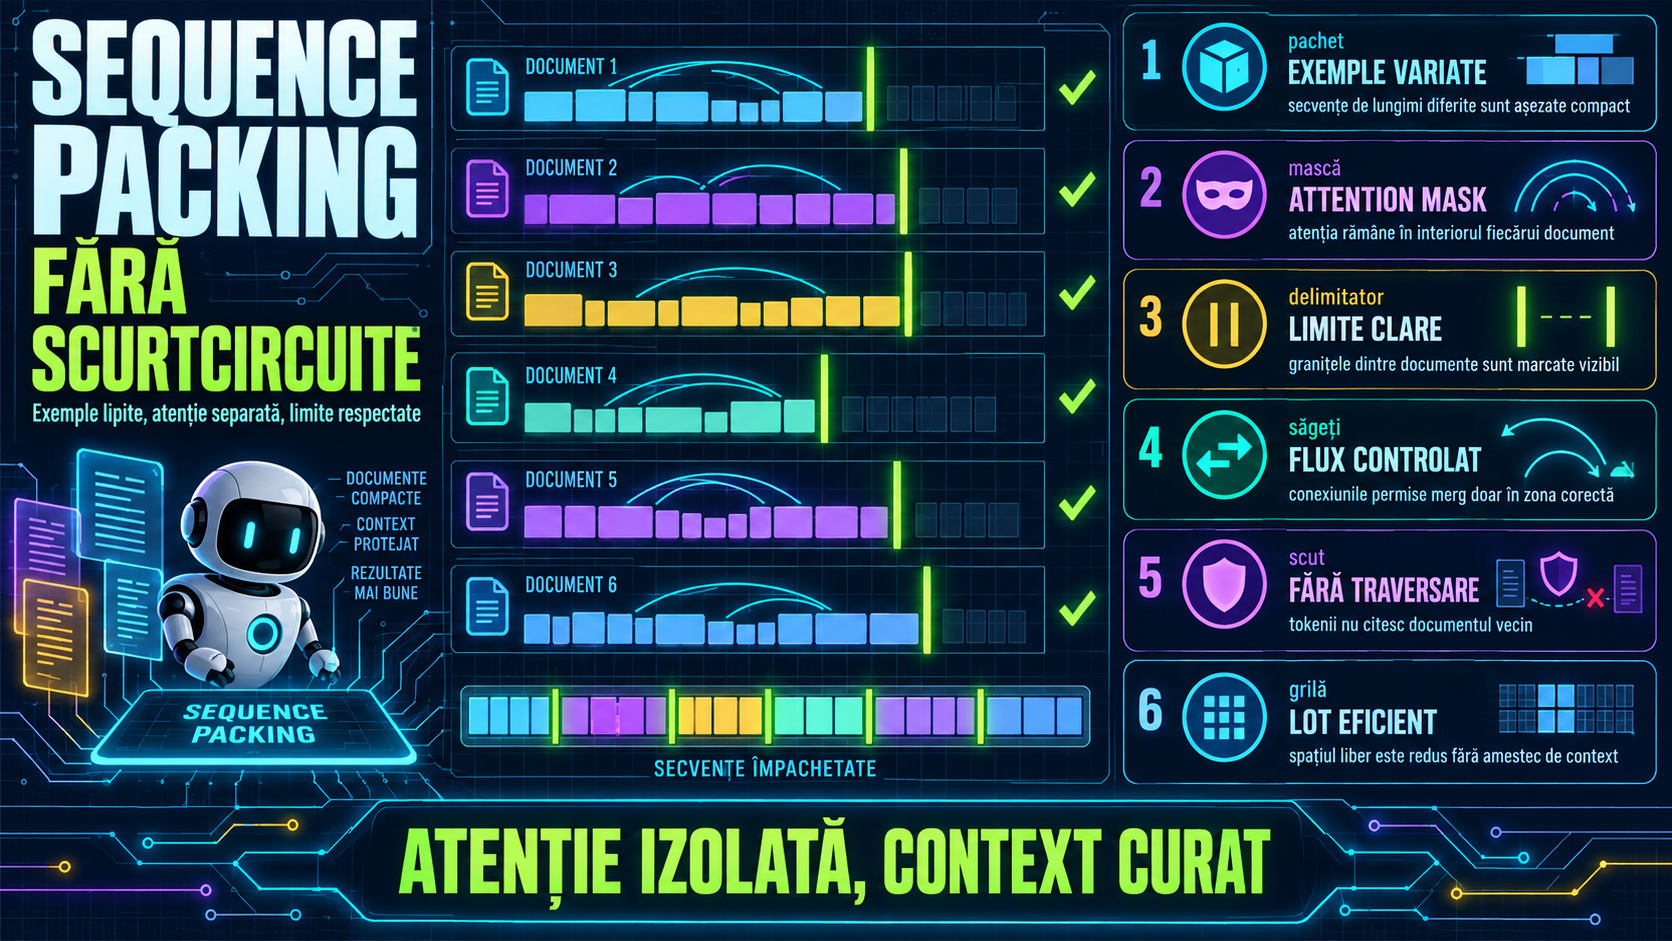
În antrenarea modelelor lingvistice mari, risipa vine adesea din padding: exemplele scurte sunt umplute cu tokeni inutili doar pentru a ajunge la aceeași lungime cu exemplele lungi din batch. Sequence packing rezolvă parțial problema prin lipirea mai multor exemple într-o singură secvență de lungime fixă. Dar aici apare capcana: dacă împachetarea este făcută naiv, modelul poate „vedea” tokeni din documentul următor, iar acest lucru schimbă semnalul de antrenare.
Pentru un tutorial AI avansat, ideea esențială este simplă: nu este suficient să concatenezi texte. Trebuie să păstrezi limitele dintre documente în attention, în poziții și în loss.
De ce packing-ul simplu poate fi greșit
Într-un model cauzal, attention-ul permite unui token să vadă tokenii anteriori. Dacă pui trei documente unul după altul într-o secvență de 4.096 tokeni, tokenii din documentul al treilea ar putea avea acces la documentele unu și doi, deși acestea nu fac parte din același context real.
Pentru pretraining pe text continuu, uneori această alegere poate fi acceptată ca aproximare, în funcție de obiectiv. Pentru fine-tuning conversațional, instrucțiuni, exemple independente sau date sensibile la structură, este periculos metodologic. Modelul învață din contexte artificiale, iar evaluarea poate deveni neclară.
De aceea, sequence packing avansat tratează fiecare exemplu ca segment separat, chiar dacă fizic tokenii sunt așezați într-un tensor comun.
Ce trebuie păstrat pentru fiecare segment
Un pachet corect are cel puțin trei informații importante.
Prima este lista de tokeni, adică input_ids, rezultată prin concatenarea exemplelor. A doua este granița fiecărui exemplu: unde începe și unde se termină fiecare document sau conversație. A treia este poziția internă a tokenilor, adică position_ids, care trebuie resetată la începutul fiecărui segment atunci când arhitectura și implementarea o cer.
Dacă ai trei exemple cu lungimi de 700, 1.200 și 900 tokeni, ele pot încăpea într-un bloc de 2.800 tokeni. Dar attention-ul nu trebuie să se comporte ca și cum ai avea un singur document lung de 2.800 tokeni. Fiecare exemplu trebuie să rămână izolat logic.
Masca de attention: regula de bază
Principiul corect este o mască bloc-diagonală. Tokenii din segmentul A pot vedea doar tokenii anteriori din segmentul A. Tokenii din segmentul B pot vedea doar tokenii anteriori din segmentul B. Nu există muchii de attention între A și B, chiar dacă în memorie ele sunt vecine.
În practică, implementările moderne pot evita construirea unei măști dense mari, pentru că aceasta ar consuma memorie. FlashAttention 2 și variantele cu secvențe de lungimi variabile folosesc informații despre lungimile cumulative ale secvențelor, cunoscute în documentație ca cu_seqlens. Astfel, kernelul știe unde sunt limitele fiecărei secvențe în tensorul aplatizat.
Aceasta este diferența importantă: packing-ul nu trebuie să fie doar o operație de dataset, ci și o convenție respectată de mecanismul de attention.
Strategii de împachetare
O strategie des întâlnită este best-fit decreasing: sortezi exemplele după lungime și le așezi în blocuri astfel încât spațiul liber să fie cât mai mic. În TRL, documentația menționează strategii precum bfd, bfd_split și wrapped.
Pentru fine-tuning pe conversații sau instrucțiuni, strategia care păstrează granițele este de obicei mai sigură. Variantele care taie agresiv în mijlocul secvenței pot folosi mai eficient spațiul, dar pot rupe structura unui dialog, a unei instrucțiuni sau a unui exemplu complet. Asta nu înseamnă că sunt greșite mereu, ci că trebuie alese în funcție de tipul datasetului.
Pentru date conversaționale, regula practică este: mai bine pierzi puțină eficiență decât să amesteci roluri, răspunsuri sau documente independente.
Loss-ul trebuie mascat separat
Attention-ul nu este singurul loc unde pot apărea erori. La supervised fine-tuning, de multe ori nu vrei să calculezi loss pe tot textul, ci doar pe partea de răspuns. Dacă împachetezi mai multe exemple, masca de labels trebuie să respecte și ea granițele fiecărui exemplu.
Un bug frecvent este ca inputul să fie împachetat corect, dar labels să fie deplasate greșit sau să includă tokeni care aparțin promptului, separatorilor ori altui document. Rezultatul nu este o eroare spectaculoasă, ci un model antrenat pe semnal murdar.
Ce verifici înainte de antrenare
Înainte să rulezi un job lung, verifică vizual câteva batch-uri. Decodează exemplele împachetate, marchează limitele segmentelor și confirmă că position_ids se resetează unde trebuie. Verifică dacă attention-ul sau mecanismul varlen primește lungimile corecte. Confirmă că labels au -100, sau valoarea ignorată de framework, acolo unde nu trebuie calculat loss.
Mai important: testează cu exemple mici, unde poți anticipa manual ce token are voie să vadă. Dacă această verificare nu trece, eficiența obținută prin packing nu merită.
Concluzia practică
Sequence packing avansat este una dintre optimizările utile pentru antrenarea modelelor AI, dar numai când este implementat cu respectarea granițelor dintre documente. Obiectivul nu este doar să umpli contextul, ci să îl umpli fără contaminare între exemple.
Pentru proiecte reale, abordarea sănătoasă este să folosești implementări mature, să eviți concatenarea manuală naivă și să verifici explicit trei lucruri: limitele segmentelor, position_ids și labels. Dacă toate trei sunt corecte, packing-ul poate reduce padding-ul și poate face antrenarea mai eficientă fără să compromită structura datelor.
Surse
- Hugging Face Blog — Improving Hugging Face Training Efficiency Through Packing with Flash Attention 2
- Hugging Face TRL — SFTConfig / SFTTrainer packing, packing_strategy și padding_free
- Hugging Face TRL — data_utils.py, strategii de packing bfd, bfd_split și wrapped
- FlashAttention — repository oficial și documentație despre flash_attn_varlen_func