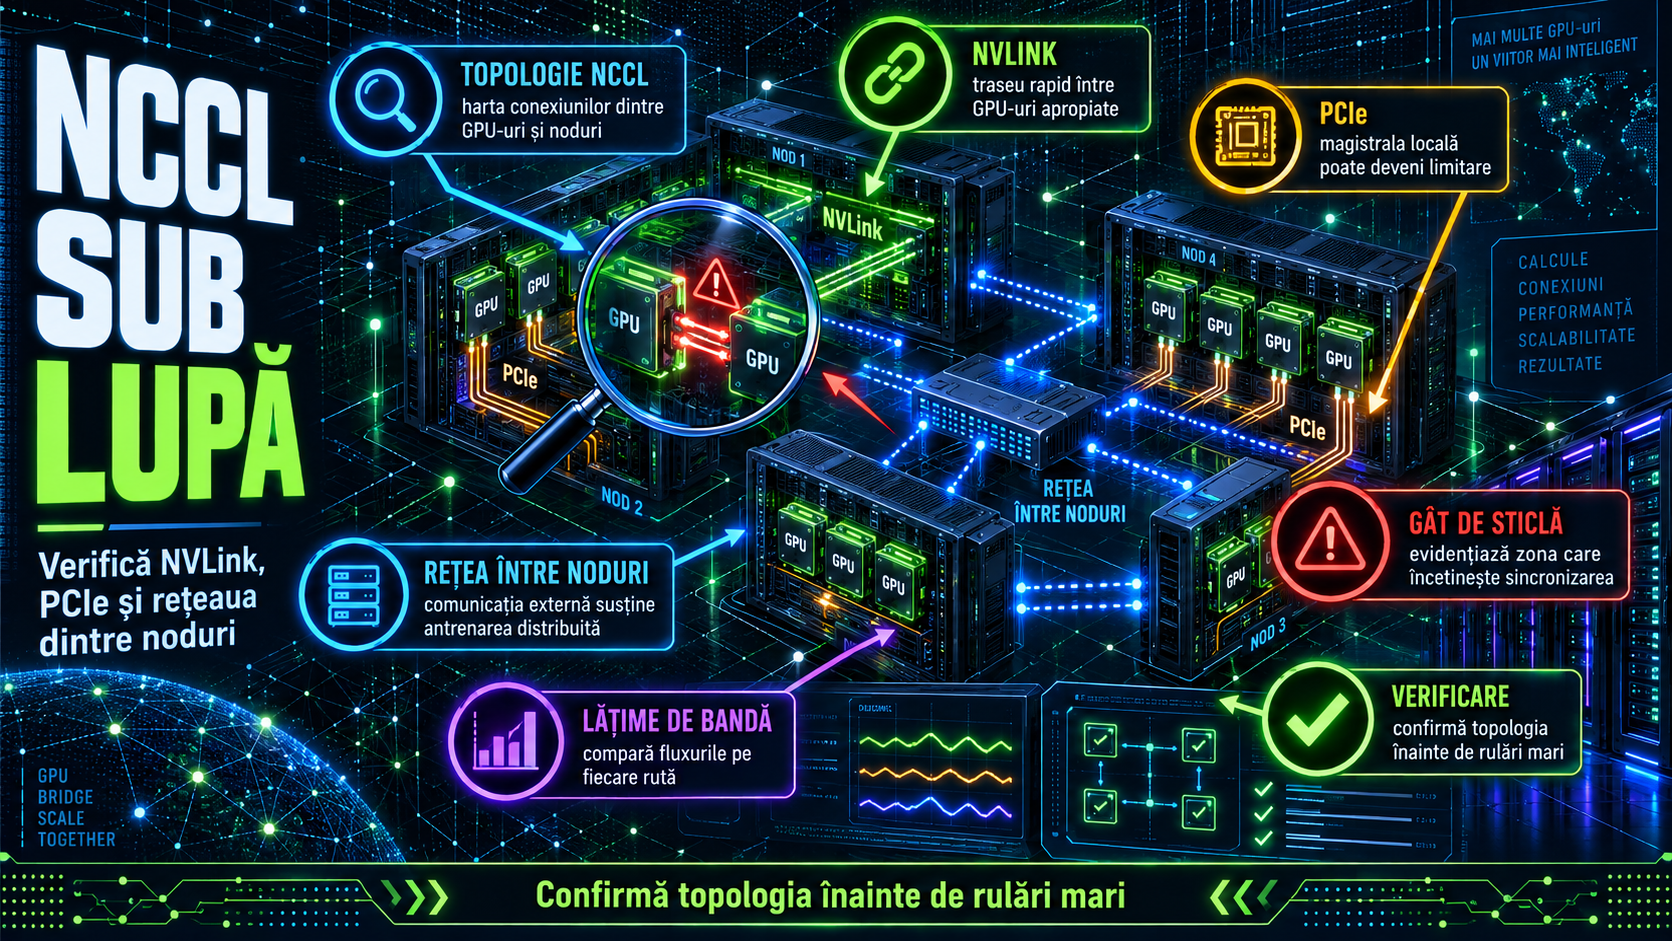
Când antrenarea distribuită încetinește, primul suspect nu este mereu modelul, framework-ul sau codul Python. De multe ori, problema stă mai jos: în felul în care NCCL vede legăturile dintre GPU-uri, magistrala PCIe, plăcile de rețea și interfețele dintre noduri.
NCCL, biblioteca NVIDIA folosită frecvent pentru comunicații colective între GPU-uri, își construiește deciziile pe topologia detectată a sistemului. Dacă această hartă este greșită, incompletă sau forțată printr-o interfață nepotrivită, antrenarea poate părea „misterios” de lentă. Vestea bună: poți investiga problema fără să schimbi modelul și fără să faci tuning orb.
Începe cu harta fizică, nu cu presupuneri
Primul pas este să vezi dacă GPU-urile pot comunica direct între ele. Documentația NVIDIA arată că, pentru traficul GPU-to-GPU, NCCL favorizează peer-to-peer atunci când CUDA raportează acces direct, de obicei prin NVLink sau prin PCIe, dacă topologia și driverul permit acest lucru.
Pentru o verificare sigură, folosește nvidia-smi topo -p2p p pentru PCIe și nvidia-smi topo -p2p n pentru NVLink. Nu interpreta rezultatul ca pe un scor de performanță, ci ca pe o hartă de posibilități: care perechi de GPU pot comunica direct și care sunt obligate să treacă prin rute mai slabe.
Dacă te afli într-un container sau într-o mașină virtuală, verificarea devine și mai importantă. NVIDIA precizează că NCCL se bazează pe /sys pentru a descoperi topologia PCI a GPU-urilor și a plăcilor de rețea. Dacă /sys este montat incomplet sau expune o topologie virtualizată, NCCL poate lua decizii suboptime.
Scoate topologia NCCL într-un fișier
Pentru debugging, NCCL oferă variabila NCCL_TOPO_DUMP_FILE. Aceasta setează calea unui fișier în care biblioteca scrie topologia XML detectată după scanarea sistemului. Practic, nu mai ghicești ce „crede” NCCL despre server; îl pui să îți arate.
Un exemplu defensiv ar fi să rulezi jobul de test cu NCCL_TOPO_DUMP_FILE=/tmp/nccl-topo.xml și să păstrezi fișierul pentru analiză internă. Nu îl publica automat: poate conține detalii despre infrastructură, dispozitive și denumiri de interfețe care nu trebuie expuse.
Pentru loguri, folosește NCCL_DEBUG=INFO împreună cu NCCL_DEBUG_SUBSYS. Documentația NVIDIA spune că NCCL_DEBUG_SUBSYS filtrează logurile pe subsisteme precum INIT, P2P, SHM, NET și GRAPH, iar GRAPH se referă la detectarea topologiei și căutarea grafului. Într-o investigație de performanță, GRAPH, P2P și NET sunt de obicei cele mai utile zone de pornire.
Atenție: NVIDIA avertizează că variabilele de debugging nu ar trebui păstrate permanent în producție, decât ca soluții temporare. După analiză, revino la configurația normală.
Verifică PCIe, ACS și traseul spre placa de rețea
Dacă NVLink lipsește sau nu este disponibil între anumite perechi, traficul poate depinde de PCIe. Aici apar probleme ascunse: setări BIOS, IOMMU, Access Control Services sau rute prin CPU root complex.
În documentația NVIDIA, ACS pe sisteme bare-metal este semnalat ca posibil factor de reducere majoră a performanței, deoarece poate redirecționa traficul PCI point-to-point prin CPU. Verificarea cu lspci ține de administrarea infrastructurii și trebuie făcută de cineva cu acces legitim la server. Pentru echipele mici, regula simplă este aceasta: dacă performanța între GPU-uri este slabă, dar modelul și batch-ul sunt neschimbate, cereți o verificare a traseului PCIe înainte să rescrieți codul.
Nu uita de GPU-to-NIC. Pentru comunicația directă între GPU și placa de rețea, NVIDIA menționează GPU Direct RDMA, care cere hardware și drivere compatibile și, în unele configurații, modulul nvidia-peermem sau DMA-BUF pe sisteme compatibile.
Testează rețeaua dintre noduri separat
În antrenarea multi-node, o topologie internă bună nu ajută dacă nodurile comunică prin interfața greșită. NCCL autodetectează interfețele de rețea, dar documentația NVIDIA avertizează că, dacă unele interfețe sunt UP fără să comunice corect între noduri, inițializarea poate eșua sau se poate bloca.
Aici intră NCCL_SOCKET_IFNAME, variabila care permite alegerea interfețelor IP folosite pentru comunicare. Nu o seta după ureche. Notează interfețele reale, confirmă ruta dintre noduri și abia apoi restrânge NCCL la interfața corectă.
Pentru InfiniBand, NVIDIA recomandă verificări de nivel jos cu ibstatus și ibstat, urmărind starea portului, link-ul fizic, layer-ul și rata de link așteptată. Aceste verificări nu repară singure problema, dar separă clar o eroare de rețea de o problemă de model.
Rulează un test controlat înainte de training
Înainte să dai vina pe aplicație, rulează nccl-tests. Proiectul oficial NVIDIA include all_reduce_perf, care poate testa comunicația pe mai multe GPU-uri, procese și noduri, iar în scenarii multi-node folosește MPI.
Important este să compari scenarii, nu să vânezi o cifră universală: single-node versus multi-node, toate GPU-urile versus perechi, interfața implicită versus interfața setată explicit. Dacă testul NCCL este lent în același mod ca trainingul, problema este probabil sub aplicație.
O investigație bună a topologiei NCCL are trei întrebări simple: GPU-urile vorbesc direct între ele? Placa de rețea este pe traseul potrivit? Nodurile folosesc interfața corectă? Răspunsurile nu sunt spectaculoase, dar pot salva zile întregi de optimizări greșite.