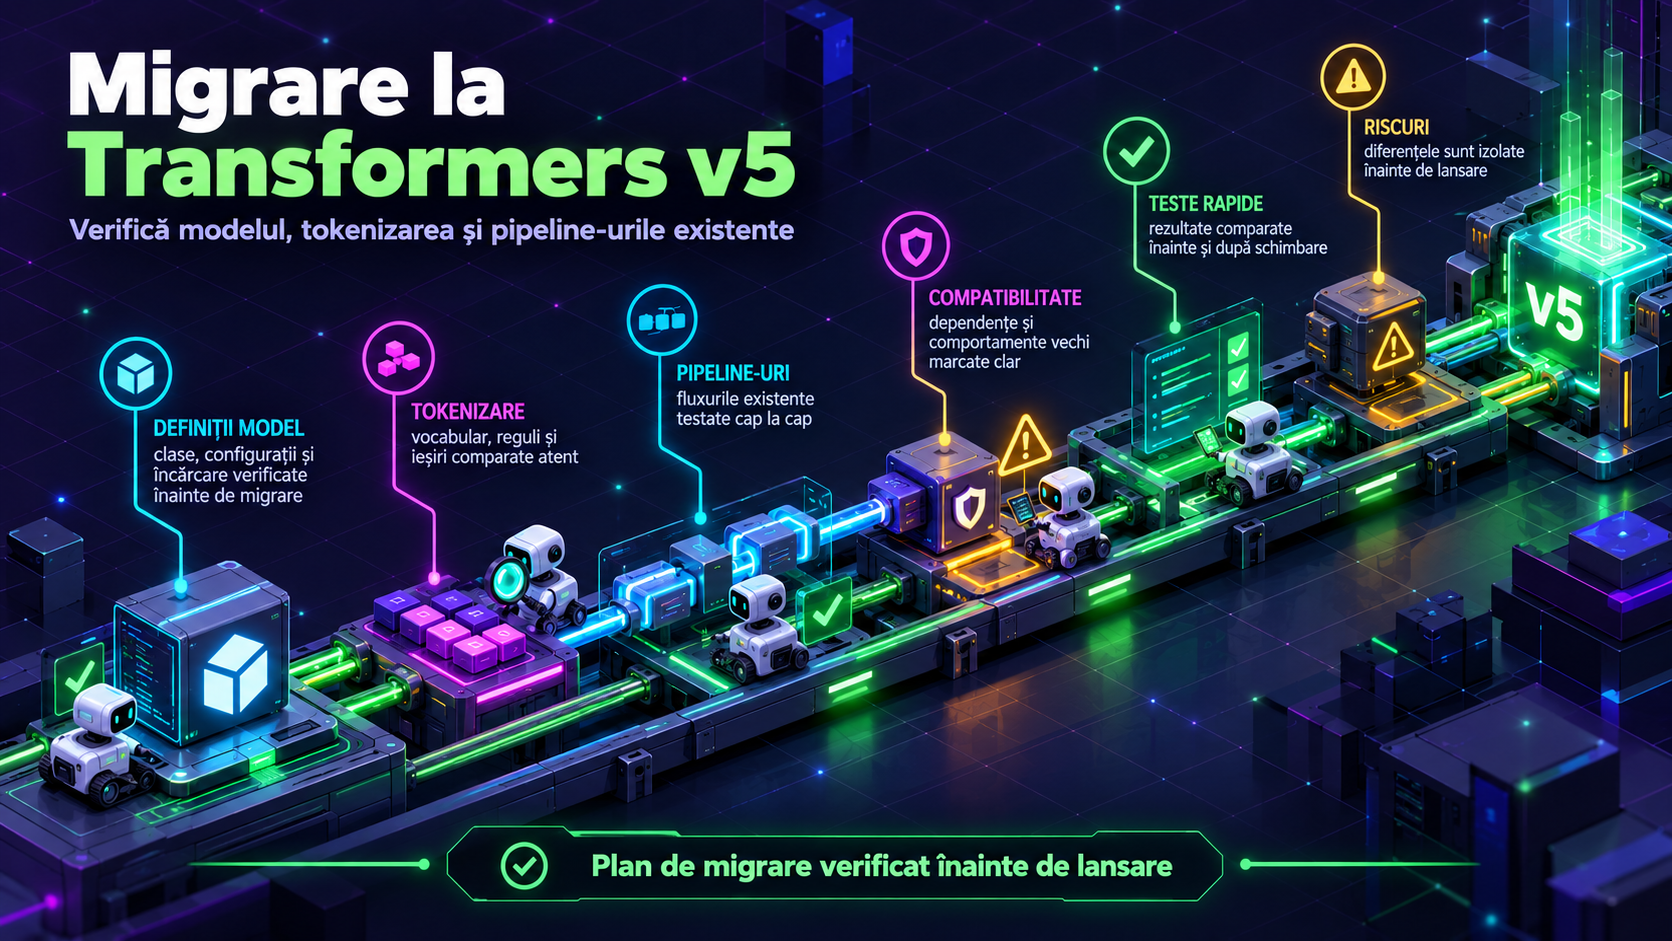
Migrarea la Transformers v5 nu trebuie tratată ca un simplu pip install -U. Pentru echipele care au modele salvate local, tokenizatoare modificate, pipeline-uri în producție și joburi de inferență automate, riscul real este incompatibilitatea tăcută: modelul se încarcă, dar primește intrări diferite sau livrează câmpuri pe care aplicația nu le mai verifică.
În acest tutorial construim un proiect complet de audit: descărcăm un model mic de test, salvăm modelul și tokenizerul local, verificăm configurația, fișierele de tokenizare, intrările acceptate de pipeline și rulăm o probă de inferență. Rezultatul final este un fișier migration_report.json care spune clar dacă artefactul este pregătit pentru migrare.
Dacă lucrezi deja cu optimizări de inferență sau adaptări peste modele de bază, acest audit merită făcut înainte de schimbări mai mari, cum ar fi LoRA adapters în producție sau experimente de performanță de tip kernel Triton personalizat.
Ce construim
Construim un director local v5-migration-audit/ cu trei componente: un script care pregătește artefactul modelului, un script care auditează definiția de model și tokenizarea, apoi un script care verifică un pipeline text-classification.
La final vei avea:
artifacts/tiny-distilbert/cu modelul și tokenizerul salvate local;reports/migration_report.jsoncu verificări pentruconfig.json,tokenizer.json, tokeni speciali,model_input_names, încărcare prinAutoConfig,AutoTokenizer,AutoModelForSequenceClassificationși pipeline;- un output reproductibil:
MIGRATION_AUDIT_OK.
Mediul exact
Tutorialul folosește Ubuntu Server 24.04 LTS, Python 3.12, uv, transformers==5.19.0 și torch==2.9.1 pe CPU. Modelul de test este hf-internal-testing/tiny-random-distilbert, un model mic public de pe Hugging Face Hub, potrivit pentru verificări tehnice rapide, nu pentru calitate semantică.
Resurse minime: 4 GB RAM, 2 GB spațiu liber pe disc, conexiune la internet pentru prima descărcare. Timp estimat: 20-30 de minute.
Ce îți trebuie
Instalăm un mediu Python izolat și pachetele necesare. Comenzile de mai jos folosesc CPU, ca auditul să fie reproductibil și pe servere fără GPU.
mkdir -p v5-migration-audit
cd v5-migration-audit
uv venv .venv --python 3.12
source .venv/bin/activate
uv pip install torch==2.9.1 --index-url https://download.pytorch.org/whl/cpu
uv pip install transformers==5.19.0 huggingface_hub==1.1.5 safetensors==0.7.0
python -c "import transformers, torch; print(transformers.__version__); print(torch.__version__)"
Ce trebuie să vezi: prima linie trebuie să fie 5.19.0, iar a doua linie trebuie să înceapă cu 2.9.1.
5.19.0
2.9.1+cpu
Pasul 1: pregătim modelul local
Creăm un script care descarcă modelul mic, îl încarcă prin clasele Auto* și îl salvează local. În migrare, asta separă problema de rețea de problema de compatibilitate: auditul se face apoi pe fișierele locale.
Creează fișierul prepare_artifact.py:
from pathlib import Path

from transformers import AutoModelForSequenceClassification, AutoTokenizer

MODEL_ID = "hf-internal-testing/tiny-random-distilbert"
OUT_DIR = Path("artifacts/tiny-distilbert")

OUT_DIR.mkdir(parents=True, exist_ok=True)

tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, use_fast=True)
model = AutoModelForSequenceClassification.from_pretrained(MODEL_ID)

tokenizer.save_pretrained(OUT_DIR)
model.save_pretrained(OUT_DIR)

print(f"SAVED_MODEL_DIR={OUT_DIR}")
print(f"TOKENIZER_FAST={tokenizer.is_fast}")
print(f"MODEL_CLASS={model.__class__.__name__}")
Rulează:
python prepare_artifact.pyCe trebuie să vezi:
SAVED_MODEL_DIR=artifacts/tiny-distilbert
TOKENIZER_FAST=True
MODEL_CLASS=DistilBertForSequenceClassification
Verifică fișierele:
find artifacts/tiny-distilbert -maxdepth 1 -type f | sortCe trebuie să vezi: lista trebuie să includă config.json, tokenizer.json, tokenizer_config.json și un fișier de greutăți, de regulă model.safetensors.
Pasul 2: audităm definiția de model și tokenizerul
Acum verificăm punctele care se rup cel mai des la migrare: model_type, arhitectura încărcată prin AutoConfig, existența tokenizer.json, tokenii speciali, intrările produse de tokenizer și compatibilitatea lor cu modelul.
Creează fișierul audit_artifact.py:
import json
from pathlib import Path

from transformers import (
    AutoConfig,
    AutoModelForSequenceClassification,
    AutoTokenizer,
    pipeline,
)

ARTIFACT_DIR = Path("artifacts/tiny-distilbert")
REPORT_DIR = Path("reports")
REPORT_PATH = REPORT_DIR / "migration_report.json"

REQUIRED_FILES = [
    "config.json",
    "tokenizer.json",
    "tokenizer_config.json",
]

TEXTS = [
    "Transformers v5 migration audit.",
    "Pipeline compatibility check.",
]


def require_file(path: Path) -> bool:
    return path.exists() and path.is_file()


def main() -> None:
    REPORT_DIR.mkdir(parents=True, exist_ok=True)

    missing_files = [
        file_name
        for file_name in REQUIRED_FILES
        if not require_file(ARTIFACT_DIR / file_name)
    ]

    config = AutoConfig.from_pretrained(ARTIFACT_DIR)
    tokenizer = AutoTokenizer.from_pretrained(ARTIFACT_DIR, use_fast=True)
    model = AutoModelForSequenceClassification.from_pretrained(ARTIFACT_DIR)

    encoded = tokenizer(
        TEXTS,
        padding=True,
        truncation=True,
        return_tensors="pt",
    )

    model_inputs = sorted(encoded.keys())
    expected_inputs = sorted(tokenizer.model_input_names)
    special_tokens = tokenizer.special_tokens_map

    pipe = pipeline(
        task="text-classification",
        model=model,
        tokenizer=tokenizer,
        device="cpu",
    )
    pipe_output = pipe(TEXTS)

    checks = {
        "required_files_present": len(missing_files) == 0,
        "model_type_is_distilbert": config.model_type == "distilbert",
        "tokenizer_is_fast": bool(tokenizer.is_fast),
        "has_tokenizer_json": require_file(ARTIFACT_DIR / "tokenizer.json"),
        "has_special_tokens": all(
            key in special_tokens
            for key in ["unk_token", "sep_token", "pad_token", "cls_token", "mask_token"]
        ),
        "encoded_has_input_ids": "input_ids" in encoded,
        "encoded_has_attention_mask": "attention_mask" in encoded,
        "pipeline_returns_two_items": len(pipe_output) == 2,
        "pipeline_has_label_and_score": all(
            sorted(item.keys()) == ["label", "score"]
            for item in pipe_output
        ),
    }

    report = {
        "artifact_dir": str(ARTIFACT_DIR),
        "transformers_target": "5.19.0",
        "config_class": config.__class__.__name__,
        "model_class": model.__class__.__name__,
        "model_type": config.model_type,
        "architectures": config.architectures,
        "tokenizer_class": tokenizer.__class__.__name__,
        "tokenizer_fast": tokenizer.is_fast,
        "tokenizer_model_input_names": expected_inputs,
        "encoded_input_names": model_inputs,
        "special_tokens_map": special_tokens,
        "missing_files": missing_files,
        "pipeline_task": "text-classification",
        "pipeline_output_keys": [sorted(item.keys()) for item in pipe_output],
        "checks": checks,
        "ok": all(checks.values()),
    }

    REPORT_PATH.write_text(
        json.dumps(report, indent=2, ensure_ascii=False),
        encoding="utf-8",
    )

    if not report["ok"]:
        print(f"MIGRATION_AUDIT_FAILED report={REPORT_PATH}")
        raise SystemExit(1)

    print(f"MIGRATION_AUDIT_OK report={REPORT_PATH}")


if __name__ == "__main__":
    main()
Rulează:
python audit_artifact.pyCe trebuie să vezi:
MIGRATION_AUDIT_OK report=reports/migration_report.jsonPasul 3: verificăm raportul JSON
Raportul este util în CI, pentru că poate fi citit de un job automat. Îl inspectăm fără să ne bazăm pe impresia că pipeline-ul „pare să meargă”.
python -m json.tool reports/migration_report.jsonCe trebuie să vezi: câmpul ok trebuie să fie true, iar checks trebuie să conțină doar valori true.
"model_type": "distilbert"
"tokenizer_fast": true
"pipeline_task": "text-classification"
"ok": true
Dacă ai mai multe artefacte interne, aceeași structură se repetă pe fiecare director de model. Pentru modele aliniate sau evaluate cu proceduri mai ample, auditul acesta se poate pune înaintea pașilor de calitate, cum ar fi Benchmark Contamination Detection sau Reward Model pentru preference learning.
Pasul 4: adăugăm o comandă de verificare pentru CI
Creăm un mic script shell care rulează auditul cap-coadă. Este util înainte de migrarea unei imagini Docker sau înainte de schimbarea versiunii dintr-un fișier requirements.txt.
Creează run_audit.sh:
#!/usr/bin/env bash
set -euo pipefail

source .venv/bin/activate

python prepare_artifact.py
python audit_artifact.py
python - <<'PY'
import json
from pathlib import Path

report = json.loads(Path("reports/migration_report.json").read_text(encoding="utf-8"))
assert report["ok"] is True
assert report["model_type"] == "distilbert"
assert report["pipeline_task"] == "text-classification"
print("CI_CHECK_OK")
PY
Rulează:
chmod +x run_audit.sh
./run_audit.sh
Ce trebuie să vezi la final:
MIGRATION_AUDIT_OK report=reports/migration_report.json
CI_CHECK_OK
Verificarea finală
Rulează o singură comandă pentru confirmarea completă:
./run_audit.sh && test -f reports/migration_report.json && echo FINAL_OKRezultatul așteptat:
FINAL_OKDacă vezi FINAL_OK, ai confirmat că modelul se încarcă prin AutoConfig, AutoTokenizer și AutoModelForSequenceClassification, că tokenizerul produce intrările necesare și că pipeline-ul returnează structura minimă așteptată.
Probleme frecvente
Eroare:
ModuleNotFoundError: No module named 'transformers'Cauză: mediul virtual nu este activat. Rezolvare:
source .venv/bin/activate
uv pip install transformers==5.19.0
Eroare:
OSError: artifacts/tiny-distilbert does not appear to have a file named config.jsonCauză: ai rulat auditul înainte de prepare_artifact.py sau directorul a fost șters. Rezolvare:
python prepare_artifact.py
python audit_artifact.py
Eroare:
ValueError: The model has been loaded with `accelerate` and therefore cannot be moved to a specific device.Cauză: ai combinat un model încărcat cu device_map și un pipeline cu device. În acest tutorial folosim explicit CPU și nu folosim device_map. Rezolvare: păstrează linia din tutorial:
pipe = pipeline(
    task="text-classification",
    model=model,
    tokenizer=tokenizer,
    device="cpu",
)
Eroare:
AssertionErrorCauză: una dintre verificările din run_audit.sh nu mai corespunde raportului. Rezolvare: inspectează raportul și vezi ce câmp s-a schimbat:
python -m json.tool reports/migration_report.jsonRevenire și curățenie
Dacă vrei să revii la starea inițială, șterge directorul proiectului. Comanda următoare elimină mediul virtual, modelul descărcat local și raportul.
Avertisment: ruleaz-o doar din directorul v5-migration-audit.
pwd
rm -rf .venv artifacts reports prepare_artifact.py audit_artifact.py run_audit.sh
Ce trebuie să vezi după verificare:
find . -maxdepth 2 -type f | sortOutputul trebuie să nu mai includă fișierele create în tutorial.
Mai departe
Următorul pas realist este să rulezi același audit pe modelele tale interne, nu doar pe modelul mic de test. Înlocuiești MODEL_ID cu directorul sau identificatorul tău și păstrezi aceleași verificări pentru config, tokenizer și pipeline.
Pentru modele mari, adaugă audit separat pentru dtype, device_map și formatul greutăților. Pentru pipeline-uri de producție, salvează un set mic de intrări reprezentative și verifică schema răspunsului, nu doar faptul că inferența pornește.
Întrebări frecvente
De ce folosim un model tiny, nu modelul real din producție?
Modelul tiny face tutorialul rapid și reproductibil. După ce structura funcționează, aplici aceleași scripturi pe directorul modelului tău intern.
Verifică acest audit calitatea predicțiilor?
Nu. Auditul verifică încărcarea, tokenizarea și compatibilitatea pipeline-ului. Calitatea modelului trebuie evaluată separat, pe setul tău de test.
Este obligatoriu tokenizer.json pentru orice model?
În acest tutorial îl cerem pentru că folosim tokenizer fast și vrem o verificare strictă pentru migrare. Dacă ai un tokenizer special, regula trebuie documentată explicit în auditul proiectului.
Pot rula pașii pe GPU?
Tutorialul fixează CPU pentru reproductibilitate. Dacă folosești GPU, verificările rămân aceleași, dar trebuie să testezi separat device, device_map și memoria disponibilă.