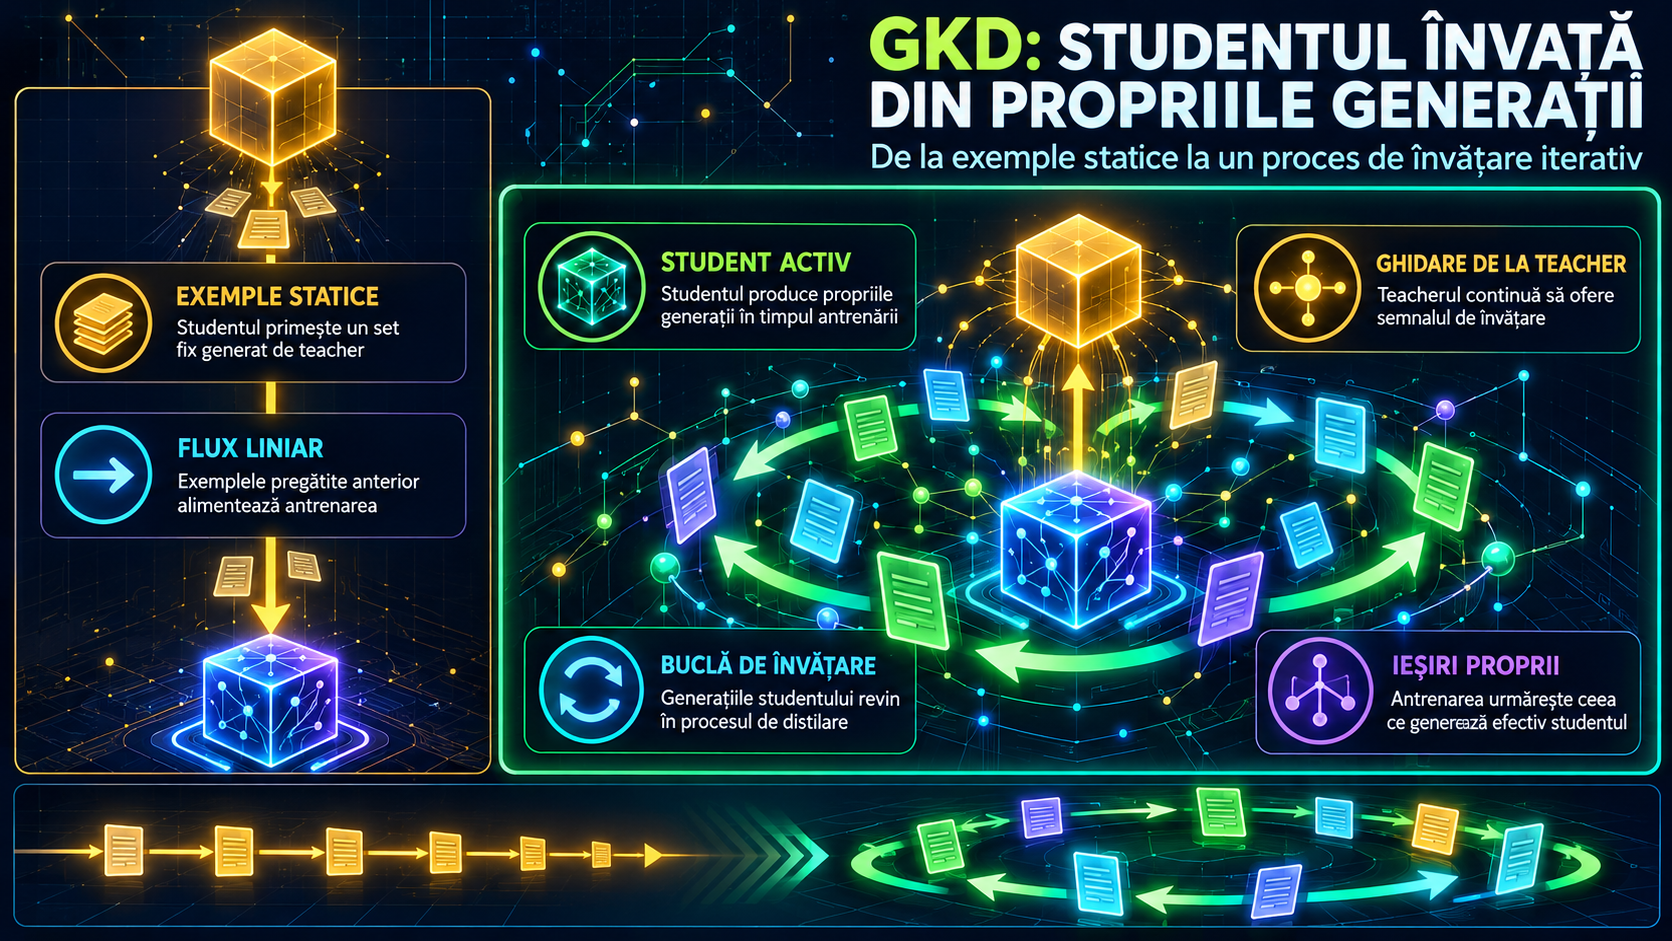
Studentul care rezumă greșit un proiect de lege ajunge într-o zonă de text pe care exemplele statice ale teacherului nu i-au arătat-o. În acest proiect îl lăsăm să genereze propriul răspuns, apoi cerem teacherului să evalueze distribuția tokenilor chiar pe acea secvență. La final comparăm această variantă on-policy cu un baseline care învață exclusiv din rezumate generate și salvate anterior de teacher.
Rezultatul verificabil este un student Qwen2.5-0.5B-Instruct antrenat pentru rezumarea documentelor legislative din BillSum, două directoare de model — artifacts/baseline și artifacts/gkd — și un tabel cu ROUGE-1, ROUGE-2 și ROUGE-L pe același set de test. Modelul GKD este apoi încărcat într-un API FastAPI local, cu o cerere de test care întoarce rezumatul și latența.
Acesta nu este același experiment ca distilarea GPT-2 pe WikiText-2 cu KLDivLoss. Acolo accentul cade pe imitarea distribuției teacherului pe exemple fixe; aici distribuția datelor de antrenare este modificată de răspunsurile curente ale studentului.
Fixăm laboratorul la două modele cu același tokenizer
Configurația folosită este:
- Ubuntu 24.04 LTS;
- Python 3.11;
- o placă NVIDIA cu minimum 24 GB VRAM și suport BF16;
Qwen/Qwen2.5-1.5B-Instructca teacher;Qwen/Qwen2.5-0.5B-Instructca student;- TRL 0.22.2;
- 1.400 de exemple BillSum: 1.000 pentru train, 200 pentru validare și 200 pentru test;
- seed global
47; - aproximativ 25 GB liberi pentru mediul Python, cache, modele și checkpointuri.
Teacherul și studentul provin din aceeași familie Qwen2.5 și folosesc același vocabular. Această compatibilitate contează deoarece pierderea GKD compară probabilitățile celor două modele la nivel de token.
Rezervă orientativ două-patru ore pe un GPU din clasa RTX 4090 pentru generarea setului static, cele două antrenări și evaluare. Durata depinde de frecvența GPU, răcire și viteza discului. Rularea integrală pe CPU nu este o țintă practică pentru acest laborator; verificarea API-ului se poate face pe CPU, dar antrenarea poate dura mai mult de o zi.
Verifică mediul înainte de descărcarea modelelor:
cat /etc/os-release
python3 --version
nvidia-smi
df -h .
Un rezultat compatibil va indica Ubuntu 24.04, Python 3.11, un GPU NVIDIA cu cel puțin 24 GB memorie și minimum 25 GB disponibili. Numele plăcii, versiunea driverului și spațiul exact vor fi diferite.
PRETTY_NAME="Ubuntu 24.04 LTS"
Python 3.11.x
NVIDIA-SMI ...  Memory-Usage: ... / 24564 MiB
Avail: cel puțin 25G
Punct de control: dacă nvidia-smi nu vede placa sau memoria totală este sub 24 GB, nu porni cele două modele simultan; remediază driverul ori mută proiectul pe o mașină compatibilă.
Instalăm stack-ul fix și construim arborele proiectului
Creează mediul și directoarele într-un singur bloc:
set -euo pipefail
mkdir -p gkd-billsum/{data,artifacts}
cd gkd-billsum
python3 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
Fișierul requirements.txt:
torch==2.7.1
transformers==4.56.2
trl==0.22.2
datasets==4.1.1
accelerate==1.10.1
rouge-score==0.1.2
fastapi==0.116.1
uvicorn==0.35.0
sentencepiece==0.2.1
Instalează și verifică versiunile:
set -euo pipefail
python -m pip install -r requirements.txt
python - <<'PY'
import datasets
import torch
import transformers
import trl

print("torch", torch.__version__)
print("transformers", transformers.__version__)
print("datasets", datasets.__version__)
print("trl", trl.__version__)
print("cuda", torch.cuda.is_available())
print("bf16", torch.cuda.is_bf16_supported())
PY
Outputul trebuie să conțină versiunile fixate și valorile True pentru CUDA și BF16:
torch 2.7.1
transformers 4.56.2
datasets 4.1.1
trl 0.22.2
cuda True
bf16 True
Structura completă va fi:
gkd-billsum/
├── requirements.txt       # versiunile reproductibile
├── prepare_data.py        # splituri și generații statice ale teacherului
├── train.py               # baseline SFT sau antrenare GKD on-policy
├── evaluate.py            # ROUGE, comparație și cazurile slabe
├── serve.py               # API FastAPI pentru modelul GKD
├── run_all.sh             # automatizarea întregului experiment
├── data/                  # fișiere JSONL produse local
└── artifacts/             # modele, metrici și analiza erorilor
Punct de control: dacă verificarea afișează alte versiuni, asigură-te că mediul .venv este activ și reinstalează cu python -m pip install --force-reinstall -r requirements.txt.
Pasul 1 — Separăm BillSum înainte ca teacherul să vadă testul
De ce: BillSum conține texte legislative și rezumate de referință. Facem o singură permutare cu seed fix și salvăm spliturile înainte de antrenare, astfel încât baseline-ul și GKD să fie evaluate pe exact aceleași 200 de documente.
Fișierul prepare_data.py:
import argparse
import json
from pathlib import Path

import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed

TEACHER_ID = "Qwen/Qwen2.5-1.5B-Instruct"
SEED = 47
SYSTEM = (
    "You summarize United States legislative documents. "
    "Return one concise factual paragraph. Do not add facts."
)


def write_jsonl(path: Path, rows: list[dict]) -> None:
    with path.open("w", encoding="utf-8") as handle:
        for row in rows:
            handle.write(json.dumps(row, ensure_ascii=False) + "n")


def conversation(text: str) -> list[dict[str, str]]:
    return [
        {"role": "system", "content": SYSTEM},
        {
            "role": "user",
            "content": "Summarize this legislative document:nn" + text,
        },
    ]


def generate_static_targets(rows: list[dict], batch_size: int) -> list[dict]:
    tokenizer = AutoTokenizer.from_pretrained(TEACHER_ID)
    model = AutoModelForCausalLM.from_pretrained(
        TEACHER_ID,
        torch_dtype=torch.bfloat16,
    ).to("cuda")
    model.eval()

    output_rows = []
    for start in range(0, len(rows), batch_size):
        batch = rows[start : start + batch_size]
        chats = [row["prompt"] for row in batch]
        encoded = tokenizer.apply_chat_template(
            chats,
            tokenize=True,
            add_generation_prompt=True,
            padding=True,
            truncation=True,
            max_length=1024,
            return_tensors="pt",
            return_dict=True,
        )
        encoded = {key: value.to("cuda") for key, value in encoded.items()}

        with torch.inference_mode():
            generated = model.generate(
                **encoded,
                do_sample=False,
                max_new_tokens=160,
                pad_token_id=tokenizer.pad_token_id,
                eos_token_id=tokenizer.eos_token_id,
            )

        prompt_width = encoded["input_ids"].shape[1]
        completions = tokenizer.batch_decode(
            generated[:, prompt_width:],
            skip_special_tokens=True,
        )

        for row, completion in zip(batch, completions, strict=True):
            output_rows.append(
                {
                    "prompt": row["prompt"],
                    "completion": [
                        {"role": "assistant", "content": completion.strip()}
                    ],
                    "reference": row["reference"],
                    "title": row["title"],
                }
            )

        print(f"static targets: {len(output_rows)}/{len(rows)}")

    return output_rows


def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--output-dir", default="data")
    parser.add_argument("--batch-size", type=int, default=4)
    args = parser.parse_args()

    if not torch.cuda.is_available():
        raise RuntimeError("CUDA is required to generate teacher targets.")
    if not torch.cuda.is_bf16_supported():
        raise RuntimeError("This configuration requires CUDA BF16 support.")

    set_seed(SEED)
    output_dir = Path(args.output_dir)
    output_dir.mkdir(parents=True, exist_ok=True)

    source = load_dataset("FiscalNote/billsum", split="train")
    selected = source.shuffle(seed=SEED).select(range(1400))

    rows = [
        {
            "prompt": conversation(example["text"]),
            "completion": [
                {"role": "assistant", "content": example["summary"].strip()}
            ],
            "reference": example["summary"].strip(),
            "title": example["title"],
        }
        for example in selected
    ]

    train_rows = rows[:1000]
    validation_rows = rows[1000:1200]
    test_rows = rows[1200:1400]

    write_jsonl(output_dir / "train.jsonl", train_rows)
    write_jsonl(output_dir / "validation.jsonl", validation_rows)
    write_jsonl(output_dir / "test.jsonl", test_rows)

    static_rows = generate_static_targets(train_rows, args.batch_size)
    write_jsonl(output_dir / "train_static.jsonl", static_rows)

    manifest = {
        "dataset": "FiscalNote/billsum",
        "teacher": TEACHER_ID,
        "seed": SEED,
        "train": len(train_rows),
        "validation": len(validation_rows),
        "test": len(test_rows),
        "static_train": len(static_rows),
    }
    (output_dir / "manifest.json").write_text(
        json.dumps(manifest, indent=2),
        encoding="utf-8",
    )
    print(json.dumps(manifest, indent=2))


if __name__ == "__main__":
    main()
Rulează:
python prepare_data.py --output-dir data --batch-size 4max_length=1024 limitează intrarea, iar max_new_tokens=160 limitează rezumatul. do_sample=False face generațiile statice deterministe pentru același stack și același hardware. Datele de test nu sunt trimise teacherului în această etapă.
La final trebuie să existe patru fișiere JSONL și manifestul:
static targets: 1000/1000
{
  "dataset": "FiscalNote/billsum",
  "teacher": "Qwen/Qwen2.5-1.5B-Instruct",
  "seed": 47,
  "train": 1000,
  "validation": 200,
  "test": 200,
  "static_train": 1000
}
Punct de control: dacă numărul nu este 1000, șterge numai data/train_static.jsonl și reia comanda; nu schimba seed-ul sau ordinea spliturilor.
Pasul 2 — Antrenăm baseline-ul pe răspunsurile înghețate ale teacherului
De ce: baseline-ul trebuie să izoleze problema urmărită. Studentul primește cele 1.000 de răspunsuri produse o singură dată de teacher și nu generează secvențe proprii în timpul antrenării.
Fișierul train.py:
import argparse
from pathlib import Path

import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed
from trl import GKDConfig, GKDTrainer, SFTConfig, SFTTrainer

STUDENT_ID = "Qwen/Qwen2.5-0.5B-Instruct"
TEACHER_ID = "Qwen/Qwen2.5-1.5B-Instruct"
SEED = 47


def load_json(path: str):
    return load_dataset("json", data_files=path, split="train")


def common_arguments(output: str) -> dict:
    return {
        "output_dir": output,
        "num_train_epochs": 1,
        "per_device_train_batch_size": 1,
        "gradient_accumulation_steps": 16,
        "learning_rate": 2e-5,
        "warmup_ratio": 0.05,
        "lr_scheduler_type": "cosine",
        "max_length": 1536,
        "bf16": True,
        "gradient_checkpointing": True,
        "gradient_checkpointing_kwargs": {"use_reentrant": False},
        "logging_steps": 10,
        "save_steps": 100,
        "save_total_limit": 2,
        "report_to": "none",
        "seed": SEED,
        "data_seed": SEED,
    }


def train_baseline(output: str) -> None:
    tokenizer = AutoTokenizer.from_pretrained(STUDENT_ID)
    model = AutoModelForCausalLM.from_pretrained(
        STUDENT_ID,
        torch_dtype=torch.bfloat16,
    )
    model.config.use_cache = False

    config = SFTConfig(
        **common_arguments(output),
        completion_only_loss=True,
    )
    trainer = SFTTrainer(
        model=model,
        args=config,
        train_dataset=load_json("data/train_static.jsonl"),
        processing_class=tokenizer,
    )
    trainer.train()
    trainer.save_model(output)
    tokenizer.save_pretrained(output)


def train_gkd(output: str) -> None:
    tokenizer = AutoTokenizer.from_pretrained(STUDENT_ID)
    student = AutoModelForCausalLM.from_pretrained(
        STUDENT_ID,
        torch_dtype=torch.bfloat16,
    )
    teacher = AutoModelForCausalLM.from_pretrained(
        TEACHER_ID,
        torch_dtype=torch.bfloat16,
    )
    student.config.use_cache = False
    teacher.eval()
    for parameter in teacher.parameters():
        parameter.requires_grad_(False)

    config = GKDConfig(
        **common_arguments(output),
        lmbda=1.0,
        beta=0.5,
        temperature=0.9,
        seq_kd=False,
    )
    trainer = GKDTrainer(
        model=student,
        teacher_model=teacher,
        args=config,
        train_dataset=load_json("data/train.jsonl"),
        processing_class=tokenizer,
    )
    trainer.train()
    trainer.save_model(output)
    tokenizer.save_pretrained(output)


def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument(
        "--mode",
        required=True,
        choices=["baseline", "gkd"],
    )
    parser.add_argument("--output", required=True)
    args = parser.parse_args()

    if not torch.cuda.is_available():
        raise RuntimeError("CUDA is required for this training configuration.")
    if not torch.cuda.is_bf16_supported():
        raise RuntimeError("CUDA BF16 support is required.")

    Path(args.output).mkdir(parents=True, exist_ok=True)
    set_seed(SEED)

    if args.mode == "baseline":
        train_baseline(args.output)
    else:
        train_gkd(args.output)


if __name__ == "__main__":
    main()
Pornește baseline-ul:
python train.py --mode baseline --output artifacts/baselinecompletion_only_loss=True exclude promptul din pierderea SFT. Batch-ul efectiv este 16, obținut dintr-un exemplu pe GPU și 16 acumulări. gradient_checkpointing reduce memoria activă cu prețul recalculării unor activări.
Outputul exact al pierderii diferă, dar finalul trebuie să includă statistici de antrenare și să producă artifacts/baseline/config.json:
{'train_runtime': ..., 'train_loss': ..., 'epoch': 1.0}Punct de control: confirmă existența fișierului cu test -f artifacts/baseline/config.json; fără el, baseline-ul nu este pregătit pentru evaluare.
Pasul 3 — Mutăm feedbackul teacherului pe traiectoria studentului
De ce: lmbda=1.0 selectează ieșiri on-policy generate de student. Teacherul nu îi furnizează doar un text final de copiat, ci probabilități pentru tokenii întâlniți pe secvența produsă de student. beta=0.5 folosește punctul median al interpolării generalized Jensen–Shannon, iar temperature=0.9 controlează variația generațiilor studentului.
Rulează aceeași inițializare de student, dar cu trainerul GKD:
python train.py --mode gkd --output artifacts/gkdAceastă comandă folosește data/train.jsonl, nu train_static.jsonl. Referința umană rămâne în fișier pentru trasabilitate, însă configurația complet on-policy este controlată de lmbda=1.0.
GKD este util tocmai când studentul își vizitează propriile stări de generare. Nu garantează însă un scor ROUGE mai mare într-un experiment mic. Dacă studentul produce secvențe foarte slabe, teacherul oferă feedback într-o regiune slabă; dacă teacherul nu este bun pe domeniul legislativ, GKD poate transfera și limitele lui. Din acest motiv păstrăm testul uman separat și nu alegem câștigătorul după loss-ul de train.
Dacă vrei să aprofundezi diferența dintre schimbarea comportamentului și schimbarea bazei lingvistice, compară acest flux cu continued pretraining cu replay. Acolo modelul continuă să învețe din text brut; aici teacherul ghidează distribuția ieșirilor pentru o sarcină precisă.
La final trebuie să apară configurația studentului GKD:
{'train_runtime': ..., 'train_loss': ..., 'epoch': 1.0}
artifacts/gkd/config.json
artifacts/gkd/tokenizer_config.json
Punct de control: rulează test -f artifacts/gkd/config.json; dacă fișierul lipsește, nu trece la comparație.
Pasul 4 — Calculăm ROUGE pe referințele pe care antrenarea nu le-a văzut
De ce: aceeași funcție de generare trebuie aplicată ambelor modele. Calculăm ROUGE față de rezumatele BillSum, salvăm toate predicțiile și extragem cele mai slabe zece exemple GKD după ROUGE-L.
Fișierul evaluate.py:
import json
from pathlib import Path

import torch
from datasets import load_dataset
from rouge_score import rouge_scorer
from transformers import AutoModelForCausalLM, AutoTokenizer, set_seed

SEED = 47
MODELS = {
    "baseline": "artifacts/baseline",
    "gkd": "artifacts/gkd",
}


def generate(model_path: str, rows) -> list[str]:
    tokenizer = AutoTokenizer.from_pretrained(model_path)
    model = AutoModelForCausalLM.from_pretrained(
        model_path,
        torch_dtype=torch.bfloat16,
    ).to("cuda")
    model.eval()

    predictions = []
    for index, row in enumerate(rows):
        encoded = tokenizer.apply_chat_template(
            row["prompt"],
            tokenize=True,
            add_generation_prompt=True,
            truncation=True,
            max_length=1024,
            return_tensors="pt",
            return_dict=True,
        )
        encoded = {key: value.to("cuda") for key, value in encoded.items()}

        with torch.inference_mode():
            output = model.generate(
                **encoded,
                do_sample=False,
                max_new_tokens=160,
                pad_token_id=tokenizer.pad_token_id,
                eos_token_id=tokenizer.eos_token_id,
            )

        prompt_length = encoded["input_ids"].shape[1]
        prediction = tokenizer.decode(
            output[0, prompt_length:],
            skip_special_tokens=True,
        ).strip()
        predictions.append(prediction)
        print(f"{Path(model_path).name}: {index + 1}/{len(rows)}")

    del model
    torch.cuda.empty_cache()
    return predictions


def score_predictions(references, predictions):
    scorer = rouge_scorer.RougeScorer(
        ["rouge1", "rouge2", "rougeL"],
        use_stemmer=True,
    )
    totals = {"rouge1": 0.0, "rouge2": 0.0, "rougeL": 0.0}
    per_example = []

    for reference, prediction in zip(references, predictions, strict=True):
        scores = scorer.score(reference, prediction)
        row = {
            name: scores[name].fmeasure
            for name in totals
        }
        per_example.append(row)
        for name, value in row.items():
            totals[name] += value

    count = len(predictions)
    averages = {
        name: value / count
        for name, value in totals.items()
    }
    return averages, per_example


def main() -> None:
    if not torch.cuda.is_available():
        raise RuntimeError("CUDA is required by this evaluation script.")

    set_seed(SEED)
    output_dir = Path("artifacts/evaluation")
    output_dir.mkdir(parents=True, exist_ok=True)

    test = load_dataset(
        "json",
        data_files="data/test.jsonl",
        split="train",
    )
    references = list(test["reference"])
    results = {}
    all_predictions = {}

    for name, path in MODELS.items():
        predictions = generate(path, test)
        averages, per_example = score_predictions(
            references,
            predictions,
        )
        results[name] = averages
        all_predictions[name] = {
            "texts": predictions,
            "scores": per_example,
        }

    lines = [
        "| Model | ROUGE-1 | ROUGE-2 | ROUGE-L |",
        "|---|---:|---:|---:|",
    ]
    for name in MODELS:
        row = results[name]
        lines.append(
            f"| {name} | {row['rouge1']:.4f} | "
            f"{row['rouge2']:.4f} | {row['rougeL']:.4f} |"
        )
    table = "n".join(lines)
    print(table)

    (output_dir / "metrics.json").write_text(
        json.dumps(results, indent=2),
        encoding="utf-8",
    )
    (output_dir / "comparison.md").write_text(
        table + "n",
        encoding="utf-8",
    )

    records = []
    for index, row in enumerate(test):
        records.append(
            {
                "index": index,
                "title": row["title"],
                "reference": row["reference"],
                "baseline": all_predictions["baseline"]["texts"][index],
                "gkd": all_predictions["gkd"]["texts"][index],
                "gkd_rougeL": all_predictions["gkd"]["scores"][index]["rougeL"],
            }
        )

    weakest = sorted(records, key=lambda item: item["gkd_rougeL"])[:10]
    (output_dir / "weakest_gkd.json").write_text(
        json.dumps(weakest, indent=2, ensure_ascii=False),
        encoding="utf-8",
    )


if __name__ == "__main__":
    main()
Rulează:
python evaluate.py
cat artifacts/evaluation/comparison.md
Forma rezultatului este fixă, dar valorile trebuie citite din execuția locală, nu copiate dintr-un exemplu:
| Model | ROUGE-1 | ROUGE-2 | ROUGE-L |
|---|---:|---:|---:|
| baseline | valoare calculată | valoare calculată | valoare calculată |
| gkd | valoare calculată | valoare calculată | valoare calculată |
ROUGE măsoară suprapunerea lexicală, nu fidelitatea juridică în întregime. Deschide artifacts/evaluation/weakest_gkd.json și verifică trei tipuri de eșec: afirmații absente din referință, omiterea obiectului principal al proiectului și rezumate întrerupte la limita de tokeni.
Punct de control: comparația este validă numai dacă ambele rânduri au fost calculate pe 200 de exemple și weakest_gkd.json conține zece înregistrări.
Pasul 5 — Servim checkpointul GKD printr-un endpoint local
De ce: salvarea modelului nu demonstrează că artefactul poate fi reîncărcat independent. API-ul validează textul primit, aplică același chat template și întoarce o singură generație deterministă.
Fișierul serve.py:
import time
from contextlib import asynccontextmanager

import torch
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_PATH = "artifacts/gkd"
SYSTEM = (
    "You summarize United States legislative documents. "
    "Return one concise factual paragraph. Do not add facts."
)

tokenizer = None
model = None


class SummaryRequest(BaseModel):
    text: str = Field(min_length=50, max_length=20000)


class SummaryResponse(BaseModel):
    summary: str
    latency_seconds: float


@asynccontextmanager
async def lifespan(app: FastAPI):
    global tokenizer, model
    tokenizer = AutoTokenizer.from_pretrained(MODEL_PATH)
    dtype = (
        torch.bfloat16
        if torch.cuda.is_available() and torch.cuda.is_bf16_supported()
        else torch.float32
    )
    model = AutoModelForCausalLM.from_pretrained(
        MODEL_PATH,
        torch_dtype=dtype,
    )
    device = "cuda" if torch.cuda.is_available() else "cpu"
    model.to(device)
    model.eval()
    yield
    del model


app = FastAPI(title="BillSum GKD", lifespan=lifespan)


@app.get("/health")
def health():
    return {
        "status": "ok",
        "model": MODEL_PATH,
        "device": next(model.parameters()).device.type,
    }


@app.post("/summarize", response_model=SummaryResponse)
def summarize(request: SummaryRequest):
    messages = [
        {"role": "system", "content": SYSTEM},
        {
            "role": "user",
            "content": "Summarize this legislative document:nn" + request.text,
        },
    ]
    encoded = tokenizer.apply_chat_template(
        messages,
        tokenize=True,
        add_generation_prompt=True,
        truncation=True,
        max_length=1024,
        return_tensors="pt",
        return_dict=True,
    )
    device = next(model.parameters()).device
    encoded = {key: value.to(device) for key, value in encoded.items()}

    started = time.perf_counter()
    with torch.inference_mode():
        output = model.generate(
            **encoded,
            do_sample=False,
            max_new_tokens=160,
            pad_token_id=tokenizer.pad_token_id,
            eos_token_id=tokenizer.eos_token_id,
        )
    latency = time.perf_counter() - started

    prompt_length = encoded["input_ids"].shape[1]
    summary = tokenizer.decode(
        output[0, prompt_length:],
        skip_special_tokens=True,
    ).strip()
    if not summary:
        raise HTTPException(status_code=500, detail="Model returned empty text.")

    return SummaryResponse(
        summary=summary,
        latency_seconds=round(latency, 3),
    )
Pornește serviciul numai pe interfața locală:
uvicorn serve:app --host 127.0.0.1 --port 8000Din alt terminal, testează starea și inferența:
curl --fail http://127.0.0.1:8000/health
curl --fail
  -H 'Content-Type: application/json'
  -d '{"text":"The proposed measure establishes a grant program for public agencies, defines annual reporting duties, and authorizes appropriations for the program."}'
  http://127.0.0.1:8000/summarize
Forma răspunsului trebuie să fie:
{"status":"ok","model":"artifacts/gkd","device":"cuda"}
{"summary":"...","latency_seconds":...}
Textul concret și latența diferă între sisteme. Endpointul nu este expus în rețea și nu include autentificare; pentru acest laborator rămâne legat de 127.0.0.1.
Punct de control: un status diferit de 200 trebuie investigat în terminalul unde rulează Uvicorn, nu mascat prin eliminarea validării.
Automatizăm traseul complet fără a amesteca rezultatele
Fișierul run_all.sh:
#!/usr/bin/env bash
set -euo pipefail

source .venv/bin/activate

python prepare_data.py --output-dir data --batch-size 4
python train.py --mode baseline --output artifacts/baseline
python train.py --mode gkd --output artifacts/gkd
python evaluate.py

test -f data/manifest.json
test -f artifacts/baseline/config.json
test -f artifacts/gkd/config.json
test -f artifacts/evaluation/metrics.json
test -f artifacts/evaluation/weakest_gkd.json

printf '%sn' "Experiment completed."
cat artifacts/evaluation/comparison.md
Acordă permisiune și rulează:
chmod 750 run_all.sh
./run_all.sh
Ultimele linii trebuie să conțină Experiment completed. și tabelul celor două modele. Scriptul se oprește la prima comandă eșuată datorită set -euo pipefail.
Punct de control: nu considera experimentul încheiat dacă există doar checkpointuri intermediare; cele cinci comenzi test -f confirmă artefactele necesare.
Cinci defecțiuni specifice acestui pipeline
ImportError: cannot import name 'GKDConfig' from 'trl'
Cauza este o versiune TRL diferită de cea fixată sau instalarea în alt mediu Python. Verifică și reinstalează:
source .venv/bin/activate
python -m pip install --force-reinstall "trl==0.22.2"
python -c "from trl import GKDConfig, GKDTrainer; print('GKD OK')"
torch.OutOfMemoryError: CUDA out of memory.
Teacherul și studentul nu încap împreună cu activările. Confirmă că alte procese nu ocupă placa:
nvidia-smiOprește procesele proprii care folosesc GPU-ul. Dacă eroarea apare la generarea țintelor statice, reia cu:
python prepare_data.py --output-dir data --batch-size 1Pentru GKD, configurația articolului cere 24 GB VRAM; mutarea pe o placă mai mică schimbă experimentul.
RuntimeError: This configuration requires CUDA BF16 support.
Placa nu expune BF16 în PyTorch sau stack-ul CUDA nu este funcțional. Verificarea exactă este:
python -c "import torch; print(torch.cuda.is_available(), torch.cuda.is_bf16_supported())"Ambele valori trebuie să fie True. Nu schimba automat în FP16: aceasta ar modifica regimul numeric și ar cere o validare separată.
OSError: Qwen/Qwen2.5-1.5B-Instruct is not a local folder and is not a valid model identifier
Modelul nu a putut fi rezolvat în Hugging Face Hub, de obicei din cauza conectivității, a unui cache incomplet sau a identificatorului modificat. Testează explicit descărcarea configurației:
python -c "from transformers import AutoConfig; print(AutoConfig.from_pretrained('Qwen/Qwen2.5-1.5B-Instruct').model_type)"Rezultatul așteptat este qwen2. Repornește pregătirea numai după ce această comandă reușește.
ValueError: Model returned empty text.
Mesajul provine din API, după o generație fără conținut decodabil. Verifică întâi că artifacts/gkd este checkpointul final și că evaluarea a produs texte:
test -f artifacts/gkd/generation_config.json
python evaluate.py
Dacă și predicțiile din evaluare sunt goale, nu elimina excepția din API; checkpointul sau antrenarea trebuie refăcute.
Ștergem separat modelele, datele și mediul Python
Oprește Uvicorn cu Ctrl+C. Avertisment: următoarele comenzi șterg checkpointurile și datele descărcate ale proiectului. Rulează-le numai din rădăcina gkd-billsum.
set -euo pipefail
test -f requirements.txt
rm -rf artifacts data
rm -f prepare_data.py train.py evaluate.py serve.py run_all.sh
deactivate 2>/dev/null || true
rm -rf .venv
Cache-ul Hugging Face din directorul utilizatorului nu este eliminat, deoarece poate fi folosit de alte proiecte. Fișiere de configurare ale sistemului nu au fost modificate, deci nu există un .bak de restaurat.
Lista de acceptanță pentru experimentul GKD
- ☐ Manifestul fixează seed-ul
47și spliturile1000/200/200. - ☐ Baseline-ul folosește
data/train_static.jsonl. - ☐ GKD folosește
data/train.jsonlșilmbda=1.0. - ☐ Teacherul rămâne în modul evaluare și are gradientul dezactivat.
- ☐ Ambele modele pornesc din
Qwen2.5-0.5B-Instruct. - ☐ Evaluarea folosește aceleași 200 de referințe pentru ambele checkpointuri.
- ☐ Tabelul ROUGE este produs de script, nu completat manual.
- ☐ Cele mai slabe zece generații GKD sunt salvate pentru inspecție.
- ☐ API-ul încarcă
artifacts/gkddupă încheierea procesului de train. - ☐ Serviciul ascultă numai pe
127.0.0.1.
Următoarele experimente care separă efectul on-policy
Prima extensie este un ablation cu lmbda=0.0, 0.5 și 1.0, păstrând seed-ul, spliturile și bugetul de pași. Astfel măsori tranziția dintre datele fixe și generațiile studentului fără a schimba simultan restul pipeline-ului.
A doua este evaluarea factualității cu un evaluator separat, nu doar ROUGE. Un reward model trebuie însă antrenat și calibrat distinct; fluxul pentru perechi de preferințe este explicat în tutorialul despre Reward Model chosen–rejected.
A treia este mărirea setului de train, urmată de sequence packing doar după ce ai verificat izolarea exemplelor. Pentru mecanismul care împiedică attention-ul să traverseze documentele, vezi ghidul despre Sequence Packing avansat.
Întrebări frecvente
De ce nu folosim direct rezumatele BillSum ca baseline?
Comparația urmărește diferența dintre exemple teacher statice și feedback teacher pe generațiile studentului. Baseline-ul este de aceea antrenat pe cele 1.000 de rezumate generate și salvate anterior de teacher.
GKD garantează un ROUGE mai mare?
Nu. Rezultatul depinde de calitatea teacherului, secvențele vizitate de student, date și bugetul de antrenare; scriptul calculează comparația pe același set de test fără să presupună câștigătorul.
De ce trebuie teacherul și studentul să folosească același tokenizer?
Pierderea compară distribuțiile lor la nivel de token. Modelele Qwen2.5 alese în proiect folosesc același vocabular, evitând o mapare suplimentară între spații de tokeni.
API-ul poate fi expus direct pe internet?
Nu în forma prezentată. Serviciul ascultă pe 127.0.0.1, nu are autentificare și este destinat exclusiv verificării locale a checkpointului.