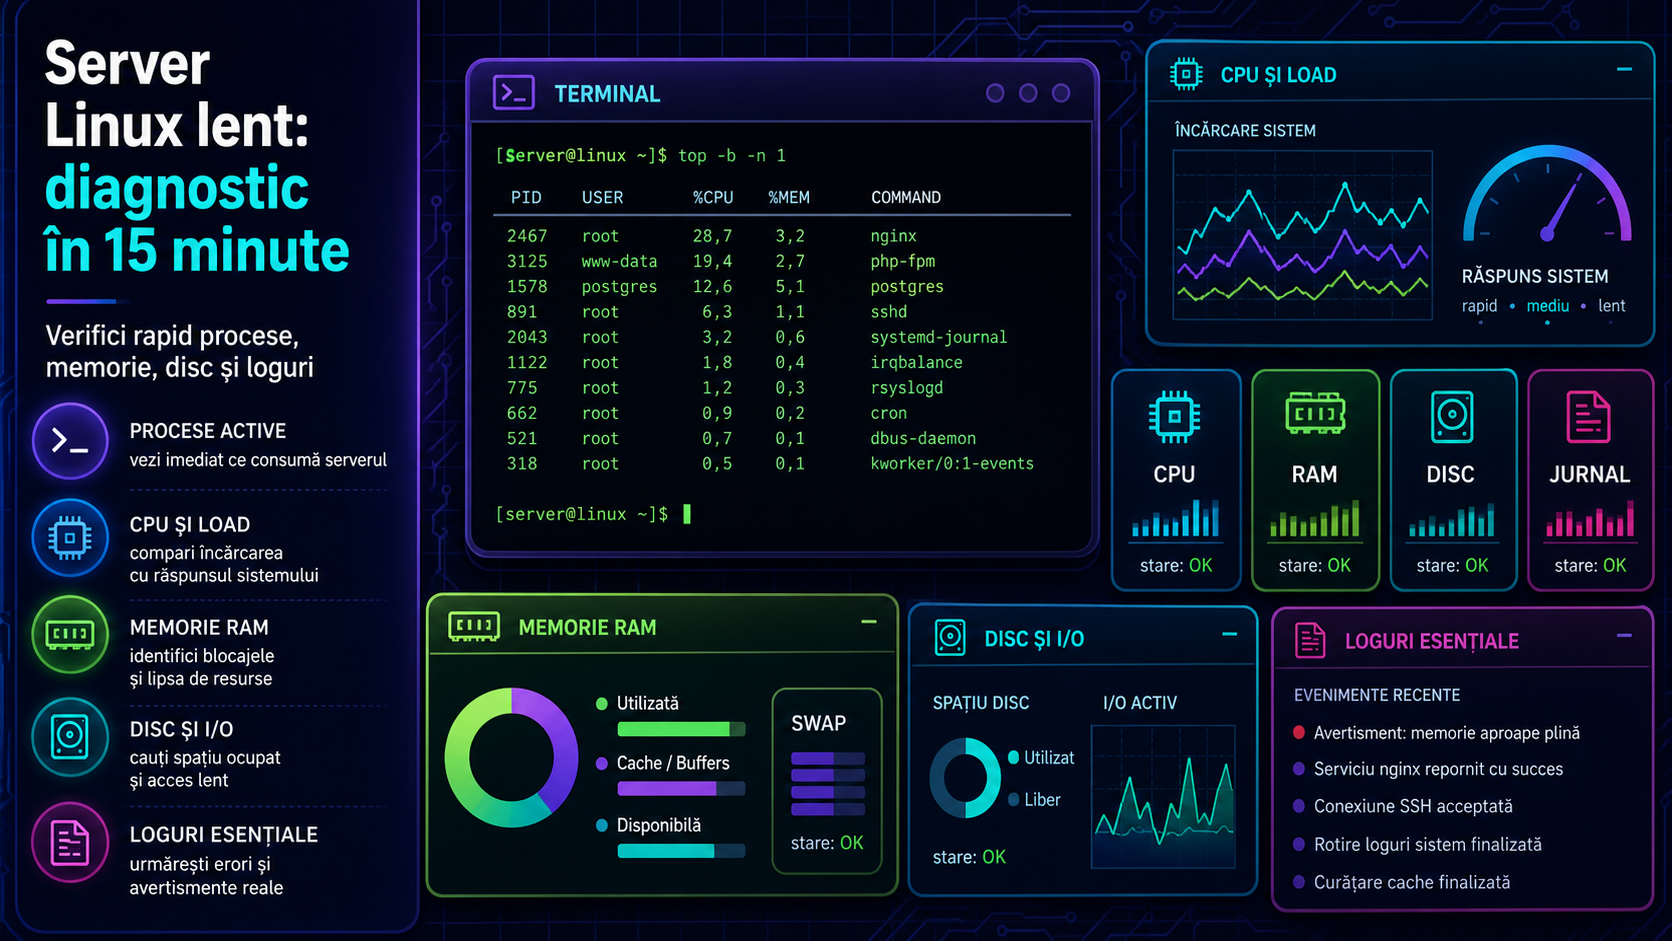
Când un server Linux începe să răspundă greu, tentația este să repornești servicii la întâmplare sau să cauți imediat „vinovatul” în aplicație. De multe ori, asta doar ascunde problema pentru scurt timp. O abordare mai bună este un diagnostic scurt, ordonat și repetabil. Cu câteva comenzi standard, poți afla în aproximativ 15 minute dacă blocajul vine din încărcare mare, memorie insuficientă, disc lent, loguri pline de erori sau un serviciu care s-a dezechilibrat.
Primul pas este să verifici imaginea de ansamblu. Comanda uptime îți arată de cât timp rulează serverul și, mai important, load average pentru ultimele 1, 5 și 15 minute. Documentația explică faptul că acest indicator reprezintă media proceselor care rulează sau așteaptă resurse. Dacă valorile cresc constant și depășesc clar numărul de CPU-uri disponibile, ai un prim semn că serverul este sub presiune. Imediat după, top te ajută să vezi procesele active, utilizarea CPU și rezumatul pentru memorie și swap.
În primele trei minute, uită-te la două lucruri: dacă unul sau câteva procese consumă neobișnuit de mult CPU și dacă sistemul stă mult în așteptare. În top contează nu doar procesele din vârf, ci și imaginea generală: CPU ocupat, memorie disponibilă și swap folosit. Dacă vezi un singur proces care urcă agresiv, ai o pistă clară. Dacă nu, treci la pasul următor.
Între minutele 3 și 6, verifică memoria. Comanda free -h este una dintre cele mai utile, pentru că arată memoria fizică și swap-ul într-un format ușor de citit. Un detaliu important din documentație este coloana available, care estimează câtă memorie mai poate folosi sistemul fără să intre în swapping serios. Dacă available este foarte mic, iar swap-ul începe să fie folosit intens, serverul poate părea „înghețat” chiar dacă procesorul nu este la 100%. Pentru confirmare rapidă, rulează vmstat 1 5. Dacă valorile si și so arată activitate constantă de swap, problema este probabil lipsa de memorie sau un proces care o consumă excesiv.
Între minutele 6 și 9, verifică discul. Multe servere „grele” nu au, de fapt, o problemă de CPU, ci de I/O. Tot vmstat este util, pentru că raportează block I/O și timpul de așteptare pentru I/O prin coloana wa. Dacă wa rămâne ridicat, sistemul așteaptă discul. Apoi merită să folosești iostat pentru statistici CPU și I/O pe dispozitive: dacă un device apare foarte ocupat sau volumele de citire și scriere sar brusc, ai găsit o zonă critică. În paralel, verifică și spațiul cu df -h și, la nevoie, inode-urile cu df -i. Un filesystem aproape plin poate încetini aplicațiile, logarea și taskurile automate.
Între minutele 9 și 12, caută semnale în loguri, nu presupuneri. journalctl este instrumentul standard pentru jurnalele systemd și permite filtrare după boot, interval sau prioritate. Asta înseamnă că poți căuta exact erorile recente, nu tot istoricul. În practică, merită verificat dacă au apărut mesaje repetitive despre disc, memorie, servicii căzute, timeout-uri sau procese omorâte de kernel. Dacă serverul a început să meargă greu „de azi dimineață”, logurile din boot-ul curent sau din ultimele 15-30 de minute sunt adesea mai valoroase decât o investigație lungă și haotică.
Ultimele minute sunt pentru confirmare și prioritizare. Dacă ai identificat un proces care consumă CPU, nu te opri la simptom: întreabă-te dacă este un job de backup, indexare, actualizare, compresie sau o aplicație blocată. Dacă problema este memoria, verifică ce serviciu a crescut anormal și dacă există swap intens. Dacă problema este discul, vezi dacă încetinirea apare la backupuri, baze de date, loguri prea mari sau stocare aproape plină. Ideea nu este să „umbli” imediat la toate serviciile, ci să separi cauza principală de efectele secundare.
Metoda aceasta funcționează tocmai pentru că este simplă: uptime pentru context, top pentru procese, free și vmstat pentru memorie, iostat și df pentru stocare, journalctl pentru dovezi. Într-un sfert de oră poți trece de la impresia vagă că „serverul merge greu” la un diagnostic mult mai clar. Iar dacă problema persistă, ai deja baza corectă pentru următorul pas: optimizare, upgrade de resurse sau analiză mai profundă pe serviciul afectat.
Surse
- https://man7.org/linux/man-pages/man1/uptime.1.html
- https://man7.org/linux/man-pages/man1/top.1.html
- https://man7.org/linux/man-pages/man8/vmstat.8.html
- https://man7.org/linux/man-pages/man1/free.1.html
- https://man7.org/linux/man-pages/man1/df.1.html
- https://man7.org/linux/man-pages/man1/iostat.1.html
- https://www.freedesktop.org/software/systemd/man/latest/journalctl.html