În recrutarea pentru roluri AI, întrebarea importantă nu mai este dacă un candidat știe să scrie prompturi spectaculoase, ci dacă poate construi ceva care poate fi verificat, rulat din nou și explicat clar. Aici începe diferența dintre un demo convingător și o contribuție reală într-o echipă.
Semnalul este vizibil și în documentația publică a unor companii și platforme folosite frecvent în ecosistemul AI. Anthropic vorbește despre soluții simple, compozabile, și despre compromisurile dintre performanță, cost și latență. MLflow și Weights & Biases insistă pe urmărirea experimentelor, a parametrilor, metricilor și artifactelor. Hugging Face tratează documentația și model cards ca elemente esențiale pentru reproductibilitate și înțelegerea limitelor unui proiect.
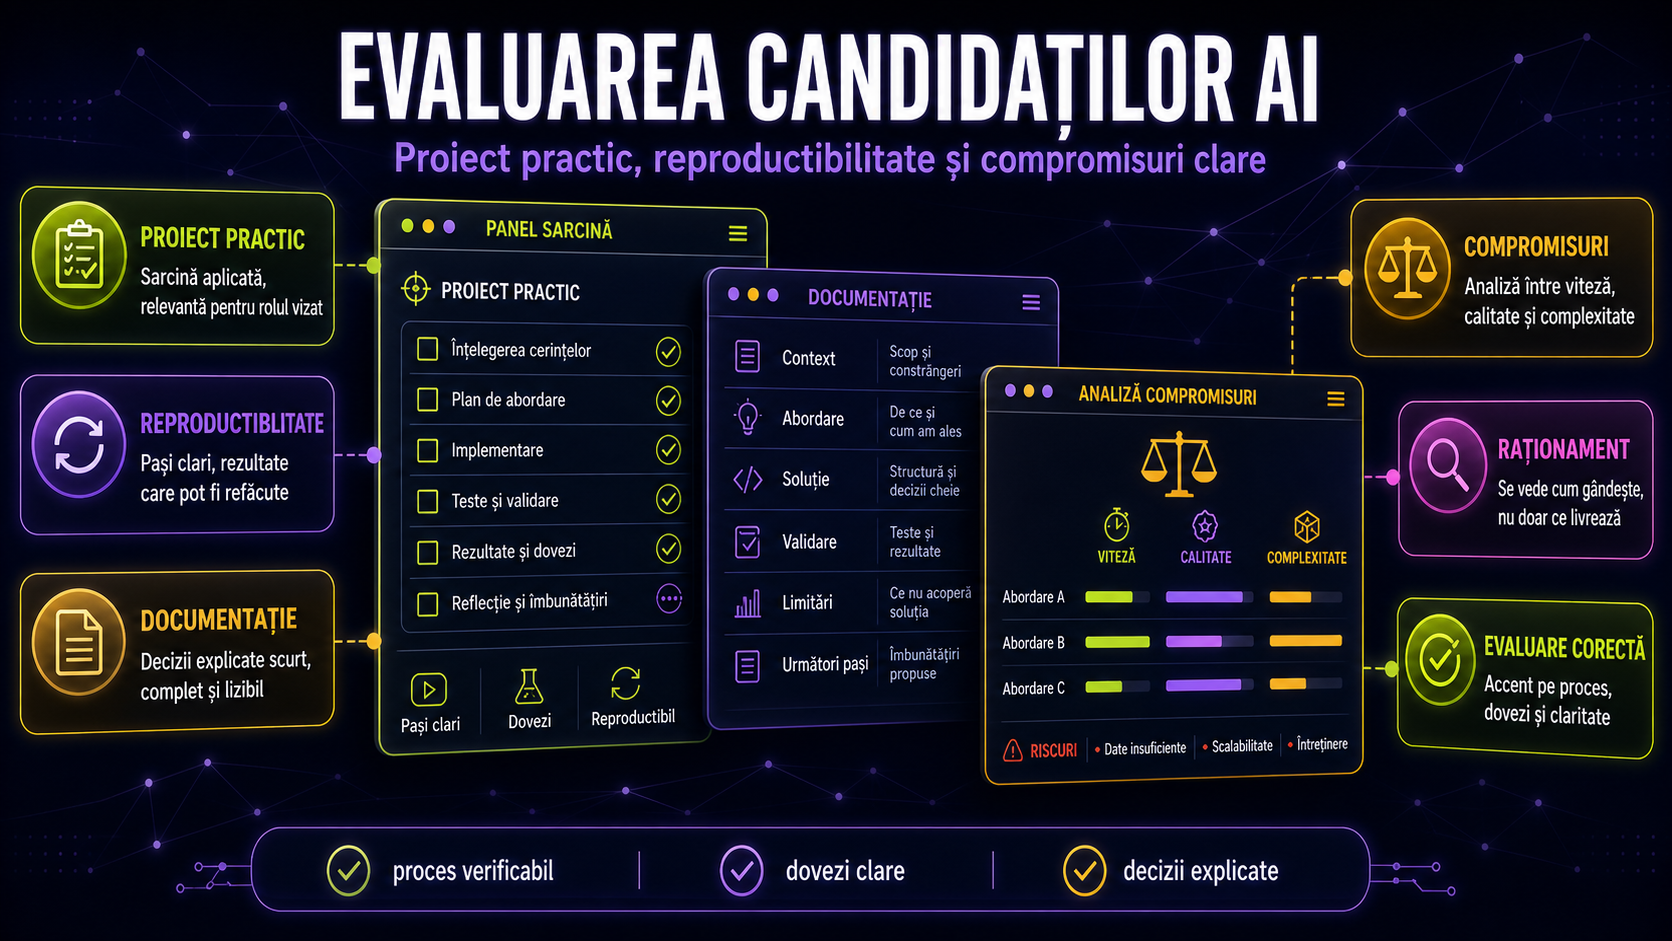
Proiectul practic spune mai mult decât testul teoretic
Pentru un rol AI orientat spre livrare, un exercițiu bun seamănă mai puțin cu un test clasic de interviu și mai mult cu o problemă mică, dar realistă. Poate fi un task de clasificare, evaluarea a două variante de pipeline, documentarea unui flux cu LLM sau compararea a două abordări pentru aceeași cerință.
Avantajul unui proiect practic este simplu: scoate imediat la suprafață cum gândește candidatul. Se vede cum definește obiectivul, ce criterii de evaluare alege, cum își organizează pașii și cum reacționează când rezultatul nu este perfect. În AI, asta contează mai mult decât un răspuns fluent într-o discuție de 30 de minute.
Un proiect bine ales îi obligă pe candidați să demonstreze și partea mai puțin spectaculoasă, dar esențială: structură, claritate și disciplină. Exact aici apar diferențele reale între cineva care poate face o demonstrație rapidă și cineva care poate livra într-un context de lucru.
Reproducibilitatea a devenit un filtru de maturitate
Un proiect AI care nu poate fi reprodus ridică imediat un semn de întrebare. Dacă evaluatorul nu poate înțelege ce model a fost folosit, ce setări au contat, ce date au intrat în test și cum s-a ajuns la rezultat, atunci valoarea exercițiului scade mult.
MLflow descrie clar tracking-ul experimentelor ca logare de parametri, versiuni de cod, metrici și fișiere rezultate. Weights & Biases merge în aceeași direcție și pune accent pe experimente, comparația între run-uri și artifacte. Pentru recrutare, mesajul este direct: un candidat puternic nu vine doar cu capturi de ecran sau cu un notebook care a mers o singură dată, ci cu pași clari de rerulare.
Asta nu înseamnă că orice exercițiu trebuie transformat într-un proces complicat. Înseamnă doar că evaluatorul ar trebui să poată vedea logic ce s-a făcut și să refacă, măcar în linii mari, rezultatul. Dacă acest lucru lipsește, există riscul ca interviul să premieze prezentarea, nu munca reală.
Documentația nu mai este opțională
Mulți candidați tratează documentația ca pe un detaliu cosmetic. În practică, ea este una dintre cele mai utile probe de lucru. Hugging Face explică foarte clar rolul model cards: ele trebuie să spună ce face modelul, care sunt utilizările recomandate, ce limitări are, pe ce date s-a lucrat și ce rezultate de evaluare există.
Același principiu se aplică și în recrutare. Un README bun, chiar și scurt, spune enorm despre nivelul real al unui candidat. Dacă persoana poate explica pe scurt cum rulezi proiectul, ce intrări a folosit, cum citești rezultatele și unde sunt limitele, atunci există șanse mari să înțeleagă bine propria soluție.
Dacă nu poate face asta, problema nu este doar de formă. De multe ori, documentația slabă arată că soluția nu este suficient de clară nici pentru autorul ei. Iar într-o echipă, asta se transformă rapid în timp pierdut, erori și dificultăți de transfer.
Analiza compromisurilor separă executanții de oamenii care pot conduce
Poate cea mai utilă parte a evaluării nu este rezultatul brut, ci discuția despre compromisuri. De ce a fost ales un model mai ieftin sau mai rapid? De ce a fost preferat un workflow simplu în locul unuia mai complex? De ce a fost acceptată o acuratețe ceva mai mică pentru costuri sau latență mai bune?
Anthropic notează explicit că sistemele simple și compozabile sunt adesea mai eficiente decât framework-urile complicate și că merită analizat atent schimbul dintre calitate, cost și viteză. Într-un interviu AI, exact acest tip de discuție ar trebui să conteze.
Candidatul care poate explica aceste alegeri arată că înțelege munca reală, nu doar partea demonstrativă. El nu spune doar „uite ce am făcut”, ci și „uite de ce am mers pe drumul acesta și ce am sacrificat”. Pentru un angajator, acesta este un semnal mult mai valoros decât un rezultat strălucitor, dar slab explicat.
Ce merită urmărit într-o evaluare bună
Pentru firmele care angajează în AI, criteriile utile sunt deja destul de clare: un proiect mic, dar complet; pași de rulare; rezultate comparabile; metrici explicate; limitări declarate; și o discuție sinceră despre compromisuri.
Ce merită evitat? Exercițiile făcute doar pentru viteză, task-urile fără criterii clare și interviurile care confundă ambalajul cu substanța. În AI, este foarte ușor să fii impresionat de un output interesant. Este mult mai greu, dar și mult mai sănătos, să verifici dacă acel output poate fi explicat, refăcut și susținut într-un context de lucru real.