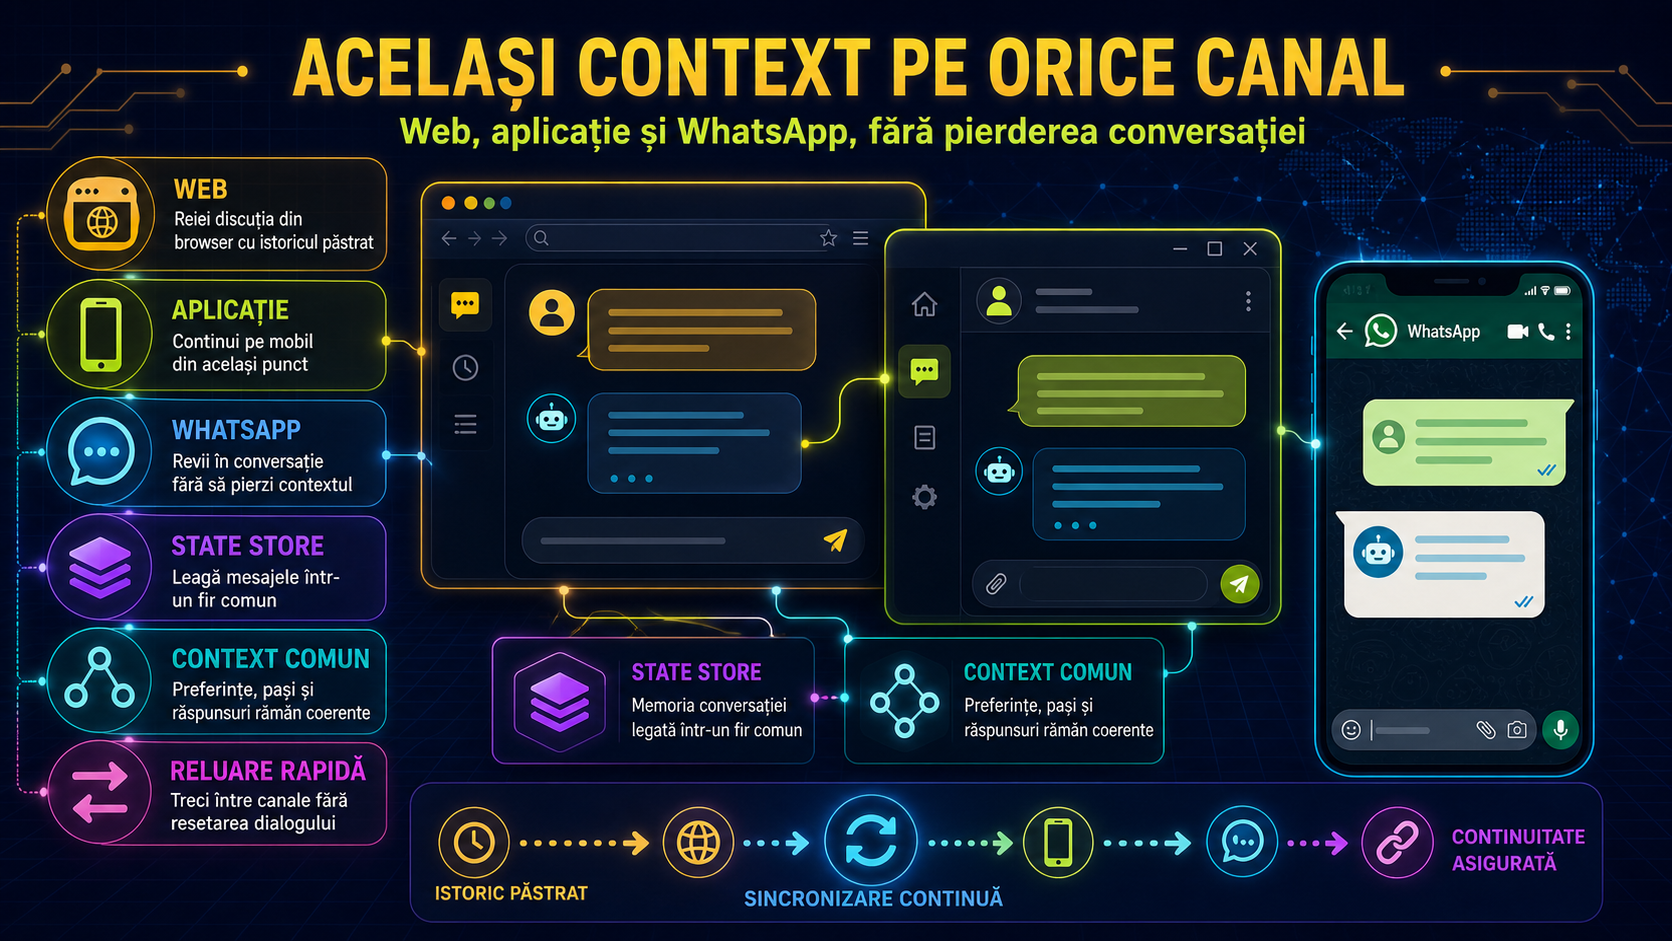
Când o firmă spune că vrea „același asistent AI” pe site, în aplicația mobilă și pe WhatsApp, de obicei nu caută doar încă un chatbot. Caută continuitate. Clientul începe o întrebare pe web, revine din telefon câteva ore mai târziu, apoi trimite un mesaj pe WhatsApp și se așteaptă să nu explice totul de la zero. Aici intră în joc ideea de conversation state store, adică un strat de stocare a stării conversației care ajută sistemul să reia discuția cu contextul potrivit.
Pe înțelesul firmelor, un conversation state store nu este „memorie magică”. Este o combinație de identificatori, istoric relevant, preferințe, rezumate și reguli de acces păstrate într-un backend propriu sau într-o platformă care oferă conversații persistente. OpenAI descrie în documentația sa pentru Conversation State posibilitatea de a lega răspunsurile între ele prin previous_response_id, iar Microsoft explică un principiu important pentru astfel de sisteme: botul este, în esență, stateless pe fiecare tură, iar starea trebuie gestionată separat. Cu alte cuvinte, continuitatea nu apare singură în interfață, ci din felul în care proiectezi infrastructura.
Beneficiul principal este experiența mai coerentă. Dacă un client a spus deja ce produs folosește, ce problemă are și ce pas a încercat, asistentul nu ar trebui să ceară aceleași informații la fiecare canal. Pentru echipele de suport și vânzări, asta înseamnă timpi mai mici, mai puține conversații abandonate și mai puține răspunsuri contradictorii. În plus, un state store bine proiectat poate păstra nu doar mesajele, ci și rezumate operaționale: statusul unei cereri, limba preferată, ultimele documente trimise sau faptul că utilizatorul a fost deja transferat către un agent uman.
Important însă: continuitatea între web, aplicație și WhatsApp nu înseamnă automat că toate canalele „se sincronizează singure”. În practică, ai nevoie de un backend care să știe când două interacțiuni aparțin aceleiași persoane și când nu. Twilio explică în documentația sa pentru WhatsApp cu Conversations că există scenarii cross-channel, dar asta nu înseamnă că orice implementare are identitate unificată din start. Dacă legi greșit identitatea, riști exact opusul unei experiențe bune: să amesteci conversațiile a doi oameni diferiți sau să expui istoricul greșit pe canalul greșit.
Aici apar limitele reale. Prima este rezolvarea identității. Un email de pe site, un cont din aplicație și un număr de WhatsApp pot aparține aceleiași persoane, dar nu ar trebui unite fără o regulă clară și fără temei operațional. A doua limită este calitatea memoriei. Dacă sistemul salvează un rezumat greșit, eroarea se propagă pe toate canalele. A treia este dimensiunea contextului: nu tot istoricul trebuie retrimis modelului la fiecare mesaj. De multe ori, este mai sănătos să păstrezi un rezumat verificat și câteva date cheie, nu transcriptul complet la nesfârșit.
Din perspectiva protecției datelor, acesta este punctul unde multe proiecte se complică. GDPR pune accent pe data minimisation, storage limitation și data protection by design and by default. Pentru firme, asta se traduce simplu: păstrezi doar ce îți trebuie, pentru cât timp îți trebuie și separi clar datele sensibile de restul contextului conversațional. Nu este suficient să spui „AI-ul ține minte”. Trebuie să decizi explicit ce se salvează, cine poate vedea acea stare, cine o poate modifica și când se șterge.
De aceea, politicile de retenție trebuie definite înainte de lansare, nu după primul incident. Unele platforme au propriile reguli de persistență. De exemplu, OpenAI notează că response objects sunt salvate 30 de zile în mod implicit și că acest comportament poate fi schimbat cu store=false, în timp ce obiectele de conversație au propriul regim de persistență. Dacă firma folosește mai mulți furnizori, trebuie să verifice separat unde rămân datele, ce loguri sunt păstrate și ce opțiuni are pentru ștergere sau audit.
La implementare sau selecție, merită urmărite câteva bune practici. Separă conversațiile pe cont, utilizator, canal și caz de business, nu într-o singură „memorie” comună. Definește permisiuni stricte pentru accesul intern la transcripturi și rezumate. Verifică informațiile sensibile înainte să fie reutilizate de asistent, mai ales date de facturare, date personale și decizii comerciale. Evită ca modelul să trateze orice mesaj vechi ca adevăr permanent. Și cere furnizorului răspunsuri clare despre retenție, export, ștergere, jurnalizare și controlul accesului.
Pentru o firmă din România, concluzia practică este aceasta: un conversation state store poate face diferența dintre un chatbot fragmentat și un asistent AI coerent între web, aplicație și WhatsApp. Dar valoarea lui nu stă în promisiunea că „ține minte tot”, ci în disciplina cu care alegi ce context merită păstrat, cât timp îl păstrezi, cui îi dai acces și cum previi amestecarea conversațiilor. Continuitatea bună nu înseamnă memorie maximă, ci context util, limitat și controlat.