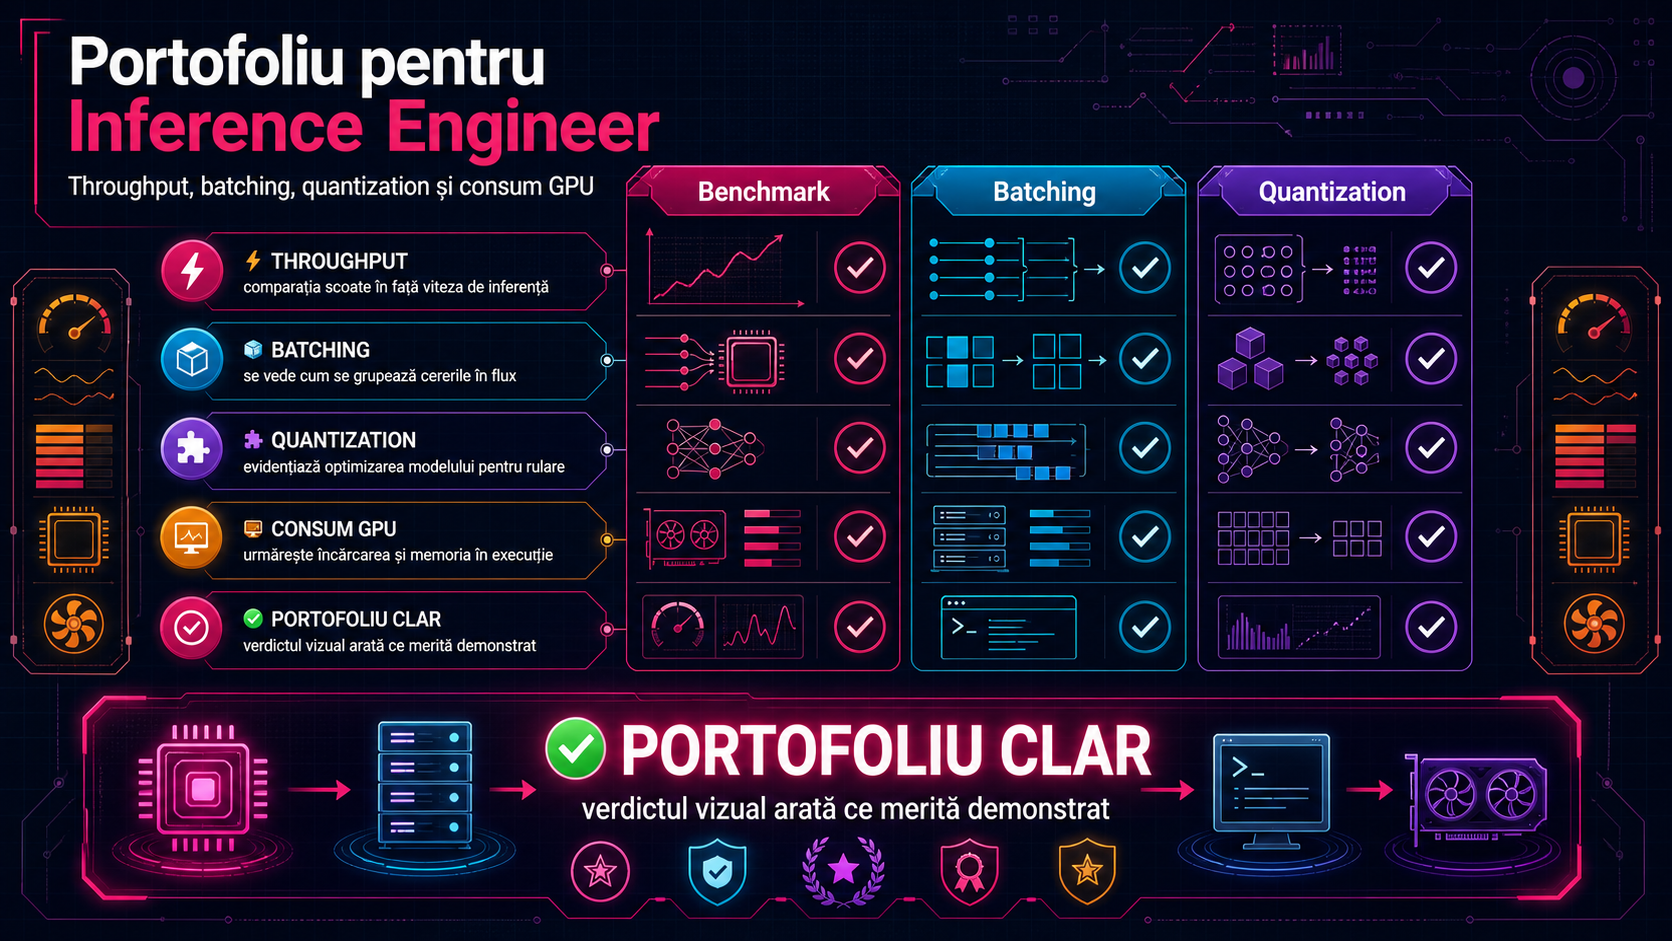
Dacă vrei un rol de Inference Engineer, simplul fapt că ai rulat un model local nu mai impresionează aproape pe nimeni. În 2026, recrutorii și echipele tehnice caută dovezi că înțelegi ce se întâmplă între „modelul merge” și „modelul poate fi servit eficient, stabil și predictibil”. Un portofoliu bun arată exact asta: cum măsori throughput-ul, cum testezi batching-ul, ce câștigi sau pierzi prin quantization și cum urmărești consumul real de GPU.
Primul lucru pe care ar trebui să-l demonstrezi este că știi să definești corect problema. Pentru un model de inferență, nu e suficient să spui că „merge repede”. Ai nevoie de metrici clare: latență, throughput, memorie ocupată și stabilitate sub încărcare. În practică, throughput-ul poate însemna cereri pe secundă sau tokeni pe secundă, în funcție de tipul aplicației. Dacă lucrezi cu LLM-uri, e util să separi testele pentru latență mică și testele pentru volum mare, pentru că aceleași setări nu optimizează întotdeauna ambele obiective.
Un proiect de portofoliu convingător poate porni de la aceeași sarcină rulată în trei variante: model de bază, model cu batching și model cuantizat. De exemplu, poți alege un model open-source servit prin Triton, vLLM sau ONNX Runtime și să documentezi exact ce se schimbă între scenarii. NVIDIA arată în documentația Triton că batcherele sunt folosite pentru a combina cereri de inferență și pentru a crește throughput-ul. Asta înseamnă că, pentru portofoliu, nu contează doar să activezi batching-ul, ci să arăți ce batch sizes ai testat, unde apare câștigul și din ce punct începe să crească prea mult latența.
A doua piesă importantă este metodologia. Nu impresionează o captură de ecran izolată, ci un experiment repetabil. Explică mediul de test: modelul, GPU-ul, driverele, framework-ul, lungimea inputului, numărul de cereri concurente și setările de batching. Dacă folosești vLLM, ai un avantaj bun de portofoliu: documentația proiectului include un CLI dedicat pentru benchmark de throughput, iar opțiunile sale separă destul de clar modurile orientate spre interactivitate de cele orientate spre volum. Asta te ajută să arăți că știi diferența dintre un demo rapid și un serviciu optimizat pentru trafic real.
Quantization este partea unde mulți candidați promit prea mult. În realitate, cuantizarea nu este un buton magic. Documentația ONNX Runtime explică limpede că există quantization dinamică și statică, că pot exista pierderi de acuratețe și că performanța depinde de model și de hardware. Pentru un portofoliu serios, nu spune doar „am trecut la INT8 și a fost mai bine”. Arată comparativ: dimensiunea modelului, throughput înainte și după, memoria consumată și orice impact observat asupra calității ieșirii. Dacă poți, menționează și de ce ai ales o anumită metodă: de exemplu, quantization dinamică pentru anumite modele transformer sau cuantizare statică atunci când ai date bune de calibrare.
La fel de important este consumul GPU. Un Inference Engineer nu optimizează în orb. NVIDIA descrie nvidia-smi ca utilitar pentru management și monitorizare a dispozitivelor GPU, iar asta îl face perfect pentru capturi și loguri simple în portofoliu. Nu trebuie să transformi proiectul într-un raport academic, dar merită să incluzi măcar utilizarea GPU, memoria ocupată și comportamentul sub sarcină. Ideal, pui datele într-un tabel mic sau într-un grafic: batch 1, 4, 8, 16; throughput, latență, memorie, utilizare GPU. Așa se vede imediat dacă optimizarea chiar ajută sau doar mută problema în altă parte.
Mai este un detaliu care face diferența: explicarea compromisurilor. În unele cazuri, batching mai agresiv crește throughput-ul, dar lovește în latența percepută de utilizator. În alte cazuri, quantization reduce memoria, dar nu aduce automat și cel mai bun rezultat pe orice GPU. Iar pentru unele sarcini, varianta optimă pentru demo nu este aceeași cu varianta potrivită pentru producție. Dacă notezi aceste limite clar, portofoliul tău pare matur și credibil.
Ce apreciază cel mai mult un hiring manager? Claritatea deciziilor. De ce ai ales acel runtime? De ce ai oprit creșterea batch-ului la un anumit prag? De ce ai păstrat o variantă FP16 lângă una cuantizată? Dacă explici aceste alegeri, portofoliul tău începe să semene cu munca reală din producție, nu cu un exercițiu de laborator.
Pe scurt, un portofoliu bun pentru Inference Engineer nu arată doar că poți porni un model, ci că poți măsura, compara și justifica. Dacă livrezi benchmark-uri de throughput, experimente de batching, teste de quantization și monitorizare de GPU într-un format curat și repetabil, ai deja un exemplu mult mai credibil decât multe CV-uri pline de buzzword-uri.