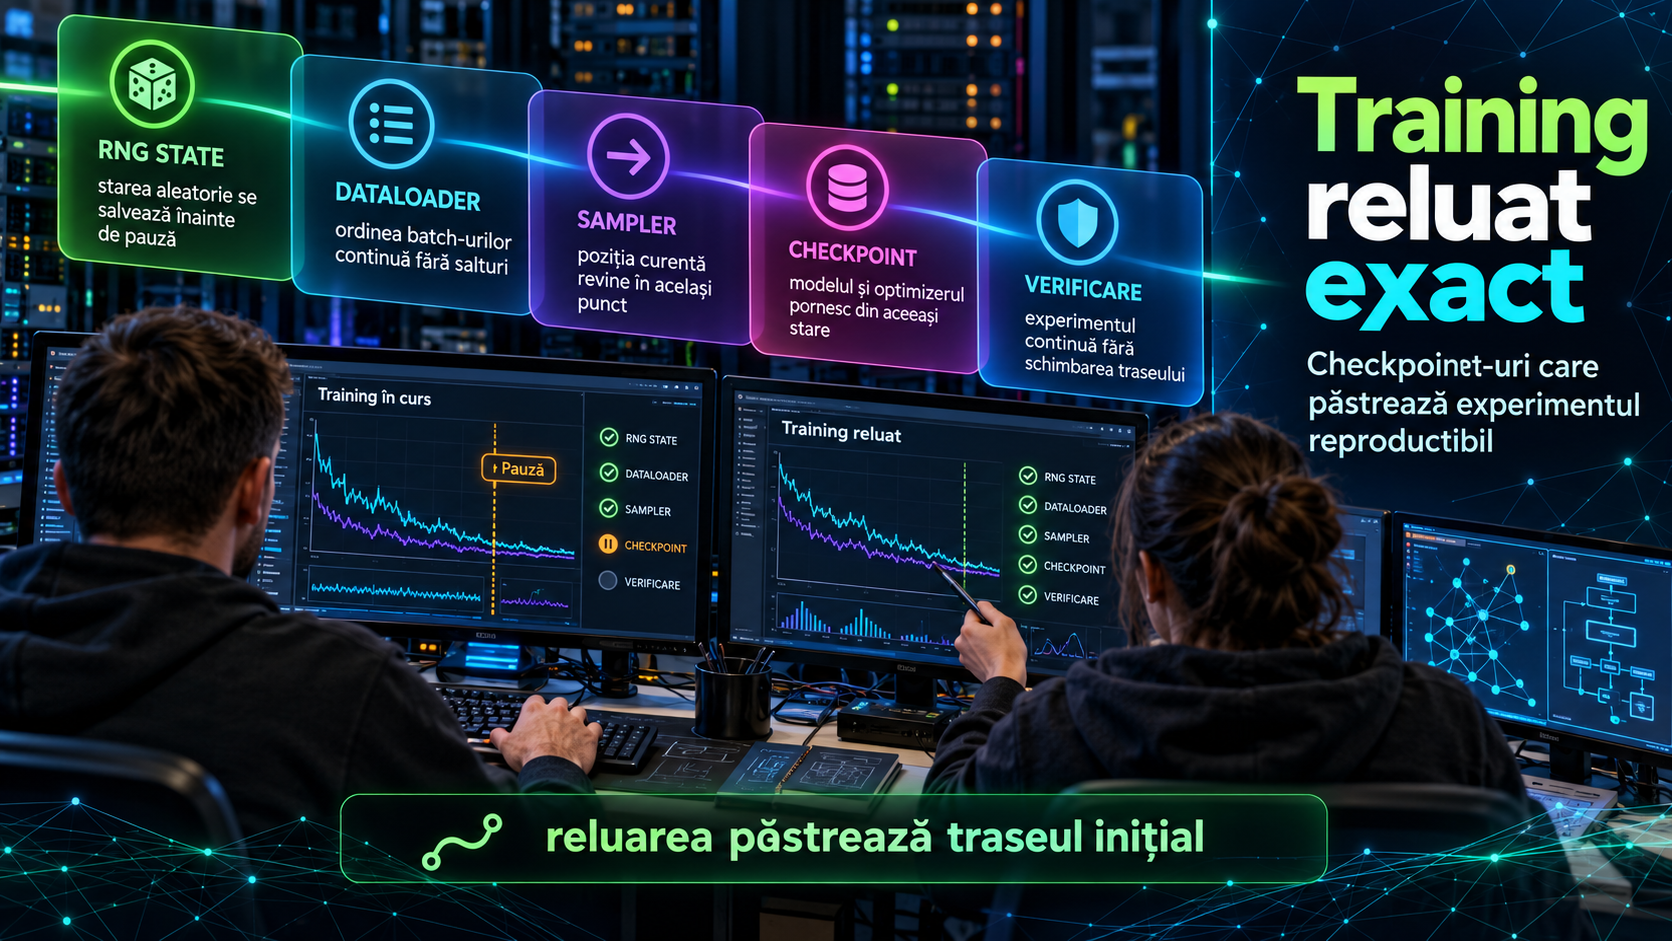
Trainingul AI nu trebuie să „continue aproximativ” după o întrerupere. În proiectele serioase, diferența dintre un resume real și unul superficial poate schimba ordinea batch-urilor, valorile loss-ului și rezultatul final. În acest tutorial construim un experiment PyTorch complet, pe CPU, în care întrerupem trainingul, salvăm starea RNG, samplerul, modelul, optimizerul și continuăm până obținem același model ca într-o rulare neîntreruptă.
Vom lucra cu un dataset real din scikit-learn, load_breast_cancer, doar ca problemă de clasificare binară reproductibilă. Accentul nu este pe performanța modelului, ci pe infrastructura de reluare exactă. Pentru proiecte mai mari, aceeași disciplină se combină natural cu ideile din Data Mixture Engineering pentru ponderarea dataseturilor AI și cu sisteme distribuite precum TorchElastic pentru training distribuit.
Ce construim
Construim un mini-proiect PyTorch care antrenează un model MLP pe datasetul Breast Cancer Wisconsin inclus în scikit-learn. Scriptul rulează patru moduri: training complet neîntrerupt, training întrerupt controlat, resume din checkpoint și verificare finală.
Rezultatul concret este fișierul artifacts/report.json, care confirmă că modelul antrenat cu întrerupere plus resume are aceleași greutăți ca modelul antrenat cap-coadă. Checkpointul salvează explicit starea Python random, NumPy, PyTorch, generatorul samplerului, poziția curentă din permutarea datasetului, modelul și optimizerul.
Mediul exact
Folosește Ubuntu Server 24.04 LTS sau Ubuntu 24.04 Desktop, Python 3.11, PyTorch 2.4.1 CPU, NumPy 2.1.1 și scikit-learn 1.5.2. Tutorialul este intenționat pe CPU, cu num_workers=0, ca să izolăm reproductibilitatea fără variabile suplimentare de GPU sau worker multiprocessing.
Resurse minime: 2 GB RAM, 1 CPU, 500 MB spațiu liber. Timp estimat: 20-30 de minute. Dacă vrei ulterior să duci ideea spre training lung sau distribuit, compară abordarea locală de aici cu checkpointingul de execuție din agent AI cu memorie persistentă în LangGraph.
Ce îți trebuie
Instalează pachetele într-un virtual environment curat. Comenzile de mai jos folosesc pachetul CPU oficial PyTorch și versiuni fixate pentru reproductibilitate.
mkdir -p ~/resume-exact-pytorch
cd ~/resume-exact-pytorch
python3.11 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install torch==2.4.1 --index-url https://download.pytorch.org/whl/cpu
python -m pip install numpy==2.1.1 scikit-learn==1.5.2
python - <<'PY'
import torch, numpy, sklearn
print("torch", torch.__version__)
print("numpy", numpy.__version__)
print("sklearn", sklearn.__version__)
PY
Ce trebuie să vezi:
torch 2.4.1+cpu
numpy 2.1.1
sklearn 1.5.2
Pasul 1: creăm scriptul complet
Facem un singur fișier, train_resume_exact.py. El conține datasetul, modelul, samplerul cu stare, salvarea checkpointului, reluarea și verificarea.
cat > train_resume_exact.py <<'PY'
import argparse
import json
import os
import random
import shutil
from pathlib import Path

import numpy as np
import torch
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from torch import nn
from torch.utils.data import DataLoader, Dataset, Sampler


SEED = 20260926
TOTAL_STEPS = 24
BATCH_SIZE = 32
ARTIFACTS = Path("artifacts")


def set_all_rng(seed: int) -> None:
    random.seed(seed)
    np.random.seed(seed)
    torch.manual_seed(seed)
    torch.use_deterministic_algorithms(True)


def capture_rng_state() -> dict:
    return {
        "python": random.getstate(),
        "numpy": np.random.get_state(),
        "torch": torch.get_rng_state(),
    }


def restore_rng_state(state: dict) -> None:
    random.setstate(state["python"])
    np.random.set_state(state["numpy"])
    torch.set_rng_state(state["torch"])


class BreastCancerDataset(Dataset):
    def __init__(self, split: str):
        data = load_breast_cancer()
        x = data.data.astype(np.float32)
        y = data.target.astype(np.int64)

        train_x, test_x, train_y, test_y = train_test_split(
            x,
            y,
            test_size=0.2,
            random_state=SEED,
            stratify=y,
        )

        mean = train_x.mean(axis=0, keepdims=True)
        std = train_x.std(axis=0, keepdims=True)
        std[std == 0.0] = 1.0

        if split == "train":
            self.x = (train_x - mean) / std
            self.y = train_y
        elif split == "test":
            self.x = (test_x - mean) / std
            self.y = test_y
        else:
            raise ValueError("split must be train or test")

    def __len__(self) -> int:
        return int(self.y.shape[0])

    def __getitem__(self, index: int):
        return torch.tensor(self.x[index], dtype=torch.float32), torch.tensor(self.y[index], dtype=torch.long)


class StatefulPermutationSampler(Sampler[int]):
    def __init__(self, data_source: Dataset, seed: int):
        self.data_source = data_source
        self.generator = torch.Generator()
        self.generator.manual_seed(seed)
        self.permutation = []
        self.position = 0
        self.epoch = 0
        self.start_new_epoch()

    def start_new_epoch(self) -> None:
        self.permutation = torch.randperm(len(self.data_source), generator=self.generator).tolist()
        self.position = 0
        self.epoch += 1

    def __iter__(self):
        while self.position < len(self.permutation):
            index = self.permutation[self.position]
            self.position += 1
            yield index

    def __len__(self) -> int:
        return len(self.data_source) - self.position

    def state_dict(self) -> dict:
        return {
            "generator_state": self.generator.get_state(),
            "permutation": list(self.permutation),
            "position": int(self.position),
            "epoch": int(self.epoch),
        }

    def load_state_dict(self, state: dict) -> None:
        self.generator.set_state(state["generator_state"])
        self.permutation = list(state["permutation"])
        self.position = int(state["position"])
        self.epoch = int(state["epoch"])


class TinyClassifier(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(30, 32),
            nn.ReLU(),
            nn.Linear(32, 2),
        )

    def forward(self, x):
        return self.net(x)


def build_objects():
    train_ds = BreastCancerDataset("train")
    test_ds = BreastCancerDataset("test")
    sampler = StatefulPermutationSampler(train_ds, SEED)
    loader = DataLoader(train_ds, batch_size=BATCH_SIZE, sampler=sampler, num_workers=0)
    model = TinyClassifier()
    optimizer = torch.optim.AdamW(model.parameters(), lr=0.01, weight_decay=0.01)
    loss_fn = nn.CrossEntropyLoss()
    return train_ds, test_ds, sampler, loader, model, optimizer, loss_fn


def save_checkpoint(path: Path, model, optimizer, sampler, step: int, last_loss: float) -> None:
    path.parent.mkdir(parents=True, exist_ok=True)
    checkpoint = {
        "step": int(step),
        "last_loss": float(last_loss),
        "model": model.state_dict(),
        "optimizer": optimizer.state_dict(),
        "sampler": sampler.state_dict(),
        "rng": capture_rng_state(),
    }
    torch.save(checkpoint, path)


def load_checkpoint(path: Path, model, optimizer, sampler) -> tuple[int, float]:
    checkpoint = torch.load(path, map_location="cpu")
    model.load_state_dict(checkpoint["model"])
    optimizer.load_state_dict(checkpoint["optimizer"])
    sampler.load_state_dict(checkpoint["sampler"])
    restore_rng_state(checkpoint["rng"])
    return int(checkpoint["step"]), float(checkpoint["last_loss"])


def train_until(mode_dir: Path, stop_after: int | None, resume: bool) -> None:
    set_all_rng(SEED)
    _, test_ds, sampler, loader, model, optimizer, loss_fn = build_objects()
    ckpt_path = mode_dir / "checkpoint.pt"
    final_path = mode_dir / "final.pt"
    log_path = mode_dir / "train_log.jsonl"
    mode_dir.mkdir(parents=True, exist_ok=True)

    step = 0
    last_loss = 0.0

    if resume:
        step, last_loss = load_checkpoint(ckpt_path, model, optimizer, sampler)

    with log_path.open("a", encoding="utf-8") as log_file:
        while step < TOTAL_STEPS:
            if sampler.position >= len(sampler.permutation):
                sampler.start_new_epoch()

            made_progress = False
            for xb, yb in loader:
                model.train()
                optimizer.zero_grad(set_to_none=True)
                logits = model(xb)
                loss = loss_fn(logits, yb)
                loss.backward()
                optimizer.step()

                step += 1
                last_loss = float(loss.item())
                made_progress = True

                save_checkpoint(ckpt_path, model, optimizer, sampler, step, last_loss)
                log_file.write(json.dumps({
                    "step": step,
                    "loss": round(last_loss, 8),
                    "sampler_epoch": sampler.epoch,
                    "sampler_position": sampler.position,
                }, sort_keys=True) + "n")
                log_file.flush()

                if stop_after is not None and step == stop_after:
                    print(json.dumps({
                        "status": "interrupted_on_purpose",
                        "checkpoint": str(ckpt_path),
                        "step": step,
                        "sampler_position": sampler.position,
                    }, sort_keys=True))
                    return

                if step >= TOTAL_STEPS:
                    break

            if not made_progress:
                sampler.start_new_epoch()

    accuracy = evaluate(model, test_ds)
    torch.save({
        "model": model.state_dict(),
        "accuracy": accuracy,
        "final_step": step,
        "last_loss": last_loss,
    }, final_path)
    print(json.dumps({
        "status": "finished",
        "final": str(final_path),
        "accuracy": round(accuracy, 6),
        "final_step": step,
    }, sort_keys=True))


def evaluate(model, test_ds: Dataset) -> float:
    model.eval()
    loader = DataLoader(test_ds, batch_size=64, shuffle=False, num_workers=0)
    correct = 0
    total = 0
    with torch.no_grad():
        for xb, yb in loader:
            pred = model(xb).argmax(dim=1)
            correct += int((pred == yb).sum().item())
            total += int(yb.numel())
    return correct / total


def verify() -> None:
    full = torch.load(ARTIFACTS / "full" / "final.pt", map_location="cpu")
    resumed = torch.load(ARTIFACTS / "resume" / "final.pt", map_location="cpu")

    max_abs_diff = 0.0
    exact_match = True

    for key in full["model"]:
        a = full["model"][key]
        b = resumed["model"][key]
        if not torch.equal(a, b):
            exact_match = False
        diff = torch.max(torch.abs(a - b)).item()
        max_abs_diff = max(max_abs_diff, float(diff))

    report = {
        "exact_match": exact_match,
        "full_accuracy": full["accuracy"],
        "resumed_accuracy": resumed["accuracy"],
        "full_final_step": full["final_step"],
        "resumed_final_step": resumed["final_step"],
        "max_abs_parameter_diff": max_abs_diff,
    }

    ARTIFACTS.mkdir(parents=True, exist_ok=True)
    (ARTIFACTS / "report.json").write_text(json.dumps(report, indent=2, sort_keys=True), encoding="utf-8")
    print(json.dumps(report, sort_keys=True))


def clean() -> None:
    if ARTIFACTS.exists():
        shutil.rmtree(ARTIFACTS)
    print("cleaned artifacts")


def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--mode", choices=["clean", "full", "interrupt", "resume", "verify"], required=True)
    parser.add_argument("--stop-after", type=int, default=9)
    args = parser.parse_args()

    if args.mode == "clean":
        clean()
    elif args.mode == "full":
        train_until(ARTIFACTS / "full", stop_after=None, resume=False)
    elif args.mode == "interrupt":
        train_until(ARTIFACTS / "resume", stop_after=args.stop_after, resume=False)
    elif args.mode == "resume":
        train_until(ARTIFACTS / "resume", stop_after=None, resume=True)
    elif args.mode == "verify":
        verify()


if __name__ == "__main__":
    main()
PY
Ce trebuie să vezi:
Fișierul train_resume_exact.py există în directorul ~/resume-exact-pytorch.Samplerul este partea critică. DataLoaderul standard poate primi un sampler, dar dacă nu salvezi poziția din permutare, resume-ul va lua alt batch după întrerupere. În proiecte cu secvențe lungi, același principiu contează și când antrenarea folosește tehnici de împărțire a contextului, cum sunt cele explicate în Context Parallel și Ring Attention.
Pasul 2: rulăm baseline-ul neîntrerupt
Acum rulăm trainingul complet, fără oprire. Acesta va fi referința.
source .venv/bin/activate
python train_resume_exact.py --mode clean
python train_resume_exact.py --mode full
Ce trebuie să vezi:
cleaned artifacts
{"accuracy": 0.9..., "final": "artifacts/full/final.pt", "final_step": 24, "status": "finished"}
Valoarea exactă a acurateții poate depinde de platformă dacă schimbi versiunile, dar cu mediul fixat trebuie să rămână aceeași între rularea completă și rularea reluată.
Pasul 3: simulăm întreruperea trainingului
Pornim aceeași antrenare, dar o oprim controlat după 9 pași. Scriptul salvează checkpoint după fiecare pas de optimizer.
python train_resume_exact.py --mode interrupt --stop-after 9Ce trebuie să vezi:
{"checkpoint": "artifacts/resume/checkpoint.pt", "sampler_position": 288, "status": "interrupted_on_purpose", "step": 9}Checkpointul conține modelul, optimizerul, RNG state pentru Python, NumPy și PyTorch, plus permutarea și poziția samplerului. Fără aceste stări, trainingul ar continua „valid”, dar nu ar fi același experiment.
Pasul 4: reluăm din checkpoint
Acum continuăm exact din artifacts/resume/checkpoint.pt. Nu recreăm shuffle-ul de la zero și nu resetăm optimizerul.
python train_resume_exact.py --mode resumeCe trebuie să vezi:
{"accuracy": 0.9..., "final": "artifacts/resume/final.pt", "final_step": 24, "status": "finished"}Dacă final_step nu este 24, resume-ul nu a continuat până la același orizont de training. Dacă acuratețea diferă de baseline, nu trage încă o concluzie: verificarea reală este compararea exactă a parametrilor.
Pasul 5: verificăm că modelul este identic
Comparația finală citește artifacts/full/final.pt și artifacts/resume/final.pt, apoi verifică tensor cu tensor.
python train_resume_exact.py --mode verify
cat artifacts/report.json
Ce trebuie să vezi:
{"exact_match": true, "full_accuracy": 0.9..., "full_final_step": 24, "max_abs_parameter_diff": 0.0, "resumed_accuracy": 0.9..., "resumed_final_step": 24}Fișierul artifacts/report.json trebuie să conțină:
"exact_match": true
"max_abs_parameter_diff": 0.0
Aceasta este dovada că întreruperea și reluarea au produs același model ca rularea neîntreruptă.
Verificarea completă
Rulează tot fluxul de la zero, într-o singură secvență:
source .venv/bin/activate
python train_resume_exact.py --mode clean
python train_resume_exact.py --mode full
python train_resume_exact.py --mode interrupt --stop-after 9
python train_resume_exact.py --mode resume
python train_resume_exact.py --mode verify
Rezultatul așteptat este un raport final cu exact_match pe true și max_abs_parameter_diff egal cu 0.0. Dacă modifici BATCH_SIZE, TOTAL_STEPS, modelul sau versiunile pachetelor, repetă baseline-ul și resume-ul împreună; nu compara artefacte produse în configurații diferite.
Probleme frecvente
FileNotFoundError: artifacts/resume/checkpoint.pt
Cauză: ai rulat --mode resume înainte de --mode interrupt. Rezolvare:
python train_resume_exact.py --mode interrupt --stop-after 9
python train_resume_exact.py --mode resume
RuntimeError: Deterministic behavior was enabled...
Cauză: ai modificat scriptul și ai introdus o operație pentru care PyTorch nu poate garanta algoritm determinist în mediul tău. Rezolvare: revino la scriptul din tutorial și rulează pe CPU, fără operații noi.
python train_resume_exact.py --mode clean
python train_resume_exact.py --mode full
ModuleNotFoundError: No module named 'sklearn'
Cauză: virtual environmentul nu este activ sau pachetul nu a fost instalat. Rezolvare:
source .venv/bin/activate
python -m pip install numpy==2.1.1 scikit-learn==1.5.2
"exact_match": false
Cauză: ai schimbat seed-ul, versiunile, batch size-ul, totalul de pași sau ai reluat dintr-un checkpoint vechi. Rezolvare: șterge artefactele și rulează toate cele patru etape în ordine.
python train_resume_exact.py --mode clean
python train_resume_exact.py --mode full
python train_resume_exact.py --mode interrupt --stop-after 9
python train_resume_exact.py --mode resume
python train_resume_exact.py --mode verify
Revenire și curățenie
Pentru a șterge rezultatele experimentului, rulează:
python train_resume_exact.py --mode cleanPentru a elimina complet mediul local:
cd ~
rm -rf ~/resume-exact-pytorch
Aceasta șterge scriptul, virtual environmentul și toate checkpointurile create în tutorial. Nu rula comanda dacă ai pus în același director alte fișiere pe care vrei să le păstrezi.
Mai departe
Următorul pas este să extinzi checkpointul cu scheduler, gradient scaler dacă folosești mixed precision și stări specifice frameworkului de orchestrare. Pentru GPU, adaugi explicit starea CUDA RNG, iar pentru DataLoader cu mai mulți workeri trebuie controlate seed-urile workerilor. Pentru training distribuit, același principiu se aplică pe fiecare rank: checkpointul trebuie să descrie nu doar modelul, ci și poziția exactă a experimentului.
Întrebări frecvente
De ce nu este suficient să salvez doar model.state_dict()?
Pentru inferență poate fi suficient, dar pentru resume exact nu ajunge. Trainingul depinde și de optimizer, RNG state, ordinea batch-urilor și poziția samplerului.
De ce tutorialul folosește CPU și num_workers=0?
Pentru că scopul este demonstrarea reproductibilității exacte fără variabile suplimentare. GPU-ul și workerii multipli pot fi folosiți ulterior, dar trebuie salvate și controlate stări suplimentare.
Ce dovedește max_abs_parameter_diff: 0.0?
Dovedește că fiecare tensor al modelului reluat este identic cu tensorul modelului antrenat neîntrerupt, în configurația fixată din tutorial.
Pot schimba datasetul sau modelul?
Da, dar atunci trebuie să refaci baseline-ul și rularea cu resume în aceeași configurație. Nu compara checkpointuri generate cu parametri, versiuni sau date diferite.