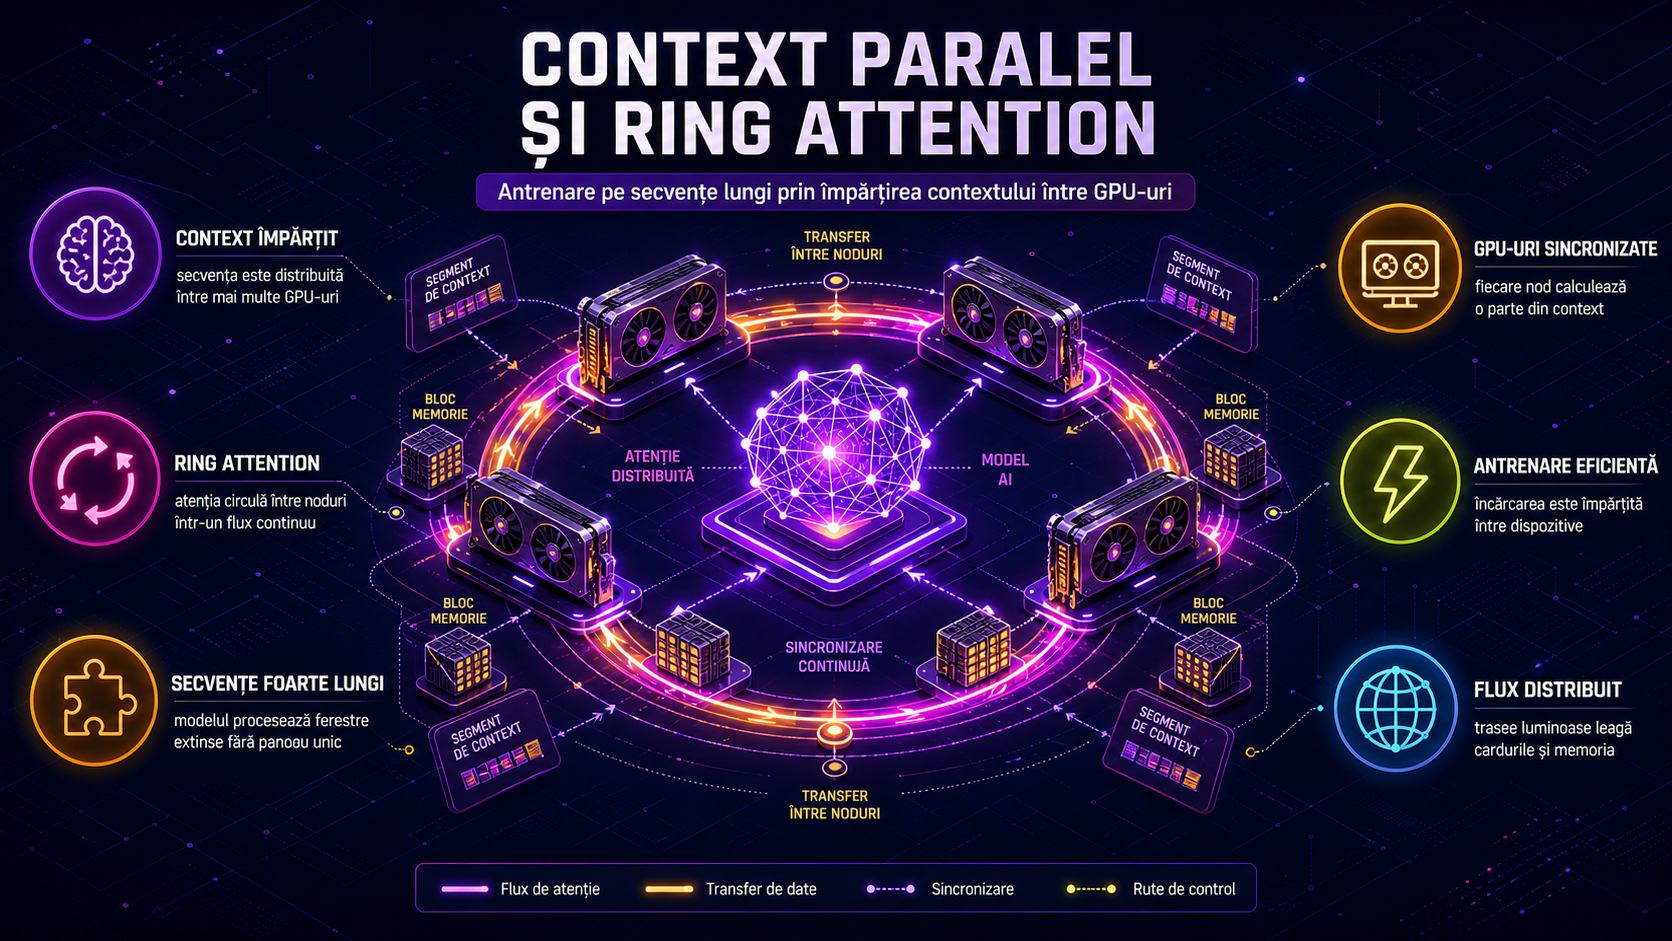
Modelele mari de limbaj devin mult mai utile atunci când pot „vedea” mai mult context, dar exact aici apare una dintre cele mai scumpe probleme din antrenare: memoria crește odată cu lungimea secvenței. Pe scurt, dacă dublezi contextul, nu plătești doar mai mult timp de calcul, ci și mai multă memorie pentru activări și atenție. De aceea, ecosistemul de training a început să trateze lungimea secvenței ca pe o dimensiune de paralelizare, nu doar ca pe o setare de model.
Aici intră în scenă Context Parallelism, sau context parallel. În documentația Megatron Core de la NVIDIA, această tehnică este descrisă ca o împărțire a datelor pe dimensiunea secvenței. Fiecare GPU primește doar o bucată din context, iar activările sunt și ele împărțite pe aceeași axă. Avantajul direct este simplu: memoria de activare pe fiecare GPU scade aproximativ proporțional cu gradul de împărțire, ceea ce reduce riscul de out-of-memory la contexte lungi.
Diferența față de sequence parallelism merită clarificată. Sequence parallelism, în forma clasică folosită în unele stack-uri de training, nu mută întreaga rețea pe axa secvenței, ci doar anumite activări, cum ar fi cele din LayerNorm și Dropout. Context parallel merge mai departe: împarte intrările și activările întregului model pe secvență. Cu alte cuvinte, este o soluție mai agresivă și mai utilă când vrei ferestre de context mult mai lungi, nu doar mici optimizări de memorie.
Partea complicată apare în stratul de atenție. Operațiile obișnuite, cum ar fi unele transformări liniare, pot rula local pe bucata de secvență aflată pe GPU. Atenția, însă, are nevoie ca tokenii locali să „vadă” cheile și valorile relevante din întreaga secvență. Din acest motiv, implementările de context parallel folosesc schimburi de date între GPU-uri, de tip all-gather și reduce-scatter. NVIDIA notează explicit că aceste schimburi pot fi implementate eficient într-o topologie de tip ring, tocmai pentru a limita costul comunicației.
De aici se leagă natural Ring Attention. Lucrarea Ring Attention with Blockwise Transformers for Near-Infinite Context propune o abordare în care calculul atenției și al feedforward-ului este făcut pe blocuri, iar comunicarea blocurilor key-value este suprapusă peste calcul. Ideea importantă nu este doar că împarți contextul între dispozitive, ci că faci asta fără să transformi comunicarea într-un blocaj permanent. Autorii susțin că astfel pot fi antrenate secvențe de până la un număr de ori mai lung egal cu numărul de dispozitive, iar în experimente discută chiar contexte de ordinul milioanelor de tokeni.
Practic, dacă vrei să antrenezi sau să faci post-training pe secvențe foarte lungi, traseul realist arată așa. În primul rând, alegi un stack care are suport matur pentru paralelism pe secvență, cum este Megatron Core pentru context parallel, sau un cod de cercetare dedicat pentru Ring Attention. În al doilea rând, stabilești ce problemă încerci să rezolvi: lipsă de memorie, throughput slab sau ambele. Dacă principalul blocaj este out-of-memory la contexte lungi, context parallel este de obicei primul pas mai pragmatic decât creșterea brutală a tensor parallelism-ului sau folosirea excesivă a recomputării.
În al treilea rând, trebuie să ții cont de compromisuri. Context parallel reduce memoria pe GPU, dar adaugă trafic între GPU-uri. Asta înseamnă că interconectarea contează mult: NVLink, InfiniBand și topologia nodurilor pot schimba serios rezultatul. În plus, pentru loturi cu secvențe de lungimi diferite, setările fixe nu sunt întotdeauna eficiente. NVIDIA a publicat în 2026 și conceptul de Dynamic Context Parallelism, care alege dinamic gradul de împărțire pe microbatch, tocmai pentru a evita costul inutil de comunicare pe exemplele mai scurte.
Mai există o nuanță importantă: „context lung” nu înseamnă automat și „date pregătite bine”. Uneori, sequence packing ajută la reducerea risipei din padding în fine-tuning, dar nu înlocuiește context parallel pentru antrenare pe ferestre foarte mari. Sunt două optimizări diferite: una reduce golurile dintre exemple, cealaltă împarte efectiv secvența mare între GPU-uri.
Pentru echipele tehnice din România, concluzia practică este aceasta: dacă vrei să duci un model spre contexte foarte lungi, începi cu o arhitectură și un framework care suportă explicit împărțirea secvenței, verifici costul comunicației dintre GPU-uri și testezi incremental lungimea contextului. Ring Attention este promițător mai ales în zona de cercetare și sisteme experimentale de context extrem de lung. Context parallel, în schimb, este deja o piesă mai clar integrată în stack-urile moderne de training. Nu există o soluție magică, dar există o direcție clară: contextul lung nu se obține doar din mai multă memorie, ci dintr-o împărțire mai inteligentă a calculelor între GPU-uri.
Surse
- NVIDIA Megatron Core Documentation — Context Parallelism
- NVIDIA Technical Blog — Speeding Up Variable-Length Training with Dynamic Context Parallelism and NVIDIA Megatron Core
- arXiv — Ring Attention with Blockwise Transformers for Near-Infinite Context
- arXiv — Blockwise Parallel Transformer for Large Context Models
- GitHub — haoliuhl/ringattention