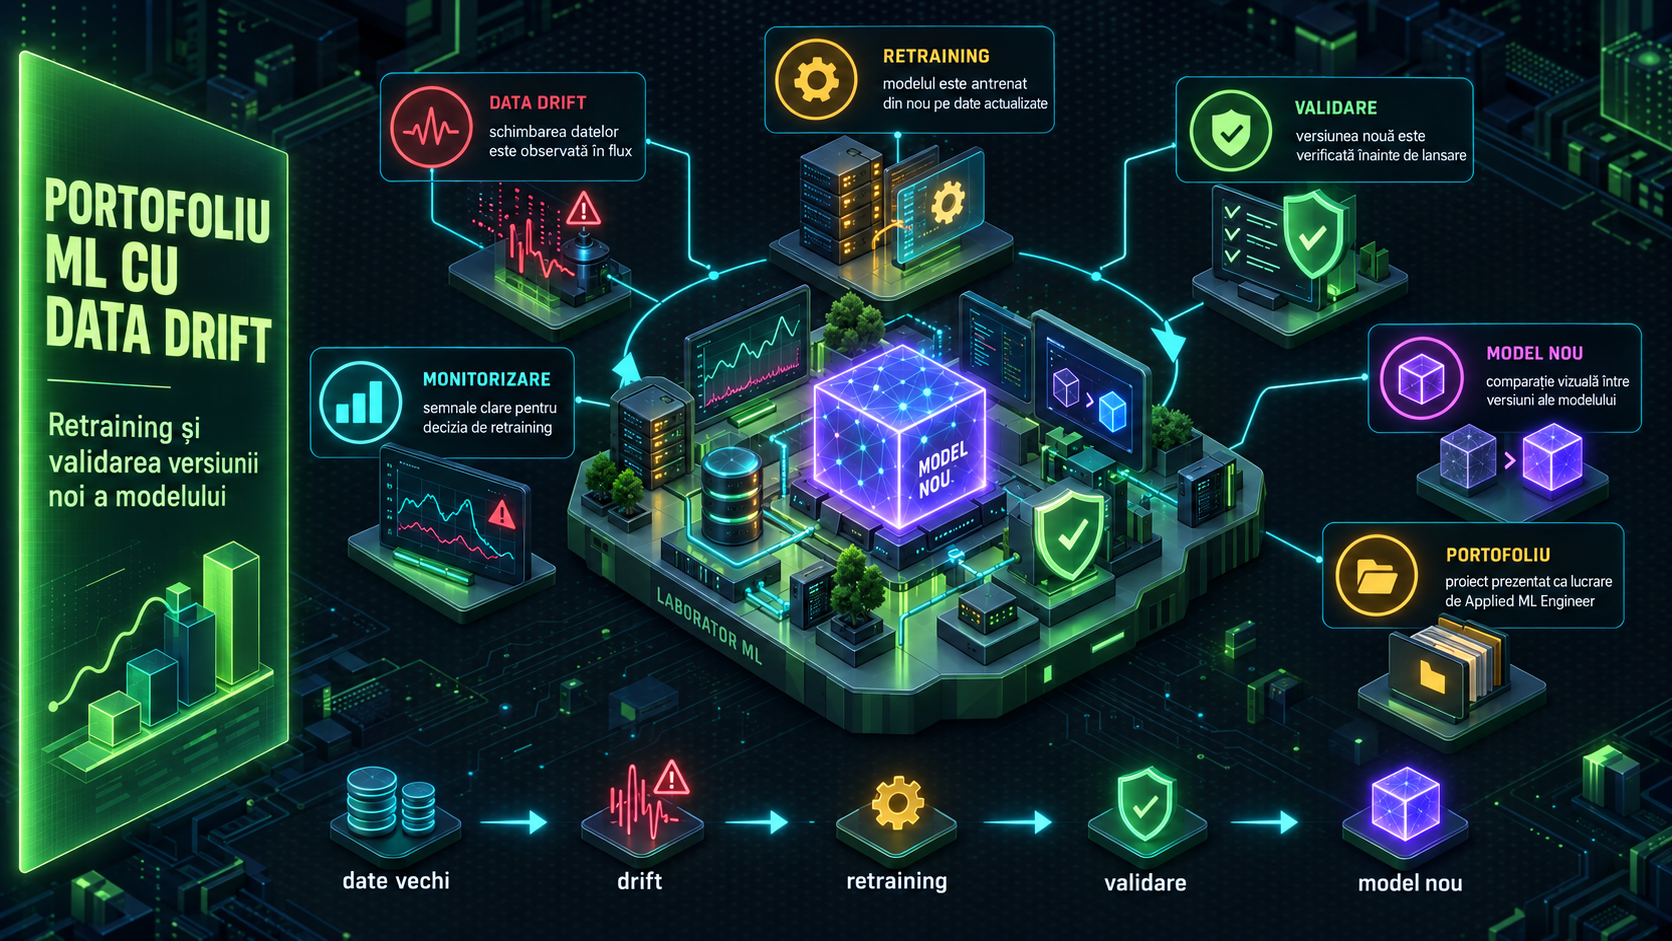
Pentru multe joburi AI, un notebook frumos nu mai este suficient. Un candidat pentru rolul de Applied ML Engineer trebuie să arate că înțelege nu doar cum se antrenează un model, ci și ce se întâmplă după ce modelul ajunge într-un produs real: datele se schimbă, performanța poate scădea, iar o versiune nouă nu trebuie lansată doar pentru că are un scor mai bun într-un experiment izolat.
Un proiect de portofoliu foarte bun poate porni de la o idee simplă: construiești un model predictiv, simulezi apariția data drift-ului, declanșezi retraining-ul și validezi dacă noua versiune merită promovată. Nu trebuie să fie un sistem uriaș. Important este să demonstrezi gândire de producție.
Alege o problemă ușor de înțeles
Un proiect convingător începe cu o problemă clară. Poate fi un model care estimează riscul de anulare a unei comenzi, clasifică mesaje de suport, prezice cererea pentru un produs sau identifică tranzacții suspecte într-un set de date public. Pentru portofoliu, contează mai puțin domeniul spectaculos și mai mult modul în care explici deciziile tehnice.
Definește de la început ce înseamnă „model bun”. Nu scrie doar „am obținut acuratețe mare”. Alege metrici potrivite problemei: precizie, recall, F1, AUC, eroare medie sau alt indicator relevant. Documentația scikit-learn recomandă evaluarea atentă a performanței estimatorilor, inclusiv prin cross-validation, tocmai pentru a evita concluziile trase dintr-o singură împărțire norocoasă a datelor.
Introdu data drift într-un mod transparent
Data drift apare când distribuția datelor de intrare se schimbă față de datele pe care modelul a fost antrenat. Evidently AI explică diferența importantă dintre data drift și concept drift: în primul caz se schimbă datele de intrare, în al doilea se poate schimba relația dintre date și rezultat. Într-un proiect de portofoliu, această distincție arată maturitate tehnică.
Poți împărți datele pe perioade, pe regiuni, pe tipuri de utilizatori sau poți crea o simulare controlată: de exemplu, după o anumită dată, distribuția unei variabile se modifică. Important este să spui clar că drift-ul este simulat sau observat în setul ales, nu să îl prezinți ca fenomen real dacă nu ai dovada.
Apoi construiești un raport de monitorizare: ce caracteristici s-au schimbat, cât de mult, ce metrici au scăzut și dacă schimbarea justifică o intervenție. Aici proiectul începe să semene cu munca reală a unui Applied ML Engineer.
Arată când faci retraining și când nu
O greșeală frecventă este ideea că orice drift cere imediat retraining. În practică, o schimbare în date nu înseamnă automat că modelul este inutil. Google Cloud descrie continuous training ca parte a MLOps, dar subliniază că sistemele ML au nevoie de validare a datelor, evaluarea calității modelului și validarea modelului înainte de livrare.
În proiect, definește reguli simple: retraining-ul se declanșează doar dacă există drift relevant și dacă performanța pe un set de validare recent scade sub un prag justificat. Păstrează versiunea veche ca baseline. Antrenează o versiune nouă pe date actualizate, dar nu o promova automat.
Validează noua versiune ca într-un mediu real
Partea cea mai valoroasă a proiectului este comparația dintre modelul vechi și modelul nou. Include un tabel cu metrici, dar și o explicație: unde modelul nou este mai bun, unde poate fi mai slab și ce risc există dacă este folosit.
Poți adăuga teste simple de calitate: verificarea schemelor de date, lipsa valorilor imposibile, consistența coloanelor, comparație pe segmente și un raport final de decizie. Dacă noul model nu trece criteriile, concluzia corectă este „nu se promovează”. Pentru angajatori, această disciplină valorează mai mult decât un scor cosmetizat.
Ce pui în GitHub
Repository-ul ar trebui să fie ușor de parcurs. Include un README clar, datele sau instrucțiunile de obținere a lor, un pipeline reproductibil, rapoarte de drift, evaluarea modelului vechi versus model nou și o scurtă secțiune „decizie de release”. Dacă folosești notebook-uri, adaugă și scripturi curate pentru pașii principali.
Un proiect bun nu promite că rezolvă toate problemele MLOps. Arată, concret, că știi să lucrezi cu date care se schimbă, să nu ai încredere oarbă într-un model și să validezi o versiune nouă înainte de lansare. Pentru un rol de Applied ML Engineer, acesta este exact tipul de diferență care poate transforma un portofoliu obișnuit într-unul credibil.