Când un sistem Linux „agață” pentru câteva milisecunde, răspunsul nu se vede întotdeauna în top, htop sau într-un simplu log de aplicație. Poate fi un interrupt care apare prea des, un proces trezit la timp dar programat prea târziu, o schimbare de context într-un moment prost sau o combinație greu de observat fără o cronologie comună.
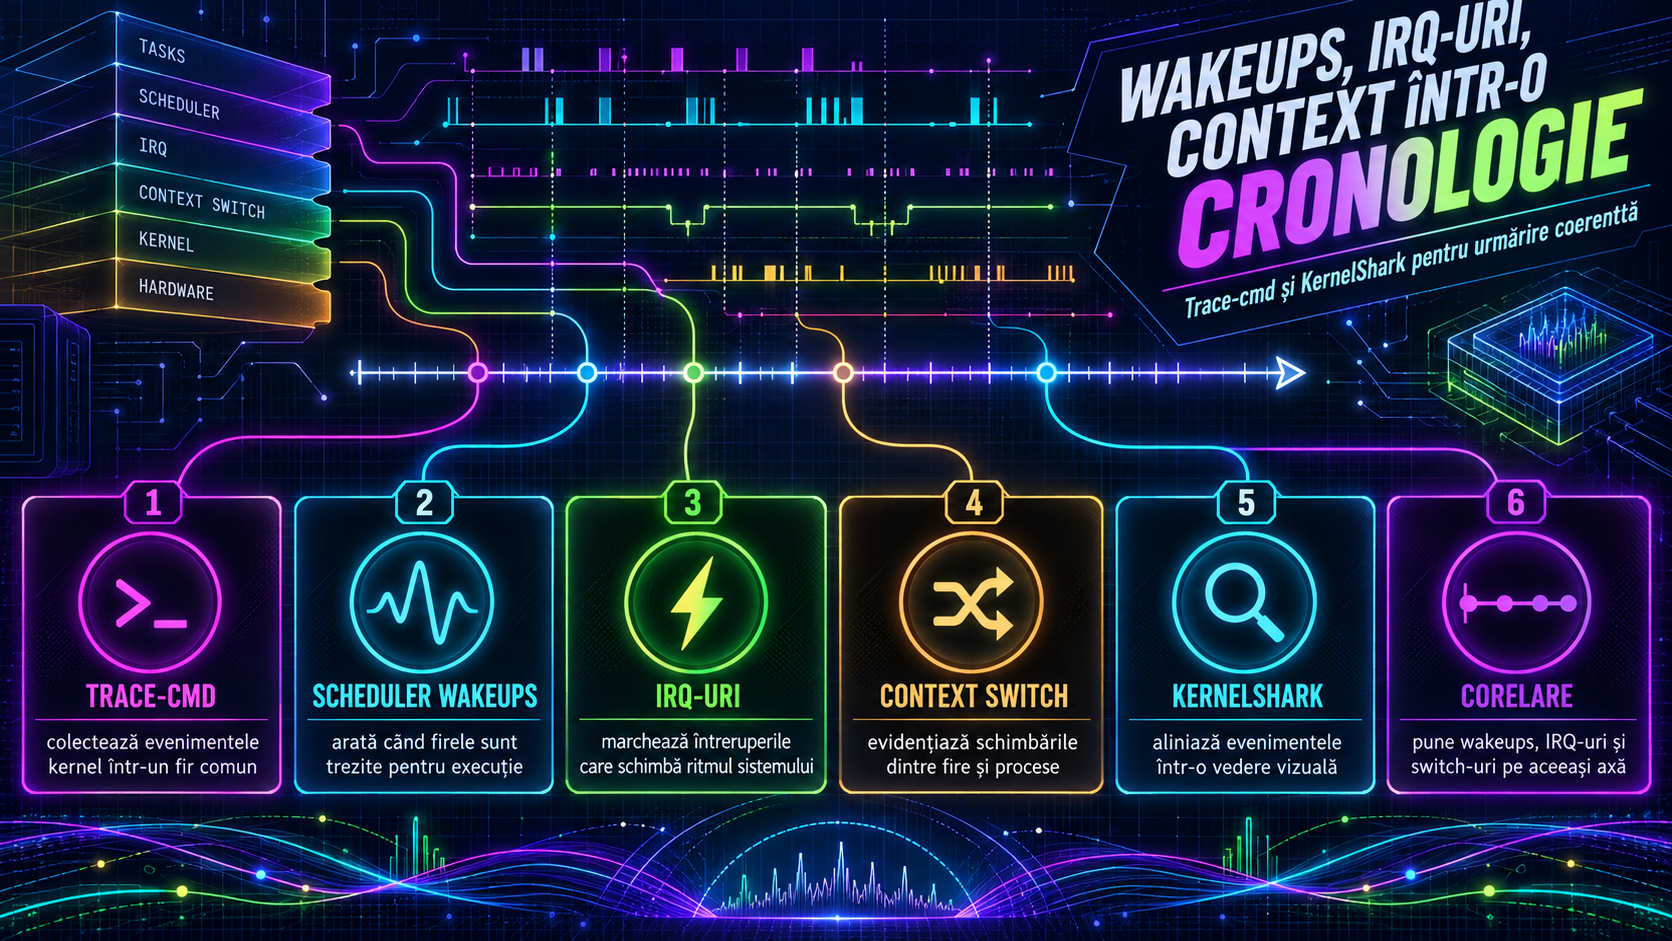
Aici intră în scenă trace-cmd și KernelShark. Primul colectează date din infrastructura ftrace a kernelului Linux, iar al doilea le afișează vizual, pe axă de timp. Împreună, sunt utile pentru depanare de performanță, latență și comportament al schedulerului, mai ales când problema apare rar și durează foarte puțin.
De ce nu ajunge un singur log
În problemele de performanță, ordinea evenimentelor contează enorm. Un proces poate fi trezit de kernel printr-un eveniment de tip sched_wakeup, dar asta nu înseamnă că rulează imediat. Între trezire și execuție pot apărea alte taskuri, întreruperi hardware, softirq-uri sau schimbări de context care explică întârzierea.
Documentația ftrace descrie infrastructura de tracing ca un cadru cu mai multe utilitare, inclusiv event tracing, latency tracing și evenimente statice din kernel. Pentru un administrator sau dezvoltator Linux, avantajul este că poți urmări evenimente reale din kernel, nu doar simptome raportate de aplicații.
Trace-cmd este interfața practică pentru acest lucru. Pagina sa de manual spune clar că instrumentul interacționează cu tracerul intern ftrace și poate înregistra o urmă live într-un fișier trace.dat. Acest fișier poate fi apoi citit text sau deschis în KernelShark.
Ce evenimente urmărești
Pentru subiectul scheduler wakeups, IRQ-uri și context switch-uri, punctul de pornire este familia de evenimente sched și irq. În practică, evenimentele importante sunt sched_wakeup, sched_switch și evenimentele de intrare/ieșire pentru întreruperi, cum ar fi irq_handler_entry și irq_handler_exit, acolo unde sunt disponibile pe sistemul tău.
Nu toate sistemele au aceeași configurație, aceleași permisiuni sau același set de evenimente expuse. Verificarea se face local, în sistemul analizat, prin lista de evenimente disponibile în tracefs, de obicei sub /sys/kernel/tracing. Documentația kernelului menționează că evenimentele disponibile pot fi găsite în available_events, iar evenimente precum sched_wakeup pot fi activate prin interfața set_event.
O captură tipică, defensivă și de depanare, urmărește doar evenimentele necesare pentru o fereastră scurtă de timp. Ideea nu este să colectezi tot ce există, ci să prinzi episodul problematic: latență audio, freeze scurt în interfață, jitter într-un serviciu sau întârziere la un proces critic.
Cum gândești cronologia
În KernelShark, valoarea nu vine doar din faptul că vezi multe evenimente, ci din faptul că le vezi ordonate temporal. Cauți întâi momentul vizibil al problemei: procesul care întârzie, CPU-ul aglomerat sau un vârf de activitate. Apoi te uiți înapoi câteva milisecunde.
Dacă vezi sched_wakeup pentru un proces, apoi o pauză până la sched_switch către acel proces, întrebarea devine: ce a ocupat CPU-ul între timp? Poate a rulat alt task. Poate a existat o serie de IRQ-uri. Poate procesul a fost trezit pe un CPU, dar contextul real al execuției arată altceva.
Dacă vezi multe irq_handler_entry aproape lipite între ele, corelezi cu ce se întâmplă pe același CPU. O furtună de întreruperi nu trebuie presupusă doar pentru că sistemul pare lent; trebuie văzută în cronologie și comparată cu restul evenimentelor.
Dacă vezi multe sched_switch-uri într-un interval foarte scurt, poate fi vorba de încărcare normală, de competiție între taskuri sau de un pattern care merită investigat mai departe. KernelShark ajută tocmai pentru că reduce riscul de a interpreta izolat un singur eveniment.
Ce trebuie evitat
O greșeală frecventă este colectarea prea largă. Un trace uriaș devine greu de analizat și poate influența sistemul pe care îl observi. Mai bine pornești cu o ipoteză clară: „procesul X este trezit, dar rulează târziu” sau „IRQ-urile par să întrerupă execuția normală”.
Altă greșeală este concluzia grăbită. Un sched_wakeup nu înseamnă automat problemă. Un IRQ nu înseamnă automat defect hardware. O schimbare de context nu este, în sine, un semn rău. Contextul, frecvența și poziția în cronologie sunt cele care contează.
Pentru Linux avansat, combinația trace-cmd plus KernelShark este una dintre cele mai curate metode de a transforma o senzație vagă — „sistemul întârzie” — într-o secvență verificabilă de evenimente. Nu îți spune automat cauza, dar îți arată ordinea faptelor. Iar în depanarea kernelului, ordinea este adesea diferența dintre presupunere și diagnostic.