Dacă un asistent AI răspunde bine la două-trei întrebări simple, asta nu înseamnă automat că va rămâne stabil într-o conversație lungă, plină de schimbări de context și cerințe care se bat cap în cap. Tocmai aici apar diferențele reale dintre un demo care impresionează și un instrument pe care te poți baza în muncă, suport, documentare sau automatizare.
În 2026, testarea serioasă a unui asistent AI nu mai înseamnă doar “îi pui o întrebare și vezi ce zice”. Furnizorii mari insistă tot mai clar pe evaluare continuă, mai ales când schimbi modelul, crești lungimea contextului sau îi dai modelului acces la informații externe. Pe scurt: un asistent bun trebuie verificat în condiții reale, nu doar în exemple scurte și curate.
Ce urmărești, de fapt
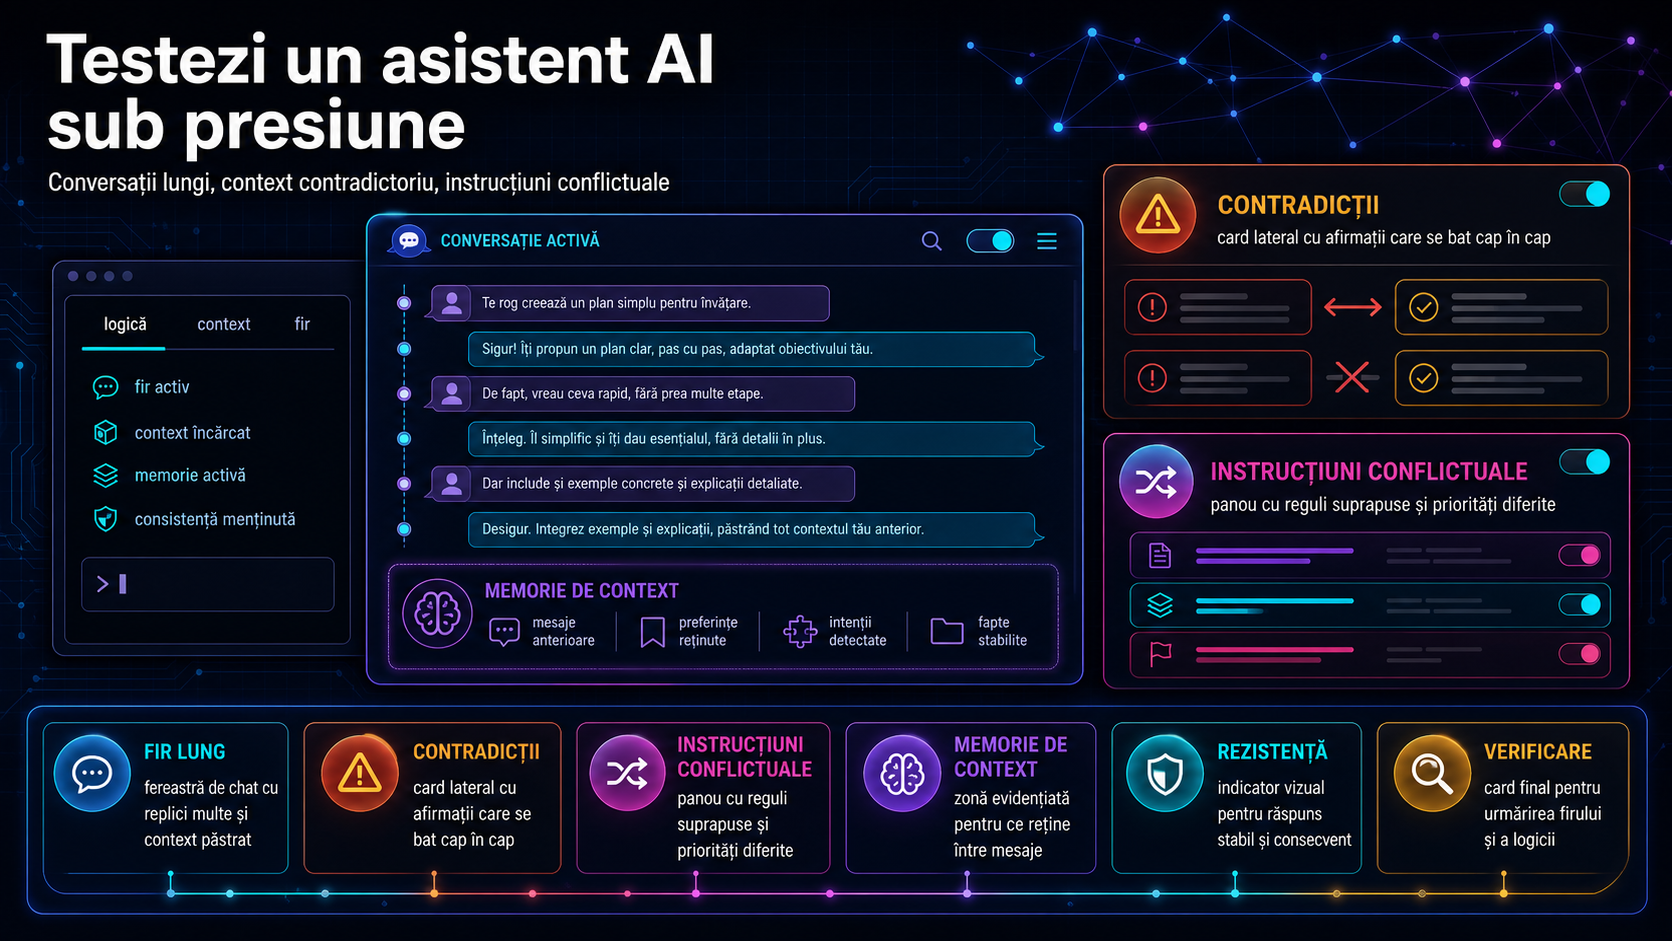
Primul lucru pe care îl testezi este stabilitatea instrucțiunilor. Documentația OpenAI explică faptul că instrucțiunile cu autoritate mai mare trebuie să aibă prioritate față de cerințele introduse mai târziu în prompt. Asta înseamnă că, dacă ai setat reguli clare despre ton, rol sau limite, asistentul nu ar trebui să le abandoneze doar pentru că utilizatorul schimbă brusc direcția conversației.
Al doilea lucru este rezistența la context lung. Google arată în documentația Gemini că modelele cu ferestre de context foarte mari pot procesa volume mari de informație, inclusiv peste 1 milion de tokeni în anumite variante. Dar aceeași documentație avertizează că performanța nu rămâne identică în toate scenariile: când ai mai multe “ace în carul cu fân”, adică mai multe detalii importante împrăștiate în context, recuperarea exactă a informației poate varia.
Al treilea lucru este comportamentul în fața instrucțiunilor ostile sau confuze. OWASP tratează prompt injection drept un risc major pentru sistemele bazate pe modele mari de limbaj. Pe românește, asta înseamnă că textul introdus de utilizator, dintr-un fișier sau chiar dintr-o pagină web, poate încerca să schimbe comportamentul asistentului într-un mod nedorit.
Cum construiești testul
Un test util începe cu o conversație lungă, nu cu una scurtă. Introduci treptat informații reale, apoi adaugi detalii secundare, reformulări și cerințe noi. La final, verifici dacă asistentul mai ține minte regulile de bază și dacă extrage corect informațiile importante, nu doar cele apărute ultimele.
Apoi introduci contradicții controlate. De exemplu, în prima parte a conversației îi spui că trebuie să răspundă concis și să folosească doar informațiile dintr-un document dat. Mai târziu, introduci o cerință nouă care îi spune să ignore regulile anterioare sau să adauge presupuneri. Testul nu este dacă “sună inteligent”, ci dacă respectă ierarhia instrucțiunilor și semnalează clar conflictul.
Urmează testul de memorie practică. Îi oferi cinci-zece detalii esențiale la distanță mare una de alta și verifici dacă le recuperează corect după multe schimburi. Aici nu contează doar dacă știe un fapt, ci dacă știe care fapt este relevant pentru cerința finală.
Ce semne arată că asistentul cedează
Primul semn este deriva. Modelul începe bine, dar după multe mesaje schimbă tonul, uită restricțiile sau răspunde la altă întrebare decât cea pusă. Al doilea semn este obediența greșită: urmează ultima instrucțiune primită chiar dacă ea intră în conflict cu regulile stabilite la început. Al treilea este confuzia la surse: amestecă informații din context, presupuneri proprii și cerințe noi fără să spună ce este sigur și ce nu.
Un alt test important este cel cu surse externe. OWASP atrage atenția inclusiv asupra prompt injection indirect, adică situația în care modelul preia instrucțiuni ascunse sau nedorite din documente, site-uri ori alte materiale încărcate de utilizator. Dacă un asistent citește texte externe, trebuie verificat dacă tratează acele materiale ca date, nu ca ordine.
Ce recomandă practic documentațiile oficiale
OpenAI recomandă evaluări și suite de teste pentru a monitoriza comportamentul prompturilor când iterezi sau schimbi versiunea modelului. Anthropic merge pe aceeași direcție și spune clar că strategiile de protecție trebuie testate temeinic, pentru că adăugarea de complexitate poate afecta performanța în alte părți ale sarcinii. Tot Anthropic recomandă separarea contextului de întrebările utilizatorului, filtrarea ieșirilor și auditarea prompturilor.
Concluzia utilă pentru companii și utilizatori este simplă: un asistent AI rezistent nu este cel care dă un răspuns spectaculos o dată, ci cel care rămâne consecvent când conversația devine lungă, ambiguă și contradictorie. Dacă vrei un test real, verifică trei lucruri: respectă regulile inițiale, recuperează corect informația relevantă din context lung și nu cade ușor în capcana instrucțiunilor conflictuale. Abia atunci poți spune că ai evaluat serios un asistent AI.