În multe proiecte AI, modelul nu trebuie doar să aleagă o etichetă, ci și să spună cât de sigur este pe răspuns. Aici apare una dintre cele mai importante probleme practice: probabilitățile brute ale unui classifier bazat pe LLM pot arăta convingător, dar să nu fie bine calibrate. Cu alte cuvinte, un scor de 0,90 nu înseamnă automat că predicția este corectă în aproximativ 90% dintre cazuri.
De ce contează? Pentru că în aplicații reale probabilitatea nu este decor. Ea poate decide dacă un e-mail merge la revizuire umană, dacă un ticket este escaladat, dacă un document este marcat drept sensibil sau dacă un utilizator primește un avertisment automat. Dacă scorurile sunt prea optimiste, sistemul inspiră o încredere falsă. Dacă sunt prea prudente, pierzi automatizare utilă.
Ce înseamnă, de fapt, un model bine calibrat
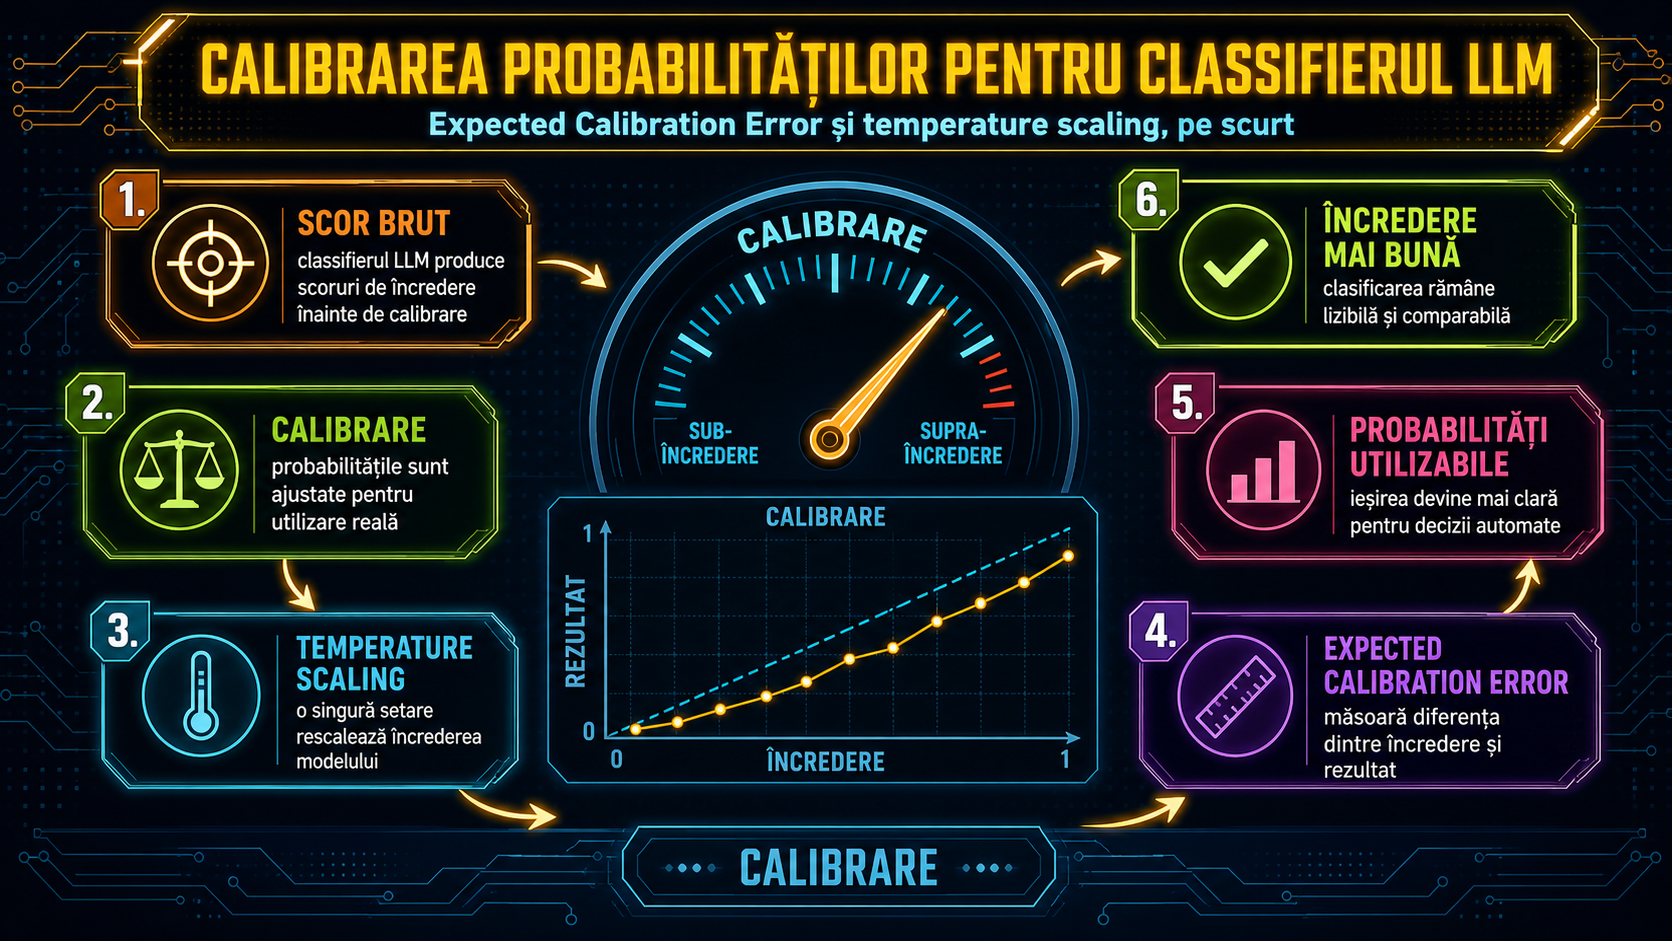
Documentația scikit-learn descrie un classifier bine calibrat ca fiind unul în care valorile returnate de predict_proba pot fi interpretate direct ca nivel de încredere. Exemplul clasic este simplu: dacă modelul dă scoruri de aproximativ 0,8 pentru un grup de exemple, atunci cam 80% dintre acele exemple ar trebui să fie într-adevăr corecte. Tot scikit-learn explică faptul că reliability diagrams, numite și calibration curves, compară probabilitatea prezisă cu frecvența observată a rezultatelor corecte, pe intervale de scor.
Pentru clasificatoare construite peste LLM-uri, problema devine mai delicată. Lucrarea On the Calibration of Large Language Models and Alignment arată că fiabilitatea acestor modele merită evaluată explicit, iar calibrarea nu este un detaliu cosmetic. Altfel spus, faptul că modelul produce un răspuns fluent sau un scor aparent coerent nu garantează că acel scor reflectă corect incertitudinea reală.
Cum citești Expected Calibration Error
Expected Calibration Error, prescurtat ECE, este una dintre cele mai folosite măsuri pentru această problemă. Documentația TensorFlow Probability o rezumă clar: modelul este calibrat dacă grupurile de probabilități prezise au o acuratețe medie apropiată de nivelul lor de încredere, iar ECE măsoară media diferențelor absolute dintre încrederea prezisă și acuratețea observată în acele grupuri. Pe scurt, un ECE mai mic înseamnă, de regulă, o aliniere mai bună între ce „crede” modelul și ce se întâmplă în realitate.
În practică, ECE nu se citește singur. Dacă îl privești fără un reliability diagram, poți rata zonele unde modelul greșește sistematic. De exemplu, două modele pot avea un ECE apropiat, dar unul să fie prost calibrat exact în intervalul critic în care tu iei decizii automate, cum ar fi 0,70–0,90.
Unde ajută temperature scaling
Un punct de referință important rămâne lucrarea On Calibration of Modern Neural Networks, care a popularizat ideea că temperature scaling, o variantă cu un singur parametru a Platt scaling, poate calibra eficient predicțiile în multe situații. Ideea este elegantă: nu schimbi ordinea claselor prezise, ci doar „înmoaie” sau „ascuți” distribuția probabilităților prin rescalarea logit-urilor cu o temperatură învățată pe un set separat de validare.
Avantajul major este simplitatea. Dacă ai deja un classifier LLM care produce scoruri pentru etichete, temperature scaling este adesea primul pas logic: intervenție mică, cost redus și implementare clară. Dar are și o limită importantă: nu repară orice tip de eroare. Dacă modelul confundă constant anumite clase sau dacă alegerea tokenilor pentru etichete introduce ambiguități, calibrarea post-hoc nu va transforma un classifier slab într-unul solid.
Ce e diferit la un classifier bazat pe LLM
În cazul LLM-urilor, probabilitatea utilizată la clasificare vine adesea din scorurile unor tokeni sau ale unor variante de răspuns. Aici trebuie verificat cu atenție dacă etichetele sunt mapate curat, dacă promptul este stabil și dacă setul de validare seamănă cu datele reale. Lucrarea Calibrated Large Language Models for Binary Question Answering arată chiar că, pentru unele scenarii de clasificare binară, metode precum IVAP pot depăși temperature scaling. Mesajul practic nu este că temperature scaling devine inutil, ci că el trebuie tratat ca baseline serios, nu ca soluție universală.
Un flux sănătos de lucru arată așa: separi clar train, validation și test; măsori ECE și desenezi reliability diagram pe validation; aplici temperature scaling doar pe validation; apoi verifici din nou pe test, fără să refolosești datele pentru reglaj. Dacă pragurile de business contează, verifici calibrarea exact în zona unde vei automatiza decizia, nu doar la nivel global.
Concluzia utilă pentru echipe este simplă: dacă vrei probabilități utilizabile, nu te opri la acuratețe, F1 sau AUC. Pentru un classifier bazat pe LLM, o probabilitate bună este una care poate susține decizii reale, auditabile și prudente. Iar pentru asta, ECE, reliability diagrams și temperature scaling ar trebui să fie parte din evaluarea standard, nu un pas opțional adăugat prea târziu.