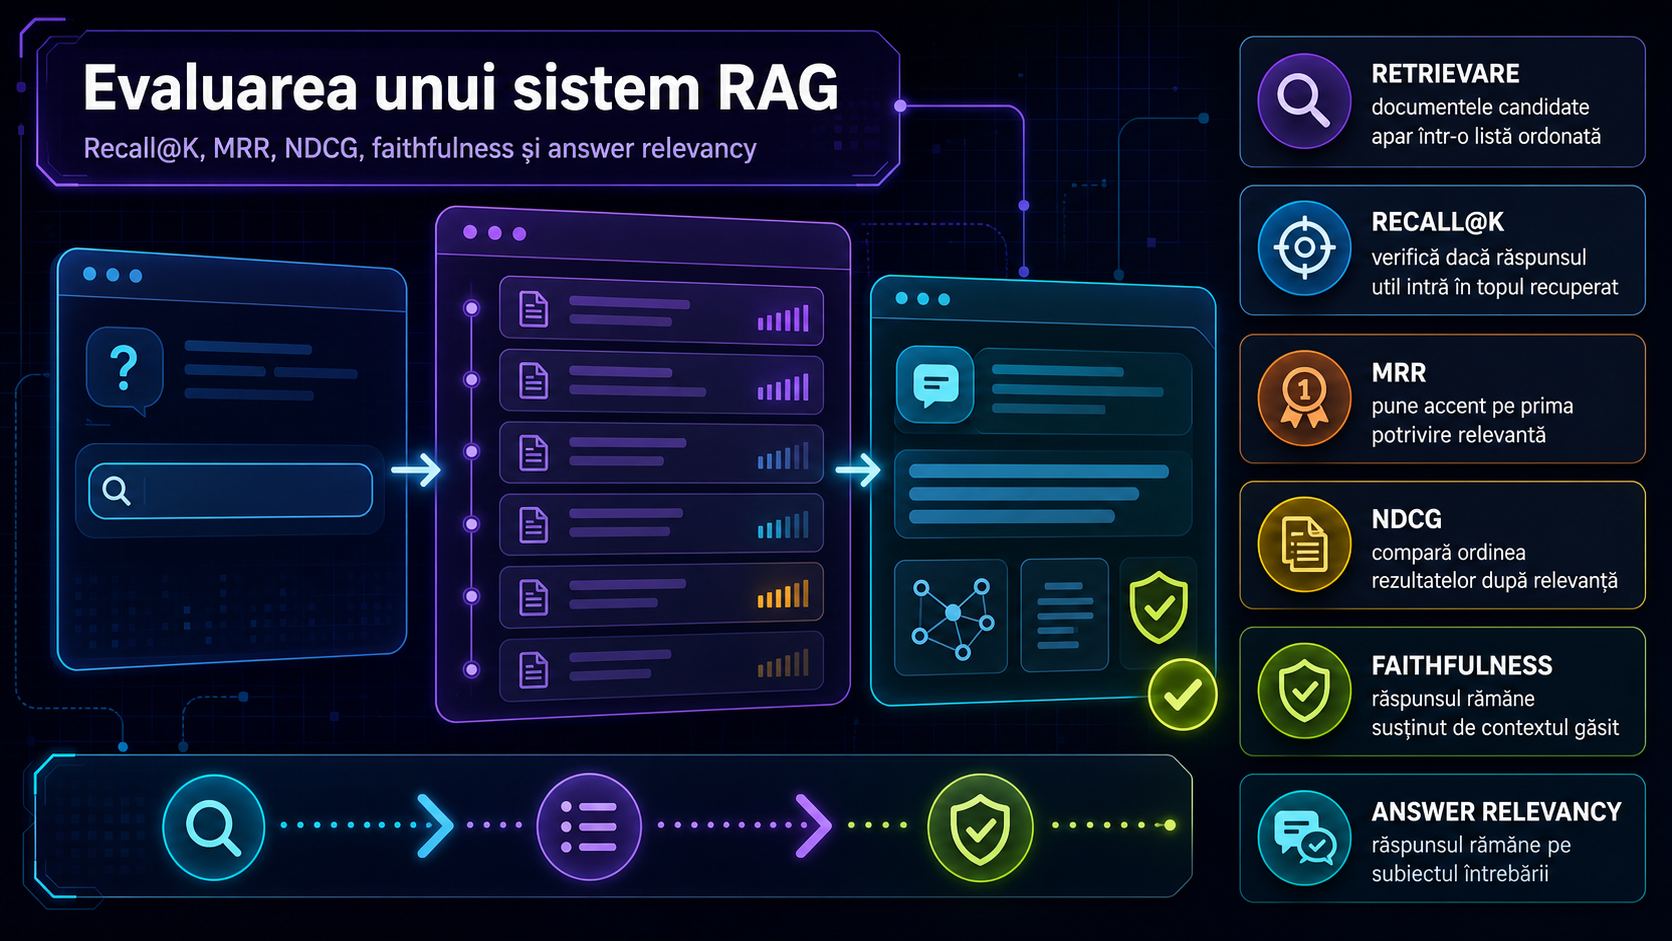
Evaluarea unui sistem RAG (Retrieval-Augmented Generation) înseamnă să verifici două lucruri diferite: cât de bine găsește sistemul informația potrivită și cât de bine construiește răspunsul final pe baza ei. În practică, multe echipe se uită doar la răspunsul generat și omit componenta de retrieval. Este o greșeală frecventă. Un răspuns poate părea fluent, dar să fie construit pe fragmente nerelevante, incomplete sau prost ordonate. De aceea, evaluarea serioasă a unui sistem RAG separă metricile pentru retrieval de metricile pentru răspunsul generat.
Metricile de retrieval măsoară calitatea documentelor sau a fragmentelor aduse în context. Recall@K arată dacă informația relevantă apare în primele K rezultate. Pe scurt, răspunde la întrebarea: „am recuperat ce trebuia?” Este util când vrei să vezi dacă sistemul ratează documente importante. Totuși, Recall@K nu spune nimic despre ordinea rezultatelor. Dacă documentul bun apare pe ultimul loc din top K, scorul poate fi totuși acceptabil.
MRR, adică Mean Reciprocal Rank, pune accent pe poziția primului rezultat relevant. Dacă primul document util apare foarte sus, scorul crește. MRR este util mai ales când contează ca utilizatorul sau modelul să primească rapid un context bun, fără să „sape” prin multe rezultate. Limita lui este că se concentrează pe primul rezultat relevant și poate ignora faptul că restul topului este slab.
NDCG, adică Normalized Discounted Cumulative Gain, merge mai departe și evaluează calitatea ordonării întregii liste, nu doar prezența sau primul hit relevant. Este o metrică potrivită când relevanța nu este doar binară, ci graduală: unele fragmente pot fi foarte relevante, altele doar parțial utile. NDCG penalizează documentele bune care apar prea jos și recompensează clasările apropiate de ordinea ideală.
Metricile pentru răspunsul generat măsoară altceva. Faithfulness verifică dacă afirmațiile din răspuns pot fi susținute de contextul recuperat. Cu alte cuvinte, modelul a rămas fidel surselor din prompt sau a „inventat” completări? Pentru un RAG folosit în suport intern, documentație, compliance sau securitate, faithfulness este esențială, fiindcă un răspuns fluent, dar nesusținut de context, poate induce decizii greșite.
Answer relevancy măsoară cât de bine răspunde ieșirea la întrebarea utilizatorului. Aici accentul nu cade pe adevăr factual, ci pe alinierea la intenția întrebării. Un răspuns poate fi fidel contextului, dar să fie vag, să ocolească întrebarea sau să includă detalii inutile. În acest caz, faithfulness poate fi bun, dar answer relevancy slab. Tocmai de aceea, cele două metrici nu trebuie confundate.
Diferența-cheie este simplă: metricile de retrieval spun dacă ai adus contextul potrivit, iar metricile de generare spun dacă modelul a folosit acel context corect și util. Dacă retrieval-ul este slab, modelul pornește cu un handicap. Dacă retrieval-ul este bun, dar faithfulness sau answer relevancy sunt slabe, problema poate fi în prompt, în instrucțiuni, în chunking sau în modul de compunere a răspunsului.
Pentru evaluare practică, echipele ar trebui să pornească de la un set de întrebări cât mai apropiat de utilizarea reală: întrebări scurte, ambigue, specifice domeniului și formulări naturale. Apoi trebuie definite documentele sau pasajele considerate relevante pentru fiecare întrebare. Fără acest „ground truth”, scorurile de retrieval au valoare limitată. Este util și să separi testele pe scenarii: întrebări factuale, întrebări cu mai multe documente, întrebări cu termeni sinonimi sau cu context incomplet.
La fel de important este să nu cauți un „scor universal bun”. Valorile acceptabile depind de domeniu, de riscul erorii, de tipul documentelor și de experiența dorită pentru utilizator. Un asistent intern pentru politici HR are alte cerințe decât un sistem RAG pentru documentație tehnică sau pentru triere de incidente. În plus, rezultatele se pot schimba mult în funcție de setul de întrebări, calitatea etichetării, strategia de chunking și colecția de documente disponibilă.
Concluzia practică este clară: nu evalua un sistem RAG doar după cât de „frumos” sună răspunsul. Măsoară separat retrieval-ul și răspunsul final, compară metricile între versiuni și completează scorurile automate cu verificări umane pe cazurile importante. Doar așa poți înțelege dacă sistemul găsește informația corectă, o prioritizează bine și răspunde într-un mod util și susținut de dovezi.
Surse
- Ragas Docs — List of available metrics
- Ragas Docs — Faithfulness
- Ragas Docs — Answer Relevancy
- Pinecone — Evaluation Measures in Information Retrieval
- deepset Blog — RAG Evaluation Part 1: Document Retrieval and Metrics
- Evidently AI — Normalized Discounted Cumulative Gain (NDCG) explained
- Microsoft Learn — Retrieval-augmented generation (RAG) in Azure AI Search