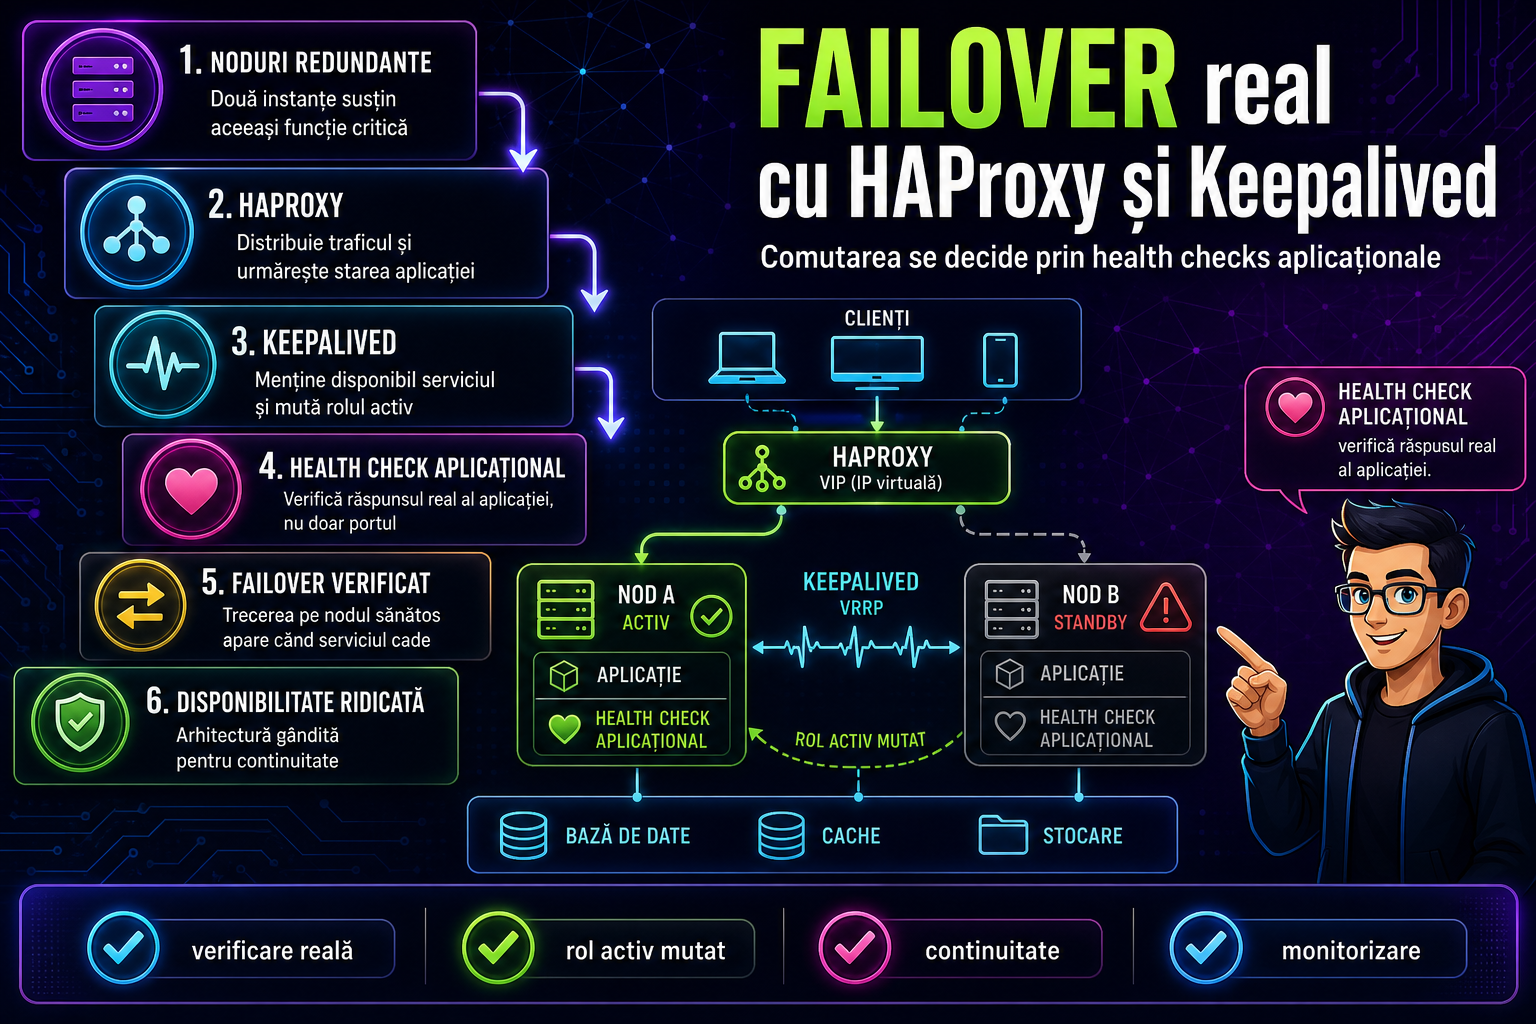
Pentru multe firme, disponibilitatea nu înseamnă doar „serverul răspunde la ping”, ci faptul că aplicația rămâne utilizabilă când apare o cădere planificată sau neplanificată. Într-o arhitectură Linux de tip high availability, două componente apar frecvent împreună: HAProxy și Keepalived. Folosite corect, ele pot reduce riscul ca un singur nod, o singură interfață sau un singur proces să devină punct unic de eșec.
HAProxy are rolul de a distribui traficul și de a decide ce servere din backend pot primi cereri. Documentația oficială arată clar că, implicit, un health check poate însemna doar încercarea de a deschide o conexiune TCP. Asta este util, dar limitat. Un port deschis nu garantează că aplicația servește corect cereri reale, că endpointul critic funcționează sau că dependențele interne sunt sănătoase. De aceea, pentru aplicații web și API-uri, verificările la nivel HTTP sunt de obicei mai relevante decât simplul ping sau decât testul „portul răspunde”.
HAProxy permite health checks HTTP prin opțiuni precum option httpchk și reguli de tip http-check expect. Practic, în loc să întrebe doar „pot deschide socketul?”, poate verifica „aplicația răspunde pe un endpoint de sănătate și întoarce codul corect?”. În documentația HAProxy apare explicit faptul că, atunci când se folosește option httpchk, se trimite o cerere HTTP, iar răspunsurile din gama 2xx și 3xx sunt considerate valide. Se poate merge și mai departe: administratorul poate cere explicit status 200 sau poate adapta verificarea astfel încât numai răspunsurile relevante pentru aplicație să fie considerate sănătoase.
Keepalived rezolvă altă problemă: continuitatea punctului de acces. Conform proiectului oficial, Keepalived oferă facilități de high availability pentru Linux și este construit pe VRRP. Pe scurt, VRRP permite ca un IP virtual, adică VIP-ul, să fie „deținut” de nodul activ și mutat pe nodul de rezervă când apar probleme. Pentru utilizatori și aplicații cliente, VIP-ul rămâne aceeași adresă de acces, chiar dacă mașina care îl servește se schimbă. Asta simplifică failover-ul și evită reconfigurări în lanț la nivel de DNS, aplicații sau clienți interni.
Aici apare însă diferența esențială dintre disponibilitate aparentă și disponibilitate reală. Dacă failover-ul se bazează doar pe faptul că un server răspunde la ICMP sau că interfața de rețea este sus, poți ajunge într-o situație periculoasă: nodul pare „viu”, dar HAProxy nu mai procesează cereri corect, aplicația returnează erori, un endpoint critic cade sau o dependență precum baza de date nu mai este accesibilă. Keepalived include mecanisme precum vrrp_script și track_script, adică poate lua în calcul rezultatul unor verificări suplimentare pentru a influența starea sau prioritatea nodului. Exact aici devine important conceptul de health check aplicațional.
În practică, cea mai sigură abordare este ca failover-ul să țină cont de traseul real al serviciului: procesul HAProxy rulează, frontendul ascultă, backendurile esențiale sunt marcate healthy, iar aplicația răspunde corect pe un endpoint dedicat, stabil și ușor de monitorizat. Un astfel de endpoint nu trebuie să expună informații sensibile. Ideal, el confirmă doar că aplicația poate servi cererea în condiții normale și, dacă modelul operațional o cere, că dependențele obligatorii sunt funcționale. În plus, endpointul de health trebuie tratat ca parte din operațiuni, nu ca o formalitate uitată după lansare.
Pentru firme și administratori, lecția importantă este să evite verificările superficiale. Ping-ul poate confirma doar conectivitatea de bază. Un test TCP spune că un port acceptă conexiuni. Dar continuitatea serviciului, mai ales pentru panouri interne, API-uri, aplicații AI sau platforme cu autentificare, cere validări mai apropiate de comportamentul real al aplicației. Testele de failover trebuie făcute controlat: în ferestre de mentenanță, cu monitorizare activă, cu loguri centralizate și cu un plan clar de rollback. Nu este suficient să vezi că VIP-ul s-a mutat; trebuie să confirmi că traficul ajunge unde trebuie și că utilizatorul final nu primește erori.
Merită verificat și dacă arhitectura nu mută pur și simplu punctul unic de eșec în alt loc. Două noduri HAProxy nu rezolvă mare lucru dacă ambele depind de aceeași bază de date fără redundanță, de același storage fragil sau de același switch critic. High availability înseamnă lanț complet: rețea, balansare, aplicație, dependențe și observabilitate.
Concluzia practică este simplă: HAProxy decide dacă serviciul poate primi trafic, Keepalived decide cine deține VIP-ul, iar health checks aplicaționale decid dacă failover-ul reflectă realitatea. Dacă vrei continuitate autentică, nu testa doar dacă serverul respiră. Testează dacă serviciul încă livrează ceea ce promite.