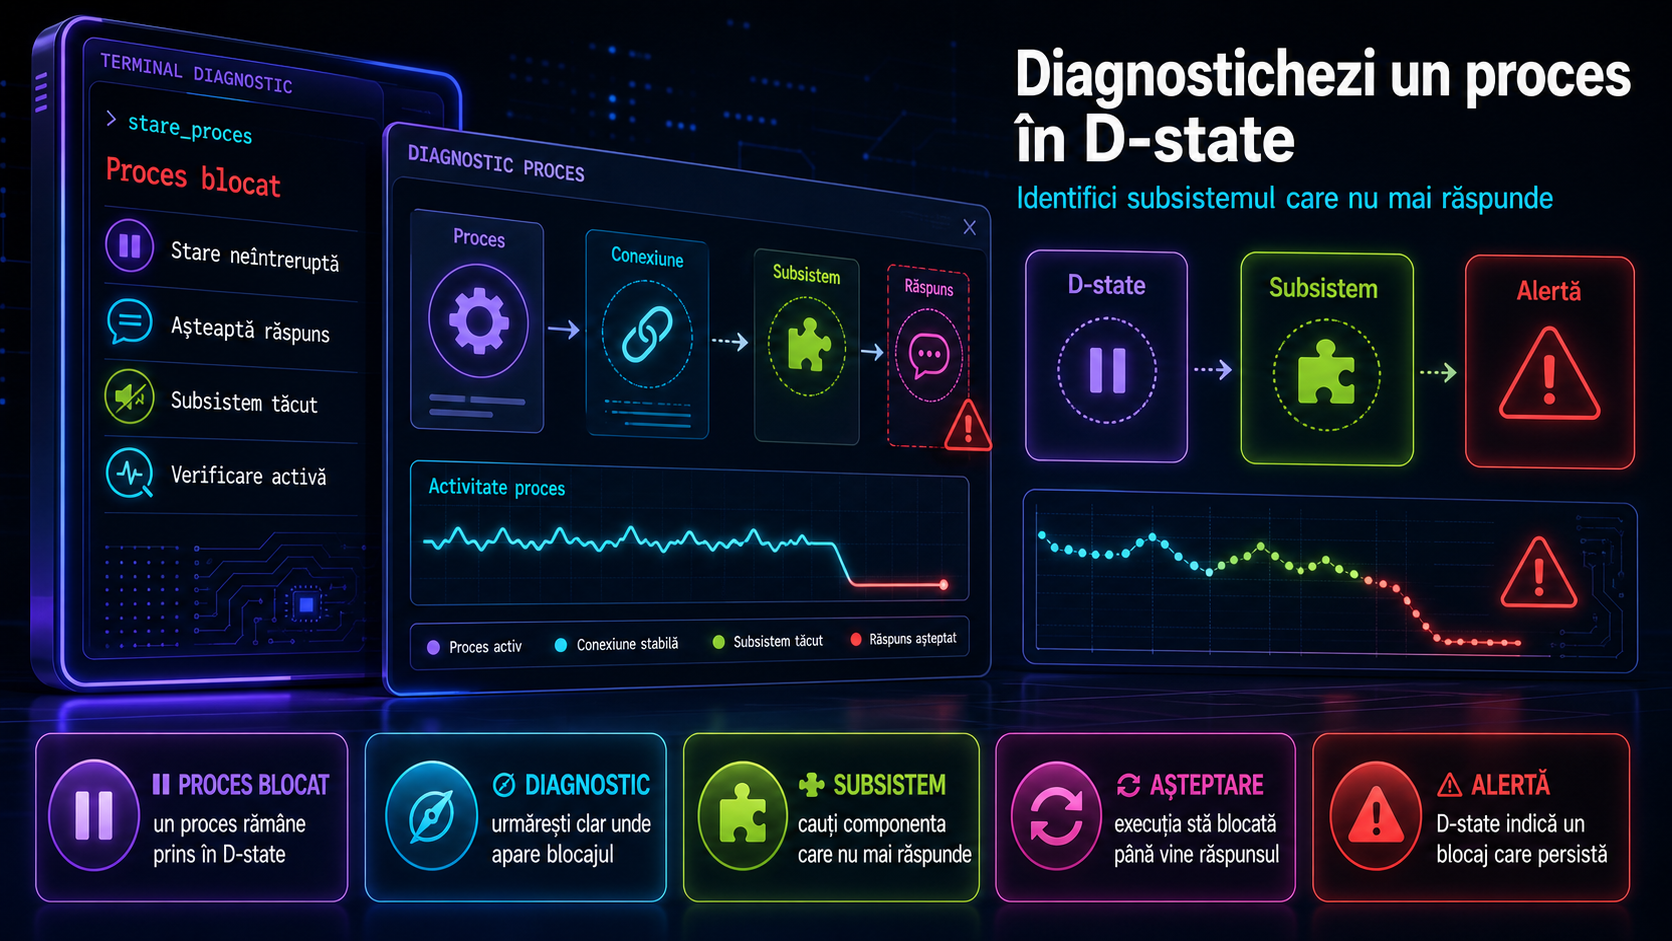
Când un proces apare în Linux cu starea D, vorbim de obicei despre un task aflat în uninterruptible sleep, adică a intrat într-o așteptare în kernel din care nu poate ieși imediat la semnale obișnuite. Documentația pentru /proc/[pid]/stat descrie litera D ca „waiting in uninterruptible disk sleep”, dar în practică problema nu înseamnă doar „disc stricat”. Poate indica blocaje sau întârzieri serioase într-un subsistem de I/O: stocare locală, NFS, iSCSI, USB, device mapper, filesystem, drivere sau alte căi prin care kernelul așteaptă un răspuns.
Simptomul clasic este simplu: aplicația pare înghețată, nu mai răspunde, iar comenzi ca ps sau top o arată cu STAT=D. Uneori vezi și un load average mare, deși procesorul nu este ocupat intens. Alteori apar întârzieri la ls, df, mount, journalctl sau la oprirea serviciilor. Dacă sistemul are activată detectarea de hung tasks, kernelul poate raporta avertismente după intervalul controlat de /proc/sys/kernel/hung_task_timeout_secs.
Primul lucru important este să înțelegi limita principală: un proces în D-state, de regulă, nu poate fi „omorât” nici cu SIGKILL până când apelul din kernel nu revine. Nu este un defect al comenzii kill, ci o consecință a faptului că task-ul așteaptă într-o secțiune neîntreruptibilă. Așadar, investigația corectă nu începe cu forțarea procesului, ci cu identificarea locului unde a rămas blocat.
Ca verificare sigură, poți începe cu:
ps -eo pid,ppid,stat,wchan:32,comm,args
Câmpul wchan este util deoarece arată numele simbolic al locului din kernel unde procesul doarme, informație expusă și prin /proc/[pid]/wchan. Dacă vezi funcții asociate blocului, SCSI, NFS, FUSE, USB sau locking intern, ai deja un indiciu despre subsistemul afectat. Pentru un proces anume, merită verificat și:
cat /proc/PID/stack
Dacă nucleul a fost compilat cu suport pentru stack trace, fișierul /proc/[pid]/stack oferă urma simbolică a apelurilor din kernel și poate arăta mult mai clar dacă blocajul vine din filesystem, rețea de stocare, driver sau dintr-un lock.
Al doilea pas este să corelezi procesul cu resursa folosită. Verifică ce fișiere sau mountpoint-uri ține deschise cu lsof sau fuser, iar dacă procesul aparține unui serviciu systemd, poți vedea ierarhia lui cu systemd-cgls ori statusul unității. Dacă multe procese blocate au în comun același mount NFS, același LUN iSCSI, același disc USB sau aceeași locație de backup, probabil acolo este problema reală.
Al treilea pas este să cauți dovezi în loguri, nu să ghicești. journalctl -k și dmesg pot arăta timeout-uri, resetări de controller, erori I/O, mesaje SCSI, pierderi de conectivitate NFS, probleme de multipath sau mesaje de driver. Aici se diferențiază un articol serios de o „rețetă rapidă”: D-state este simptomul; cauza trebuie confirmată din stack, wchan, loguri și topologia de stocare sau rețea.
Dacă bănuiești un subsistem anume, verificarea trebuie să rămână defensivă. Pentru discuri locale urmărești erori I/O, remount-uri read-only, timeout-uri NVMe/SATA/SCSI sau mesaje de filesystem. Pentru NFS te uiți la latență, mount-uri nefuncționale și mesaje din clientul kernel. Pentru iSCSI sau SAN verifici sesiunea, căile multipath și eventuala pierdere a storage-ului din spate. Pentru USB sau drivere externe, urmărești reconectări, resetări și erori de magistrală. Pentru blocaje interne, stack-ul din kernel și mesajele hung task sunt adesea mai valoroase decât orice tentativă de restart agresiv.
În situații severe, documentația kernel recomandă și instrumente de debugging precum Magic SysRq pentru dump-uri de task-uri, dacă sistemul încă răspunde suficient și ai acces administrativ. Totuși, acesta trebuie folosit cu atenție și doar ca metodă de diagnostic, nu ca reflex automat. Pe sisteme de producție, decizia de a remonta, deconecta storage-ul sau reporni serverul trebuie luată controlat, după colectarea minimă a dovezilor.
Pe scurt, un proces în D-state nu este „o aplicație care nu vrea să moară”, ci de obicei un simptom că un subsistem de kernel sau de I/O nu mai răspunde la timp. Diagnosticul sigur înseamnă să confirmi starea cu ps, să citești wchan și /proc/PID/stack, să corelezi procesul cu resursa folosită și să verifici logurile kernelului. Abia după ce știi dacă problema ține de disc, NFS, iSCSI, USB, driver sau locking intern poți alege remedierea potrivită. Fără această corelare, riști să tratezi doar efectul, nu cauza.