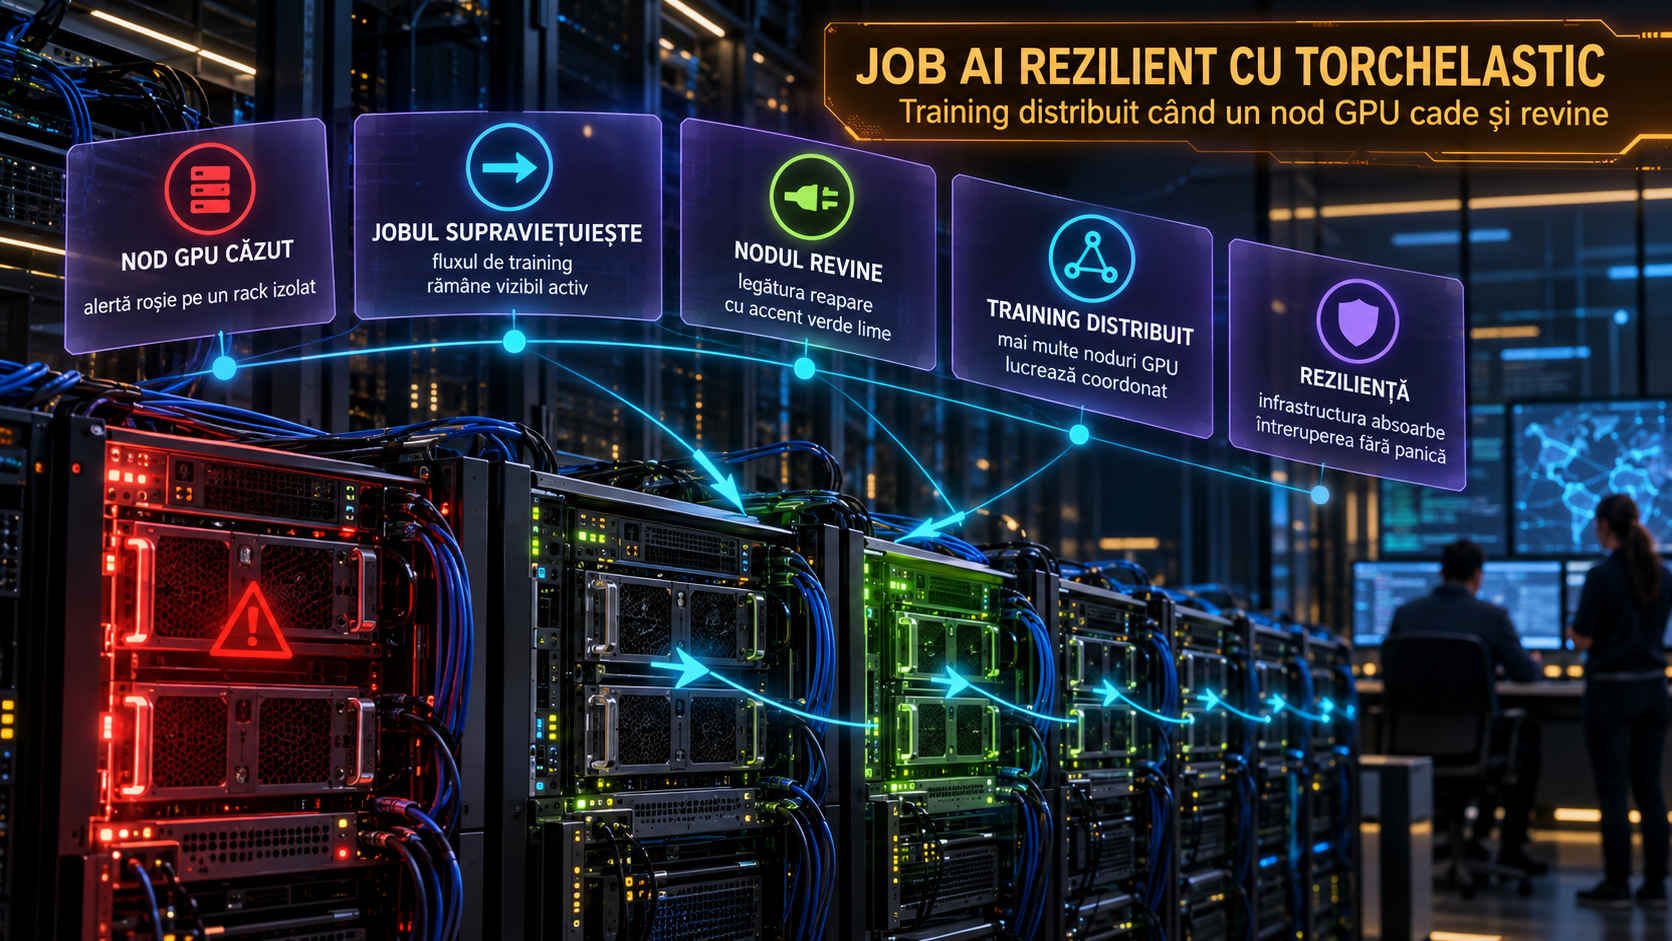
TorchElastic este una dintre acele tehnologii care nu par spectaculoase până în momentul în care ai nevoie de ele. În trainingul distribuit, un model AI este antrenat pe mai multe procese, de obicei pe mai multe GPU-uri și uneori pe mai multe noduri. Întrebarea practică este simplă: ce se întâmplă dacă un nod GPU cade în timpul jobului, apoi revine ulterior?
De ce contează elasticitatea
Fără un mecanism elastic, un astfel de incident poate opri complet antrenarea. Într-un mediu real, cauza poate fi banală: restart al mașinii, întrerupere de rețea, problemă de driver, preempțiune în cloud sau un container care moare. TorchElastic, folosit prin torchrun, nu promite magie și nu salvează automat starea modelului în locul tău, dar oferă un cadru prin care workerii pot fi opriți și reporniți coordonat.
Conceptul central este WorkerGroup-ul. Când pornești un job elastic cu torchrun, acesta lansează un grup de workeri care participă la training. Fiecare worker primește informațiile necesare pentru torch.distributed.init_process_group(), astfel încât procesele să știe cine face parte din job, ce rank au și care este dimensiunea totală a lumii distribuite, WORLD_SIZE.
Cum arată pornirea unui job elastic
În documentația PyTorch, un exemplu elastic folosește o comandă de tipul:
torchrun –nnodes=1:4 –nproc-per-node=$NUM_TRAINERS –max-restarts=3 –rdzv-id=$JOB_ID –rdzv-backend=c10d –rdzv-endpoint=$HOST_NODE_ADDR script.py
Partea importantă este –nnodes=1:4. Asta spune că jobul poate funcționa cu minimum un nod și maximum patru noduri. –max-restarts=3 stabilește de câte ori poate fi repornit grupul de workeri înainte ca jobul să fie considerat eșuat. Parametrii de rendezvous, precum backend, endpoint, run_id, min_nodes și max_nodes, sunt folosiți pentru coordonarea admiterii nodurilor în job.
Ce se întâmplă când un nod cade
Când un worker eșuează, comportamentul documentat este intenționat strict: TorchElastic oprește toți workerii din grup și îi repornește, atât timp cât limita max_restarts permite acest lucru. De ce nu îl repornește doar pe cel căzut? Pentru că într-un job distribuit, workerii depind unii de alții. Dacă un proces dispare, ceilalți pot rămâne blocați în operații colective sau pot avea o imagine inconsistentă asupra grupului.
Aceeași logică se aplică și când se schimbă membership-ul. Dacă un nod pleacă, este tratat ca o schimbare de grup. Dacă un nod revine sau se adaugă unul nou, jobul nu continuă pur și simplu cu vechile valori. Workerii existenți sunt opriți, se formează un nou WorkerGroup, apoi toți workerii sunt porniți cu RANK și WORLD_SIZE noi. Pentru codul tău, regula este importantă: nu presupune că rank-ul sau world size-ul rămân constante pe toată durata jobului.
Rolul Elastic Agent și rendezvous
Elastic Agent este componenta care monitorizează workerii. Dacă observă un failure sau un worker nesănătos, oprește grupul și îl repornește. Dacă observă schimbări de membership, reacționează prin aceeași logică: reconstruirea grupului. În cazul unui agent failure sau node failure, documentația PyTorch precizează că situațiile sunt tratate similar, iar managerul de job decide dacă întregul job eșuează sau dacă nodul este înlocuit.
Rendezvous este partea care ajută nodurile să se întâlnească și să intre corect în același job. Nu este doar un detaliu de configurare, ci mecanismul care permite unui job elastic să știe câte noduri are voie să accepte și sub ce identitate rulează.
Ce trebuie pregătit în cod
Ca trainingul să supraviețuiască, ai nevoie de checkpointing corect. TorchElastic poate reporni procesele, dar dacă scriptul nu salvează periodic modelul, optimizerul, schedulerul și progresul datasetului, vei pierde muncă. Scriptul trebuie tratat ca un proces care poate porni de mai multe ori: citește configurarea la start, reîncarcă ultimul checkpoint valid și reconstruiește obiectele distribuite fără presupuneri fragile.
Loghează clar rank-ul, world size-ul, restarturile și checkpointul încărcat. Aceste informații ajută la debugging și audit operațional. Setează realist max_restarts: o valoare prea mică poate opri joburi recuperabile, iar una prea mare poate ascunde o problemă persistentă de infrastructură.
Lecția pentru echipele AI
Elasticitatea nu înseamnă absența eșecurilor, ci capacitatea de a le gestiona controlat. TorchElastic ajută infrastructura de training să accepte că nodurile pot cădea, pot reveni, iar grupul de lucru se poate schimba. Reușita depinde însă de combinația dintre elasticitate, checkpointing, monitorizare și proceduri clare de reluare.