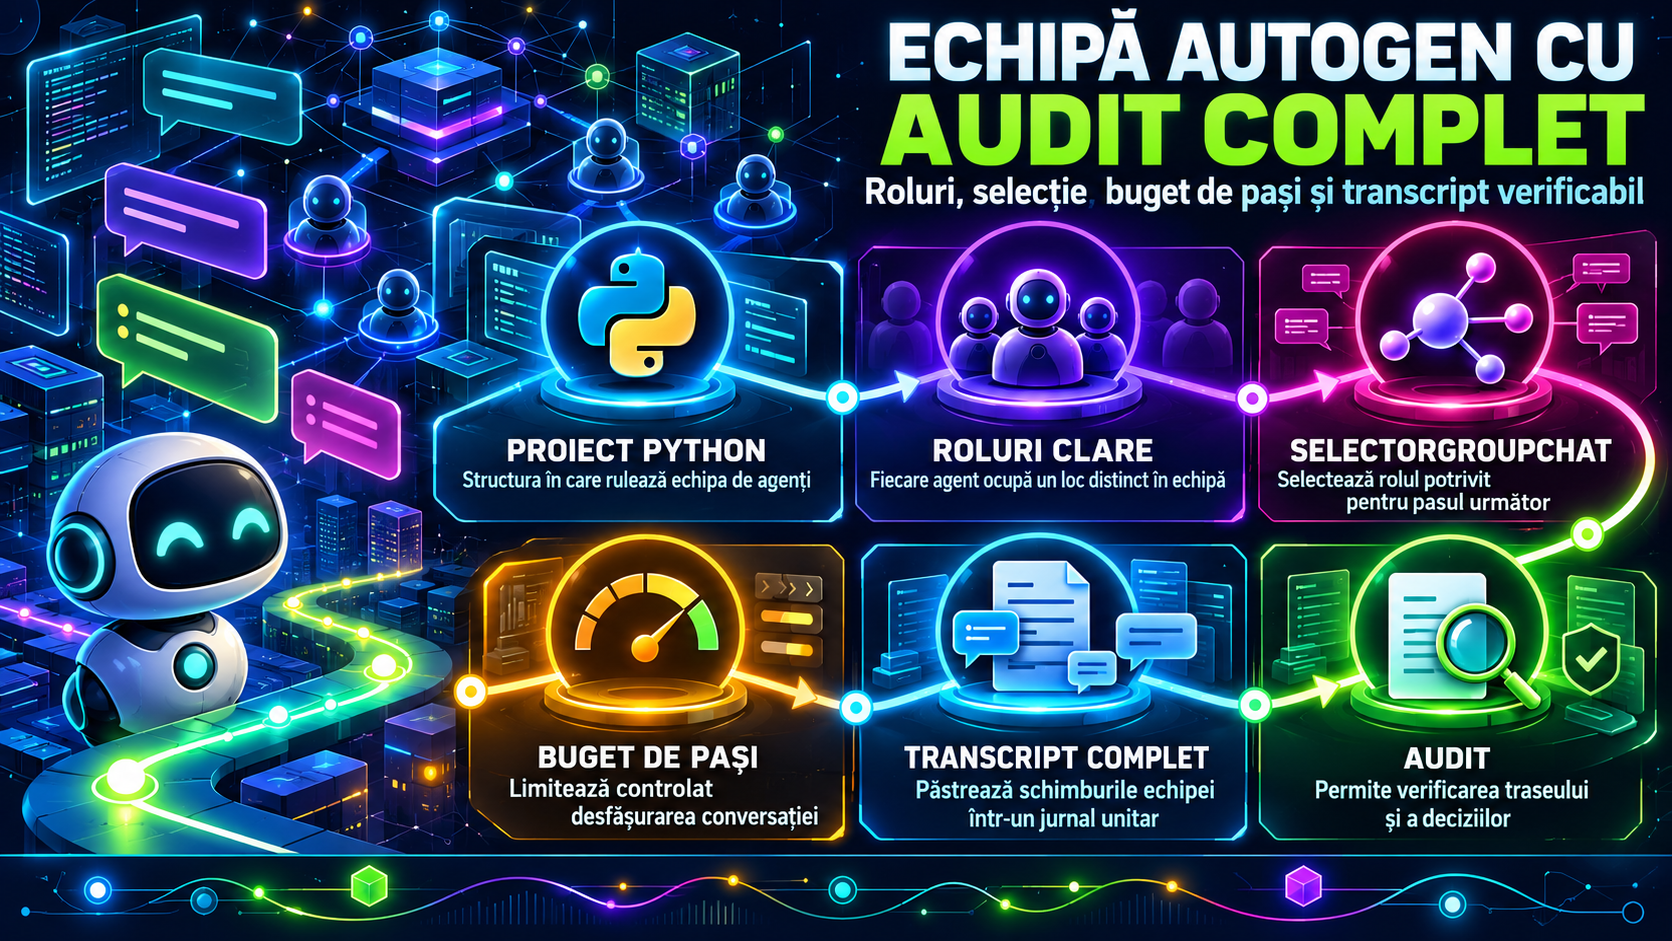
Un tichet intern ajunge la patru roluri AI, dar execuția nu are voie să continue la nesfârșit și nicio decizie nu trebuie să dispară într-un log informal. La finalul proiectului vom avea o echipă SelectorGroupChat cu traseu determinist — triaj, verificarea politicii, rezolvare și audit — limitată la cinci mesaje, inclusiv cererea inițială.
Fiecare rulare produce un transcript JSONL complet în artifacts/, cu mesajele în ordinea originală și un lanț SHA-256 care permite detectarea modificărilor ulterioare. Un set local de patru cazuri verifică întregul flux și îl compară cu un baseline simplu de rutare.
Pentru ca rezultatele să poată fi reproduse fără chei API, costuri sau variații între răspunsurile unui serviciu extern, proiectul folosește ReplayChatCompletionClient, clientul de test oficial din extensiile AutoGen. Acesta redă răspunsuri prestabilite prin aceeași interfață folosită de clienții reali. Evaluarea măsoară aici orchestrarea, respectarea bugetului și integritatea transcriptului, nu inteligența sau calitatea generală a unui LLM.
Rezultatul observabil: patru roluri, cinci mesaje și o urmă verificabilă
Scenariul este cel al unei echipe interne care procesează tichete operaționale. triage_agent identifică ruta și severitatea, policy_agent stabilește acțiunea permisă, resolver_agent redactează rezolvarea, iar audit_agent confirmă că toate câmpurile obligatorii există.
Selecția următorului rol este implementată prin selector_func, nu lăsată unui model probabilistic. Bugetul este impus separat de MaxMessageTermination(max_messages=5): mesajul utilizatorului plus câte un mesaj de la fiecare dintre cele patru roluri.
Aceste două controale rezolvă probleme diferite. Selectorul stabilește ordinea participanților; condiția de terminare stabilește limita dură. Abordarea completează măsurile descrise în ghidul despre limitarea Excessive Agency în agenții autonomi: rolurile sunt separate, iar execuția nu poate consuma un număr necontrolat de pași.
Transcriptul rezultat conține:
- poziția fiecărui mesaj;
- tipul și sursa mesajului;
- conținutul integral;
- hash-ul înregistrării precedente;
- hash-ul SHA-256 al înregistrării curente;
- motivul raportat de echipă pentru oprire.
Lanțul de hash-uri nu semnează digital fișierul și nu dovedește cine l-a creat. El detectează însă ștergerea, reordonarea sau modificarea înregistrărilor, dacă valoarea finală de referință este păstrată separat.
Platforma fixată pentru rulări identice
Tutorialul folosește Ubuntu Server 24.04 LTS, Python 3.12 și AutoGen AgentChat 0.7.5. Sunt suficiente două nuclee CPU, 2 GB RAM și aproximativ 250 MB liberi. Nu este necesar un GPU, deoarece clientul replay nu rulează inferență. Instalarea și testele durează, de regulă, sub 30 de minute pe o mașină care are deja Python.
Verifică mediul înainte de a crea proiectul:
cat /etc/os-release
python3 --version
python3 -m venv --help >/dev/null
free -h
df -h .
Un exemplu de rezultat compatibil este:
PRETTY_NAME="Ubuntu 24.04.x LTS"
Python 3.12.x
Mem: total cel puțin 2.0Gi
Avail pe discul curent: cel puțin 250M
Sufixele versiunii Ubuntu, valorile memoriei și spațiul disponibil vor diferi. Cerința relevantă este seria Ubuntu 24.04, Python 3.12 și existența modulului venv.
Proiectul utilizează un corpus local de evaluare, cases.jsonl, creat integral mai jos. Are patru înregistrări și nu conține date personale, conversații reale sau material preluat dintr-un dataset extern. Nu este un set de antrenare și nu pretinde o licență terță: rolul său este să fixeze intrările, răspunsurile replay și rezultatele așteptate pentru testarea orchestrării.
Instalăm numai componentele necesare pentru AgentChat și teste
Creează directorul, mediul virtual și fișierul cu dependențe fixate:
mkdir -p ~/autogen-audit-team
cd ~/autogen-audit-team
python3 -m venv .venv
source .venv/bin/activate
cat > requirements.txt <<'EOF'
autogen-agentchat==0.7.5
autogen-ext==0.7.5
pytest==8.4.1
EOF
python -m pip install --upgrade pip
python -m pip install -r requirements.txt
python -m pip check
python -c "import autogen_agentchat; print(autogen_agentchat.__version__)"
autogen-agentchat furnizează agenții, echipa și condiția de terminare. autogen-ext include ReplayChatCompletionClient. pytest rulează testele automate. Nu instalăm integrarea OpenAI și nu avem nevoie de OPENAI_API_KEY.
Output-ul relevant trebuie să includă:
No broken requirements found.
0.7.5
Mesajele emise de pip, platformele roților și viteza descărcării pot fi diferite.
Fișierele separă datele, orchestrarea, evaluarea și testele
Structura finală va fi:
autogen-audit-team/
├── requirements.txt          # versiunile directe fixate
├── data/
│   └── cases.jsonl           # cazurile și răspunsurile replay
├── src/
│   ├── __init__.py           # transformă src într-un pachet Python
│   ├── audit_team.py         # echipa, selectorul și transcriptul
│   └── evaluate.py           # baseline și evaluarea celor patru cazuri
├── tests/
│   └── test_pipeline.py      # teste pentru buget, ordine și hash-uri
└── artifacts/                # transcripturi generate la rulare
Datele nu includ secrete. Directorul artifacts/ este creat automat și conține mesajele complete, deci într-o implementare cu tichete reale ar trebui protejat prin permisiuni, retenție limitată și control de acces.
Pasul 1 — Fixăm cele patru cazuri și răspunsurile redate
De ce: același input și aceleași completări replay elimină variația modelului. Câmpurile expected_route și expected_severity sunt folosite de teste, iar lista replies este consumată în ordine de agenți.
Creează fișierul data/cases.jsonl integral:
mkdir -p data src tests artifacts
cat > data/cases.jsonl <<'EOF'
{"id":"INC-001","task":"Nu mă pot autentifica după schimbarea telefonului de serviciu.","expected_route":"identity","expected_severity":"medium","replies":["{"route":"identity","severity":"medium"}","{"allowed_action":"verify_identity_and_reset_mfa","approval_required":true}","{"resolution":"Verifică identitatea prin procedura internă și inițiază resetarea MFA numai după aprobare."}","AUDIT_OK"]}
{"id":"INC-002","task":"Factura lunară apare de două ori în portalul companiei.","expected_route":"finance","expected_severity":"low","replies":["{"route":"finance","severity":"low"}","{"allowed_action":"open_billing_review","approval_required":false}","{"resolution":"Deschide o verificare de facturare și păstrează ambele identificatoare ale documentelor."}","AUDIT_OK"]}
{"id":"INC-003","task":"Un client solicită exportul datelor asociate contului său.","expected_route":"privacy","expected_severity":"medium","replies":["{"route":"privacy","severity":"medium"}","{"allowed_action":"forward_to_privacy_workflow","approval_required":true}","{"resolution":"Înregistrează solicitarea în fluxul de confidențialitate și nu exporta date înaintea verificării identității."}","AUDIT_OK"]}
{"id":"INC-004","task":"Serviciul public răspunde cu HTTP 503 pentru utilizatorii autentificați.","expected_route":"reliability","expected_severity":"high","replies":["{"route":"reliability","severity":"high"}","{"allowed_action":"collect_health_evidence_and_escalate","approval_required":false}","{"resolution":"Colectează verificările de sănătate și identificatorii cererilor, apoi escaladează către echipa de fiabilitate."}","AUDIT_OK"]}
EOF
wc -l data/cases.jsonl
cat <<'EOF' păstrează conținutul exact, fără expandarea caracterelor de către shell. Fiecare linie este un document JSON independent, format potrivit pentru citire incrementală.
Trebuie să vezi:
4 data/cases.jsonlPunct de control: dacă rezultatul nu este 4, verifică dacă delimitatorul final EOF se află singur pe linie și recreează fișierul.
Pasul 2 — Construim SelectorGroupChat și alegem următorul rol din istoric
De ce: o descriere de rol nu garantează ordinea conversației. Funcția select_next_speaker inspectează sursele deja prezente și returnează explicit singurul rol admis în etapa următoare.
Creează mai întâi fișierul gol src/__init__.py:
: > src/__init__.pyApoi creează integral src/audit_team.py:
from __future__ import annotations

import argparse
import asyncio
import hashlib
import json
from pathlib import Path
from typing import Any

from autogen_agentchat.agents import AssistantAgent
from autogen_agentchat.base import TaskResult
from autogen_agentchat.conditions import MaxMessageTermination
from autogen_agentchat.teams import SelectorGroupChat
from autogen_ext.models.replay import ReplayChatCompletionClient

ROOT = Path(__file__).resolve().parents[1]
DATA_FILE = ROOT / "data" / "cases.jsonl"
ARTIFACTS_DIR = ROOT / "artifacts"
AGENT_ORDER = (
    "triage_agent",
    "policy_agent",
    "resolver_agent",
    "audit_agent",
)


def load_cases(path: Path = DATA_FILE) -> list[dict[str, Any]]:
    if not path.exists():
        raise FileNotFoundError(f"Fișierul de cazuri lipsește: {path}")

    cases: list[dict[str, Any]] = []
    with path.open("r", encoding="utf-8") as handle:
        for line_number, line in enumerate(handle, start=1):
            if not line.strip():
                continue
            try:
                case = json.loads(line)
            except json.JSONDecodeError as exc:
                raise ValueError(
                    f"JSON invalid la linia {line_number}: {exc.msg}"
                ) from exc

            required = {
                "id",
                "task",
                "expected_route",
                "expected_severity",
                "replies",
            }
            missing = required.difference(case)
            if missing:
                raise ValueError(
                    f"Cazul de la linia {line_number} nu are: {sorted(missing)}"
                )
            if len(case["replies"]) != 4:
                raise ValueError(
                    f"{case['id']} trebuie să conțină exact patru replies"
                )
            cases.append(case)

    if not cases:
        raise ValueError("Fișierul de cazuri nu conține înregistrări")
    return cases


def find_case(case_id: str) -> dict[str, Any]:
    for case in load_cases():
        if case["id"] == case_id:
            return case
    raise ValueError(f"ID necunoscut: {case_id}")


def select_next_speaker(messages: list[Any]) -> str:
    sources = {
        getattr(message, "source", "")
        for message in messages
    }
    for agent_name in AGENT_ORDER:
        if agent_name not in sources:
            return agent_name
    return "audit_agent"


def build_team(case: dict[str, Any]) -> tuple[SelectorGroupChat, ReplayChatCompletionClient]:
    model_client = ReplayChatCompletionClient(
        chat_completions=case["replies"]
    )

    triage_agent = AssistantAgent(
        name="triage_agent",
        description="Clasifică ruta și severitatea tichetului.",
        model_client=model_client,
        system_message=(
            "Returnează numai JSON cu cheile route și severity. "
            "Nu propune acțiuni."
        ),
    )
    policy_agent = AssistantAgent(
        name="policy_agent",
        description="Stabilește acțiunea permisă și aprobarea necesară.",
        model_client=model_client,
        system_message=(
            "Returnează numai JSON cu allowed_action și approval_required. "
            "Nu executa acțiunea."
        ),
    )
    resolver_agent = AssistantAgent(
        name="resolver_agent",
        description="Formulează rezolvarea defensivă pentru operator.",
        model_client=model_client,
        system_message=(
            "Returnează numai JSON cu cheia resolution. "
            "Nu pretinde că o acțiune a fost deja executată."
        ),
    )
    audit_agent = AssistantAgent(
        name="audit_agent",
        description="Confirmă completitudinea traseului.",
        model_client=model_client,
        system_message=(
            "Răspunde AUDIT_OK numai dacă triajul, politica și rezolvarea "
            "sunt prezente."
        ),
    )

    termination = MaxMessageTermination(max_messages=5)
    team = SelectorGroupChat(
        participants=[
            triage_agent,
            policy_agent,
            resolver_agent,
            audit_agent,
        ],
        model_client=model_client,
        selector_func=select_next_speaker,
        termination_condition=termination,
        allow_repeated_speaker=False,
    )
    return team, model_client


def canonical_json(value: dict[str, Any]) -> str:
    return json.dumps(
        value,
        ensure_ascii=False,
        sort_keys=True,
        separators=(",", ":"),
    )


def write_transcript(
    case_id: str,
    result: TaskResult,
    output_path: Path,
) -> str:
    output_path.parent.mkdir(parents=True, exist_ok=True)
    previous_hash = "0" * 64

    with output_path.open("w", encoding="utf-8", newline="n") as handle:
        for sequence, message in enumerate(result.messages):
            payload = (
                message.model_dump(mode="json")
                if hasattr(message, "model_dump")
                else {"content": str(message)}
            )
            record = {
                "case_id": case_id,
                "sequence": sequence,
                "message": payload,
                "previous_hash": previous_hash,
            }
            current_hash = hashlib.sha256(
                canonical_json(record).encode("utf-8")
            ).hexdigest()
            record["hash"] = current_hash
            handle.write(canonical_json(record) + "n")
            previous_hash = current_hash

        summary = {
            "case_id": case_id,
            "sequence": len(result.messages),
            "stop_reason": result.stop_reason,
            "previous_hash": previous_hash,
        }
        final_hash = hashlib.sha256(
            canonical_json(summary).encode("utf-8")
        ).hexdigest()
        summary["hash"] = final_hash
        summary["record_type"] = "run_summary"
        handle.write(canonical_json(summary) + "n")

    return final_hash


async def run_case(
    case: dict[str, Any],
    output_path: Path | None = None,
) -> tuple[TaskResult, str]:
    team, model_client = build_team(case)
    try:
        result = await team.run(task=case["task"])
    finally:
        await model_client.close()

    destination = output_path or (
        ARTIFACTS_DIR / f"{case['id']}.jsonl"
    )
    final_hash = write_transcript(case["id"], result, destination)
    return result, final_hash


def message_text(message: Any) -> str:
    content = getattr(message, "content", "")
    return content if isinstance(content, str) else str(content)


async def async_main(case_id: str) -> int:
    case = find_case(case_id)
    result, final_hash = await run_case(case)
    verdict = message_text(result.messages[-1])
    print(
        f"case={case_id} messages={len(result.messages)} "
        f"verdict={verdict}"
    )
    print(f"transcript=artifacts/{case_id}.jsonl")
    print(f"final_hash={final_hash}")
    return 0


def main() -> int:
    parser = argparse.ArgumentParser(
        description="Rulează echipa AutoGen auditabilă."
    )
    parser.add_argument(
        "--case-id",
        default="INC-004",
        help="ID existent în data/cases.jsonl",
    )
    args = parser.parse_args()
    try:
        return asyncio.run(async_main(args.case_id))
    except (FileNotFoundError, ValueError) as exc:
        parser.error(str(exc))
    return 2


if __name__ == "__main__":
    raise SystemExit(main())
ReplayChatCompletionClient consumă lista chat_completions în ordine. Toți agenții folosesc aceeași instanță, astfel încât cele patru răspunsuri corespund celor patru intervenții.
allow_repeated_speaker=False împiedică selectarea consecutivă a aceluiași participant. Limita efectivă rămâne MaxMessageTermination: chiar dacă selectorul ar conține o eroare, echipa nu poate depăși cinci mesaje în această rulare.
Verifică importurile fără a executa încă echipa:
python -m py_compile src/audit_team.pyOutput-ul așteptat este gol:
Punct de control: dacă apare SyntaxError, verifică fișierul indicat și numărul liniei; nu continua până când py_compile se încheie cu codul zero.
Pasul 3 — Rulăm un tichet și inspectăm transcriptul complet
De ce: cazul INC-004 arată că oprirea rezultă din buget, nu dintr-un cuvânt special ascuns într-un prompt. Tot aici confirmăm că auditul este ultimul rol și că artefactul este scris.
Rulează:
python -m src.audit_team --case-id INC-004
wc -l artifacts/INC-004.jsonl
python -m json.tool artifacts/INC-004.jsonl >/dev/null
Ultima comandă va eșua deoarece JSONL conține mai multe documente JSON, iar json.tool așteaptă un singur document. Verificarea corectă pentru JSONL este:
python - <<'PY'
import json
from pathlib import Path

path = Path("artifacts/INC-004.jsonl")
records = [
    json.loads(line)
    for line in path.read_text(encoding="utf-8").splitlines()
]
print(f"records={len(records)}")
print(f"last_type={records[-1]['record_type']}")
PY
Trebuie să vezi un rezultat de această formă:
case=INC-004 messages=5 verdict=AUDIT_OK
transcript=artifacts/INC-004.jsonl
final_hash=<64 de caractere hexazecimale>
6 artifacts/INC-004.jsonl
records=6
last_type=run_summary
Hash-ul diferă dacă se schimbă conținutul, versiunea de serializare sau ordinea câmpurilor interne ale mesajelor. În mediul fixat și cu fișierele neschimbate, două rulări trebuie să producă același hash.
Punct de control: dacă apar mai mult sau mai puțin de cinci mesaje, inspectează câmpurile source din transcript și confirmă versiunea autogen-agentchat.
Pasul 4 — Verificăm fiecare verigă a lanțului SHA-256
De ce: simpla prezență a unui câmp numit hash nu dovedește integritatea. Evaluatorul trebuie să recalculeze fiecare valoare din datele salvate și să confirme legătura cu înregistrarea precedentă.
Creează integral src/evaluate.py:
from __future__ import annotations

import argparse
import asyncio
import hashlib
import json
from pathlib import Path
from typing import Any

from src.audit_team import (
    ARTIFACTS_DIR,
    canonical_json,
    load_cases,
    message_text,
    run_case,
)


def baseline_route(task: str) -> str:
    lowered = task.casefold()
    if "factur" in lowered:
        return "finance"
    if "cont" in lowered:
        return "identity"
    if "export" in lowered:
        return "privacy"
    return "operations"


def parse_first_reply(result: Any) -> dict[str, Any]:
    if len(result.messages) < 2:
        raise ValueError("Lipsește răspunsul agentului de triaj")
    try:
        return json.loads(message_text(result.messages[1]))
    except json.JSONDecodeError as exc:
        raise ValueError("Triajul nu a produs JSON valid") from exc


def verify_transcript(path: Path) -> tuple[bool, int]:
    records = [
        json.loads(line)
        for line in path.read_text(encoding="utf-8").splitlines()
        if line.strip()
    ]
    if not records:
        return False, 0

    previous_hash = "0" * 64
    for record in records:
        stored_hash = record.pop("hash", None)
        if record.get("previous_hash") != previous_hash:
            return False, len(records)

        expected_hash = hashlib.sha256(
            canonical_json(record).encode("utf-8")
        ).hexdigest()
        if stored_hash != expected_hash:
            return False, len(records)
        previous_hash = stored_hash

    return True, len(records)


async def evaluate() -> int:
    cases = load_cases()
    baseline_correct = 0
    team_correct = 0
    audit_ok = 0
    budget_ok = 0
    integrity_ok = 0

    for case in cases:
        if baseline_route(case["task"]) == case["expected_route"]:
            baseline_correct += 1

        output_path = ARTIFACTS_DIR / f"{case['id']}.jsonl"
        result, _ = await run_case(case, output_path)
        triage = parse_first_reply(result)

        if (
            triage.get("route") == case["expected_route"]
            and triage.get("severity") == case["expected_severity"]
        ):
            team_correct += 1
        if message_text(result.messages[-1]) == "AUDIT_OK":
            audit_ok += 1
        if len(result.messages) == 5:
            budget_ok += 1

        valid, record_count = verify_transcript(output_path)
        if valid and record_count == 6:
            integrity_ok += 1

    total = len(cases)
    print("| Variantă | Rutare corectă | Audit OK | Buget respectat | Transcript valid |")
    print("|---|---:|---:|---:|---:|")
    print(
        f"| Baseline cu reguli | {baseline_correct}/{total} | "
        f"0/{total} | {total}/{total} | 0/{total} |"
    )
    print(
        f"| SelectorGroupChat replay | {team_correct}/{total} | "
        f"{audit_ok}/{total} | {budget_ok}/{total} | "
        f"{integrity_ok}/{total} |"
    )

    all_ok = (
        team_correct == total
        and audit_ok == total
        and budget_ok == total
        and integrity_ok == total
    )
    return 0 if all_ok else 1


def main() -> int:
    parser = argparse.ArgumentParser(
        description="Evaluează orchestrarea și transcripturile."
    )
    parser.parse_args()
    return asyncio.run(evaluate())


if __name__ == "__main__":
    raise SystemExit(main())
Evaluatorul recalculează hash-ul după eliminarea valorii stocate. Pentru fiecare rând, previous_hash trebuie să fie hash-ul rândului anterior. Fișierul are cinci mesaje și o înregistrare finală run_summary.
Baseline-ul clasifică doar prin trei fragmente lexicale. El nu produce politică, rezolvare sau audit. Comparația arată beneficiul structural al fluxului, nu superioritatea unui model: răspunsurile echipei sunt fixture-uri replay, nu predicții independente. Pentru evaluarea calității unor raționamente generate de un model real ar fi necesar un protocol separat; un exemplu este evaluarea fiecărui pas cu un Process Reward Model.
Rulează evaluarea:
python -m src.evaluateOutput-ul așteptat este:
| Variantă | Rutare corectă | Audit OK | Buget respectat | Transcript valid |
|---|---:|---:|---:|---:|
| Baseline cu reguli | 2/4 | 0/4 | 4/4 | 0/4 |
| SelectorGroupChat replay | 4/4 | 4/4 | 4/4 | 4/4 |
Punct de control: dacă Transcript valid este sub 4/4, șterge artefactele, rulează din nou și verifică dacă vreun proces modifică fișierele după creare.
Pasul 5 — Automatizăm testele pentru ordine, limită și alterarea logului
De ce: output-ul vizual nu detectează ușor o regresie în selector sau un transcript modificat. Testele verifică traseul complet și demonstrează că schimbarea unui singur caracter invalidează lanțul.
Creează integral tests/test_pipeline.py:
from __future__ import annotations

import asyncio
import json
from pathlib import Path

from src.audit_team import load_cases, run_case
from src.evaluate import parse_first_reply, verify_transcript


def test_all_cases_follow_budget_and_route(tmp_path: Path) -> None:
    async def scenario() -> None:
        for case in load_cases():
            output = tmp_path / f"{case['id']}.jsonl"
            result, final_hash = await run_case(case, output)
            triage = parse_first_reply(result)

            assert len(result.messages) == 5
            assert [message.source for message in result.messages] == [
                "user",
                "triage_agent",
                "policy_agent",
                "resolver_agent",
                "audit_agent",
            ]
            assert triage["route"] == case["expected_route"]
            assert triage["severity"] == case["expected_severity"]
            assert result.messages[-1].content == "AUDIT_OK"
            assert len(final_hash) == 64
            assert verify_transcript(output) == (True, 6)

    asyncio.run(scenario())


def test_modified_record_breaks_hash_chain(tmp_path: Path) -> None:
    async def scenario() -> None:
        case = load_cases()[0]
        output = tmp_path / "tampered.jsonl"
        await run_case(case, output)

        lines = output.read_text(encoding="utf-8").splitlines()
        record = json.loads(lines[1])
        record["message"]["content"] = "CONȚINUT MODIFICAT"
        lines[1] = json.dumps(
            record,
            ensure_ascii=False,
            sort_keys=True,
            separators=(",", ":"),
        )
        output.write_text(
            "n".join(lines) + "n",
            encoding="utf-8",
        )

        valid, count = verify_transcript(output)
        assert count == 6
        assert valid is False

    asyncio.run(scenario())
Primul test confirmă exact ordinea surselor și limita de cinci mesaje. Al doilea modifică deliberat o copie temporară a transcriptului; nu atinge artefactele operaționale.
Rulează suita:
pytest -qTrebuie să vezi:
2 passedDurata și eventualele informații despre platformă pot diferi.
Punct de control: dacă lista surselor nu începe cu user, inspectează result.messages și documentația versiunii instalate înainte de a adapta testul; nu elimina mesajul inițial doar pentru a forța trecerea suitei.
Testul de capăt confirmă aceeași execuție de două ori
Șterge artefactul unui caz, rulează echipa de două ori și compară hash-urile fișierelor:
rm -f artifacts/INC-004.jsonl artifacts/INC-004.first.jsonl
python -m src.audit_team --case-id INC-004
cp artifacts/INC-004.jsonl artifacts/INC-004.first.jsonl
python -m src.audit_team --case-id INC-004
sha256sum artifacts/INC-004.first.jsonl artifacts/INC-004.jsonl
cmp --silent artifacts/INC-004.first.jsonl artifacts/INC-004.jsonl
echo "cmp_exit=$?"
pytest -q
Cele două valori raportate de sha256sum trebuie să fie identice, iar cmp_exit trebuie să fie zero:
<același SHA-256>  artifacts/INC-004.first.jsonl
<același SHA-256>  artifacts/INC-004.jsonl
cmp_exit=0
2 passed
Acesta este testul reproductibilității proiectului. El este posibil tocmai pentru că nu depinde de un model găzduit, de sampling sau de actualizarea tăcută a unui endpoint.
Într-o utilizare cu un model real, temperatura redusă nu garantează identitate byte-cu-byte. Ar trebui păstrate suplimentar numele exact al modelului, configurația clientului, utilizarea de tokeni, versiunea prompturilor și răspunsurile brute. Transcriptul trebuie tratat ca jurnal sensibil, nu ca material public.
Cinci defecțiuni specifice acestei echipe
ValueError: No more chat completions available
Cauza este consumarea mai multor completări decât cele patru elemente din replies. Se întâmplă dacă selectorul repetă un agent sau dacă bugetul a fost mărit fără extinderea fixture-ului.
Confirmă lungimea:
python - <<'PY'
from src.audit_team import load_cases
for case in load_cases():
    print(case["id"], len(case["replies"]))
PY
Rezultatul trebuie să fie patru pentru fiecare caz. Nu mări lista ca să ascunzi o buclă; verifică mai întâi ordinea selectorului.
ValueError: INC-... trebuie să conțină exact patru replies
Validatorul local a găsit un caz incomplet sau cu un răspuns suplimentar. Verifică documentul fără să expui date sensibile:
python - <<'PY'
from src.audit_team import load_cases
load_cases()
print("dataset_ok")
PY
Recreează linia afectată din blocul original dacă fișierul a fost editat accidental.
json.decoder.JSONDecodeError la analiza triajului
Primul răspuns replay nu mai este JSON valid sau nu mai aparține agentului de triaj. Afișează numai cazul de laborator:
python - <<'PY'
from src.audit_team import load_cases
print(load_cases()[0]["replies"][0])
PY
Valoarea trebuie să aibă cheile route și severity, cu ghilimele JSON duble.
Testul raportează o ordine diferită a surselor
Cauza probabilă este modificarea AGENT_ORDER, redenumirea unui agent sau schimbarea lui select_next_speaker. Rulează un caz și citește sursele din artefact:
python -m src.audit_team --case-id INC-001
python - <<'PY'
import json
from pathlib import Path
for line in Path("artifacts/INC-001.jsonl").read_text(encoding="utf-8").splitlines():
    record = json.loads(line)
    if "message" in record:
        print(record["message"].get("source"))
PY
Ordinea acceptată este user, triage_agent, policy_agent, resolver_agent, audit_agent.
verify_transcript întoarce False
Fișierul a fost modificat, trunchiat, reordonat sau rescris cu o serializare diferită. Nu recalcula hash-urile peste un jurnal suspect. Păstrează fișierul pentru analiză și generează separat o rulare nouă:
mv artifacts/INC-004.jsonl artifacts/INC-004.suspect.jsonl
python -m src.audit_team --case-id INC-004
python -m src.evaluate
Un atacator care poate modifica și transcriptul, și hash-ul final păstrat în același loc poate reconstrui lanțul. În producție, hash-ul final trebuie trimis într-un sistem separat, cu acces append-only sau semnare externă.
Curățăm laboratorul fără să păstrăm transcripturi sensibile
Mediul nu instalează servicii de sistem și nu deschide porturi. Pentru eliminarea completă, ieși din mediul virtual și șterge directorul proiectului.
Avertisment: următoarea comandă elimină definitiv codul, mediul virtual și toate transcripturile din acest laborator. Verifică valoarea lui PROJECT înainte de rm -rf.
deactivate 2>/dev/null || true
PROJECT="$HOME/autogen-audit-team"
printf 'Se va șterge: %sn' "$PROJECT"
test "$PROJECT" = "$HOME/autogen-audit-team"
rm -rf -- "$PROJECT"
Dacă vrei să refaci doar rezultatele, fără a șterge codul și mediul:
cd ~/autogen-audit-team
rm -f artifacts/*.jsonl
Nu există fișiere .bak de restaurat deoarece proiectul nu modifică o configurație preexistentă.
Bifele de acceptanță pentru echipa auditabilă
- ☐
python -m pip checknu raportează dependențe incompatibile. - ☐ Corpusul local conține exact patru linii JSONL.
- ☐ Fiecare caz are exact patru completări replay.
- ☐ Sursele mesajelor urmează ordinea
user, triaj, politică, rezolvare, audit. - ☐ Fiecare rulare se oprește la cinci mesaje.
- ☐ Ultimul mesaj este
AUDIT_OK. - ☐ Transcriptul are șase înregistrări, inclusiv
run_summary. - ☐ Două rulări neschimbate produc fișiere identice.
- ☐ Modificarea unui mesaj face verificarea hash-ului să eșueze.
- ☐
pytest -qraportează două teste trecute.
După validarea laboratorului, următorul proiect logic este înlocuirea fixture-urilor cu un client real într-un mediu de test, păstrând aceleași teste de structură și marcând separat evaluările nedeterministe. O a doua extensie este trimiterea hash-ului final într-un jurnal append-only. A treia este adăugarea unui evaluator independent pentru conținut, fără a-i permite să modifice transcriptul pe care îl verifică.
Întrebări frecvente
Acest proiect trimite date către un furnizor AI?
Nu. ReplayChatCompletionClient redă local cele patru răspunsuri definite în fiecare caz și nu necesită cheie API.
De ce limita este de cinci mesaje dacă există patru agenți?
Mesajul inițial al utilizatorului intră în istoricul echipei, urmat de câte un mesaj de la cei patru agenți. MaxMessageTermination(max_messages=5) limitează întregul istoric al rulării.
Hash-ul transcriptului reprezintă o semnătură digitală?
Nu. Lanțul SHA-256 detectează modificările numai dacă valoarea finală de referință este protejată separat; nu autentifică identitatea autorului.
Benchmark-ul demonstrează că echipa este mai inteligentă decât baseline-ul?
Nu. Răspunsurile echipei sunt prestabilite pentru reproductibilitate. Tabelul verifică orchestrarea, completitudinea, bugetul și integritatea jurnalului, nu calitatea generală a unui LLM.