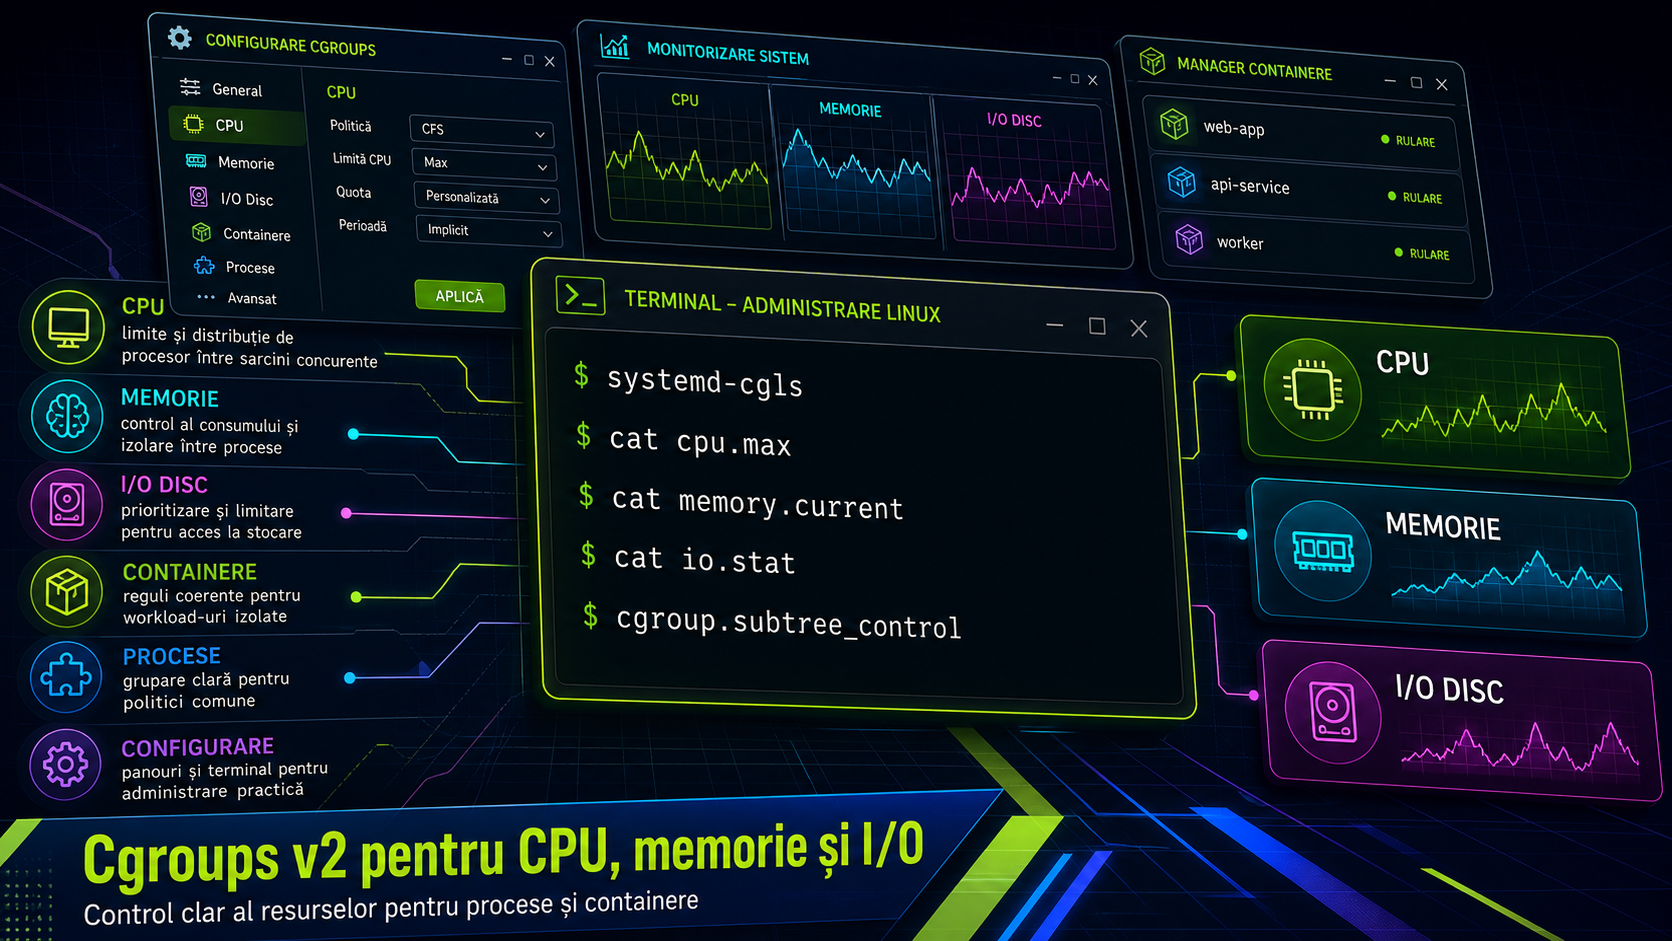
Pe Linux, cgroups v2 este mecanismul standard prin care sistemul poate controla consumul de resurse al unui grup de procese. În practică, asta înseamnă că poți impune limite clare pentru CPU, memorie și I/O, fie pentru un proces local, fie pentru un container pornit cu Docker, Podman sau systemd. Pentru administratori și echipe DevOps, avantajul este simplu: izolezi mai bine workload-urile și reduci riscul ca un serviciu scăpat de sub control să degradeze tot serverul.
În cgroups v2, toate controllerele relevante sunt organizate într-o ierarhie unificată, de regulă sub /sys/fs/cgroup. Aici contează o diferență importantă: nu toate limitele se comportă la fel. Unele sunt relative, adică stabilesc prioritate față de alte grupuri active, iar altele sunt hard, adică impun un plafon clar.
Pentru CPU, cele mai utile fișiere sunt cpu.weight și cpu.max. cpu.weight stabilește cât de mult timp CPU primește un grup în raport cu „frații” lui atunci când există competiție pe procesor. Cu alte cuvinte, nu blochează consumul la o valoare fixă, ci schimbă prioritatea relativă. În schimb, cpu.max impune un plafon efectiv de timp CPU într-o perioadă dată. Documentația kernelului descrie formatul ca „MAX PERIOD”, iar valoarea implicită este „max 100000”, adică fără limită explicită și cu o perioadă de 100 ms. Într-un scenariu practic, un serviciu care nu trebuie să monopolizeze procesorul poate primi un plafon de 50% și o greutate normală sau redusă.
Dacă folosești systemd, nu este nevoie să scrii direct în /sys/fs/cgroup. Echivalentele mai prietenoase sunt CPUWeight= și CPUQuota=. Un exemplu util pentru un proces pornit ad-hoc este:
systemd-run –scope -p CPUQuota=50% -p CPUWeight=200 comanda-ta
Asta creează un scope tranzitoriu și aplică limitele la acel workload. Este o variantă mai sigură și mai ușor de repetat decât modificarea manuală a fișierelor din cgroupfs.
Pentru memorie, cgroups v2 separă foarte clar controlul blând de limita dură. memory.high este pragul de throttling: când grupul îl depășește, procesele sunt puse sub presiune de reclaim și încetinite. Documentația kernelului spune explicit că memory.high este mecanismul principal de control al memoriei și că depășirea lui nu invocă OOM killer-ul. memory.max este plafonul dur: dacă utilizarea ajunge acolo și nu poate fi redusă, kernelul poate declanșa OOM killer în acel cgroup. În termeni practici, memory.high este bun pentru a ține un serviciu în frâu, iar memory.max este plasa de siguranță care împiedică afectarea întregii mașini.
Prin systemd, echivalentele sunt MemoryHigh= și MemoryMax=. Un exemplu realist:
systemd-run –scope -p MemoryHigh=512M -p MemoryMax=1G comanda-ta
Pentru containere, Docker expune același tip de control prin opțiuni precum –memory și –memory-reservation. Docker avertizează și că dezactivarea OOM killer-ului fără o limită de memorie setată este riscantă, pentru că poate afecta procesele gazdei.
La capitolul I/O, cgroups v2 folosește io.weight și io.max. io.weight este relativ: stabilește cât timp de I/O primește un grup față de altele, cu valori între 1 și 10000. io.max este limita efectivă pe dispozitiv, în bytes pe secundă sau IOPS, identificat prin numărul major:minor al device-ului. Aici apare și una dintre cele mai importante nuanțe practice: controlul I/O este legat de dispozitive bloc, iar pe sisteme cu RAID, LVM, overlay sau alte straturi de stocare, efectul poate fi mai greu de intuit decât la CPU sau memorie.
Cu systemd, setările utile sunt IOWeight=, IOReadBandwidthMax= și IOWriteBandwidthMax=. De exemplu:
systemd-run –scope -p IOWeight=200 -p IOReadBandwidthMax=/dev/nvme0n1 20M -p IOWriteBandwidthMax=/dev/nvme0n1 10M comanda-ta
Pentru containere, Podman și Docker oferă opțiuni precum –blkio-weight, iar în Docker există și limitări de bandwidth per device în anumite scenarii. Ideea de bază rămâne aceeași: I/O poate fi prioritizat sau plafonat, dar trebuie să știi exact pe ce device rulează workload-ul.
În practică, cea mai sănătoasă abordare este aceasta: pentru CPU folosești weight când vrei partajare echitabilă și quota când vrei plafon clar; pentru memorie pornești de la memory.high și adaugi memory.max ca limită dură; pentru I/O folosești weight pentru prioritizare și limite de bandwidth doar unde mapping-ul de stocare este clar. Cgroups v2 nu este doar o unealtă pentru containere, ci fundația modernă pentru izolare de resurse pe Linux. Folosit corect, ajută atât la stabilitate, cât și la siguranță operațională.
Surse
- https://docs.kernel.org/admin-guide/cgroup-v2.html
- https://man7.org/linux/man-pages/man7/cgroups.7.html
- https://www.freedesktop.org/software/systemd/man/latest/systemd.resource-control.html
- https://www.freedesktop.org/software/systemd/man/latest/systemd-run.html
- https://docs.docker.com/engine/containers/resource_constraints/
- https://docs.podman.io/en/latest/markdown/podman-run.1.html