Cachingul semantic pentru asistenți AI a intrat tot mai des în discuție pe măsură ce firmele încearcă să reducă costurile fără să sacrifice calitatea răspunsurilor. Ideea pare simplă: dacă doi utilizatori pun întrebări foarte asemănătoare, poate nu are sens să plătești din nou pentru același tip de inferență. În practică, însă, diferența dintre o economie sănătoasă și reutilizarea unui răspuns greșit stă în felul în care proiectezi cache-ul, retrieval-ul și controalele din jurul lor.
Primul lucru important este să nu confundăm cachingul semantic cu prompt cachingul clasic. Documentația OpenAI despre prompt caching explică un mecanism pentru prefixe identice de prompt: dacă ai instrucțiuni stabile și aceeași structură la începutul cererii, acea parte poate fi refolosită mai rapid și mai ieftin. Asta ajută mult la latență și cost, dar funcționează pe potrivire exactă a prefixului. Cachingul semantic merge în altă direcție: încearcă să recunoască întrebări asemănătoare ca sens, chiar dacă nu sunt formulate identic.
Microsoft menționează explicit în ghidul său pentru pattern-ul Cache-Aside că unele workload-uri pot face cache retrieval pe baza sensului semantic, nu doar a cheilor exacte. Beneficiul este clar: mai puține request-uri și mai puțini tokeni trimiși către model. Tot Microsoft pune însă și condiția critică: semantic caching trebuie folosit doar când datele chiar permit echivalență semantică, când nu există risc de a returna răspunsuri fără legătură și când nu introduci date private sau sensibile în cache. Exemplul lor este foarte bun: două întrebări despre salariul anual pot părea similare semantic, dar răspunsul corect diferă de la un utilizator la altul.
Aici apare regula practică pentru asistenții AI: cache-ul semantic este potrivit mai ales pentru întrebări repetitive, generale și bine ancorate în aceeași bază de cunoștințe. De exemplu, politici interne standard, întrebări frecvente despre un produs, explicații despre un proces sau răspunsuri extrase din documentație versionată. Nu este potrivit, în schimb, pentru întrebări personalizate, răspunsuri cu date volatile, decizii cu impact mare sau cereri care depind de identitatea utilizatorului, rol, regiune ori momentul exact al interogării.
Cum reduci riscul de a recicla un răspuns greșit? În primul rând, nu pune cache-ul înaintea grounding-ului. Dacă asistentul răspunde pe baza documentelor firmei, cheia semantică ar trebui legată și de contextul de recuperare: sursa, versiunea documentelor, tenantul, limba și eventual intervalul de valabilitate. Dacă se schimbă baza de cunoștințe, răspunsurile vechi trebuie invalidate. Altfel, cache-ul devine o mașină de amplificat erori vechi, doar că mai ieftin.
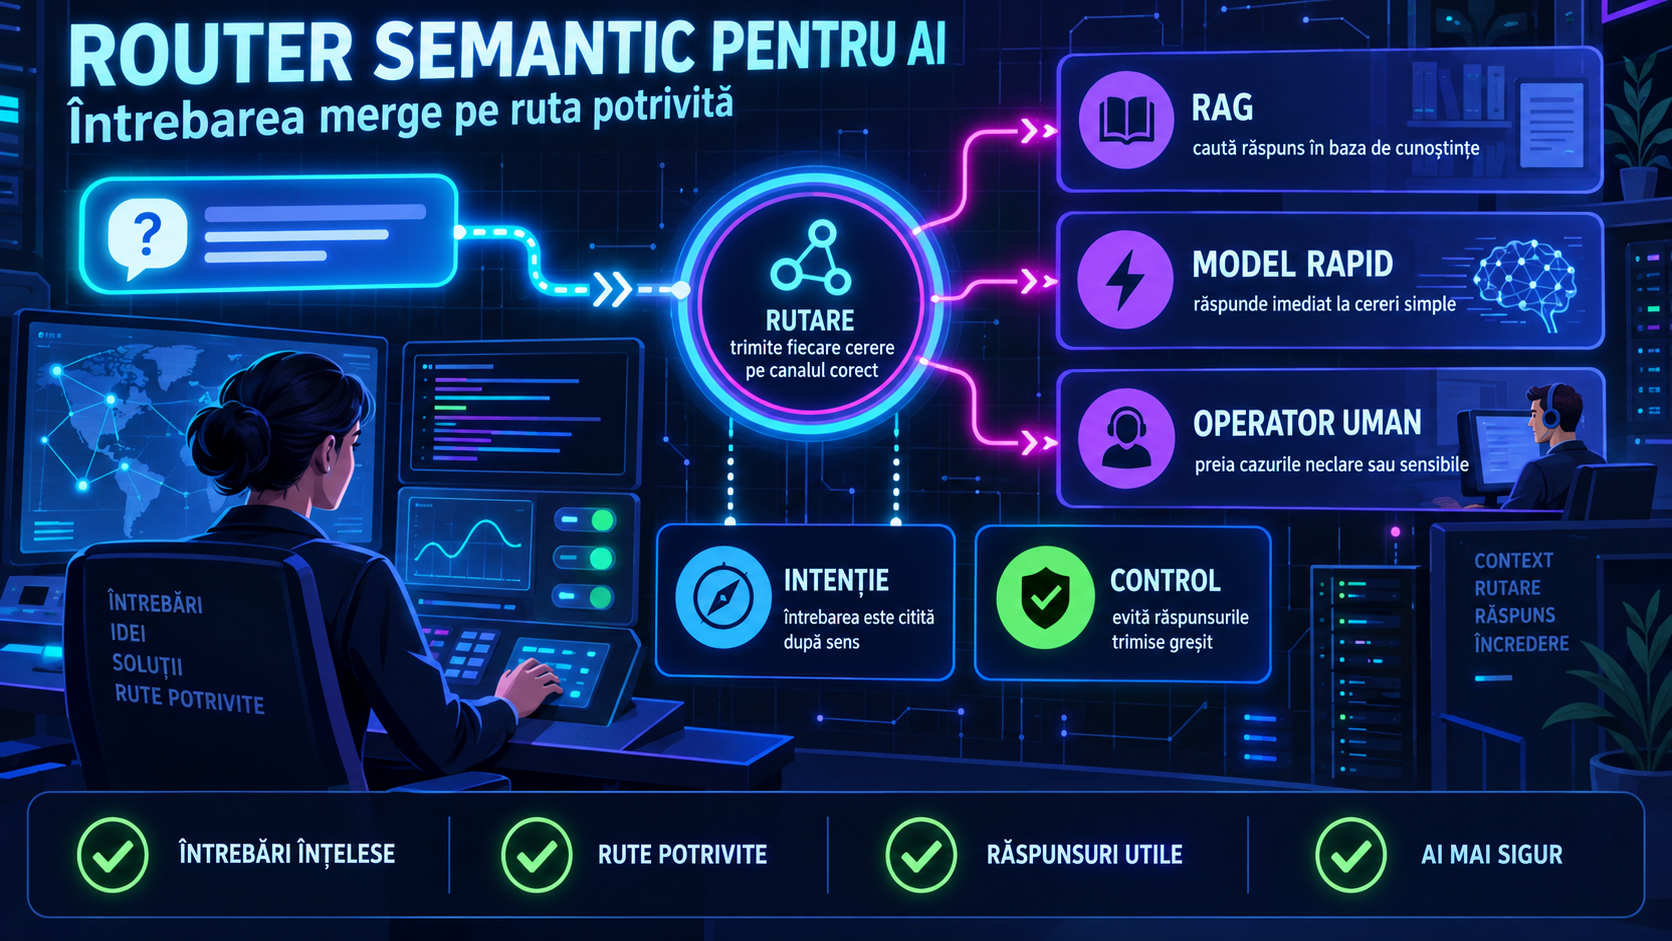
În al doilea rând, merită să tratezi retrieval-ul serios și la cache miss. Ghidul Microsoft pentru RAG subliniază că platformele de search pot combina full-text și vector search, inclusiv în scenarii hibride, iar preprocesarea query-ului trebuie să fie consistentă cu preprocesarea folosită la chunks. Cu alte cuvinte, dacă nu ai hit în cache, nu sari direct la un răspuns liber al modelului. Recuperezi context relevant, îl rerankezi dacă este nevoie și abia apoi generezi răspunsul.
În al treilea rând, răspunsul cache-uit ar trebui să fie unul verificabil, nu doar fluent. Anthropic recomandă tehnici simple și foarte utile pentru reducerea halucinațiilor: modelul să poată spune „nu știu”, să folosească citate directe pentru grounding și să verifice afirmațiile cu citări. Pentru un asistent AI din companie, asta înseamnă că merită să cache-uiești preferențial răspunsuri care includ trimitere la sursă, nu răspunsuri opace. Dacă ulterior nu mai poți explica din ce document a venit informația, ai economisit tokeni, dar ai pierdut auditabilitate.
Mai este un element ignorat des: observabilitatea. Documentația OpenAI Agents SDK descrie tracing-ul prin traces și spans tocmai pentru a putea reconstrui pașii unei execuții: generații LLM, tool calls, erori și fluxul complet al cererii. Într-un proiect cu semantic caching, aceste urme sunt esențiale. Fără ele, nu știi dacă economia vine din hit-uri bune sau din răspunsuri servite greșit prea des. În practică, merită să urmărești separat rata de cache hit, sursele folosite, rata de corecție umană și cazurile în care un răspuns din cache a fost invalidat după verificare.
Concluzia utilă pentru firme este simplă: semantic caching poate reduce costurile, dar numai dacă este tratat ca un strat defensiv, nu ca o scurtătură oarbă. Folosește-l pentru întrebări repetitive și cu echivalență semantică reală, leagă-l de versiunea contextului, evită datele sensibile, păstrează grounding-ul și monitorizează calitatea. Dacă sari peste aceste condiții, nu construiești eficiență, ci doar o metodă mai rapidă de a repeta același răspuns greșit.